Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
Sentence Transformers-ის შესწავლა: ნულიდან პროექტამდე
ეს პოსტი წარმოგიდგენთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის (ST) გამოყენებით ახალი ბიბლიოთეკის დაუფლებისთვის ნულიდან. განვიხილავთ ST-ის ძირითად ფუნქციონალს, მათ შორის წინადადების ვექტორების (embeddings), სემანტიკური ძიებისა და კოსინუსური მსგავსების კონცეფციებს. ხაზგასმულია, თუ რატომ არის ST ღირებული ინსტრუმენტი ხელმისაწვდომობის, სწავლის ეფექტურობისა და მრეწველობაში გამოყენების თვალსაზრისით. სტატია ასევე გვთავაზობს გამოცდილ სტრატეგიას პირველი დამოუკიდებელი პროექტის განსახორციელებლად და

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
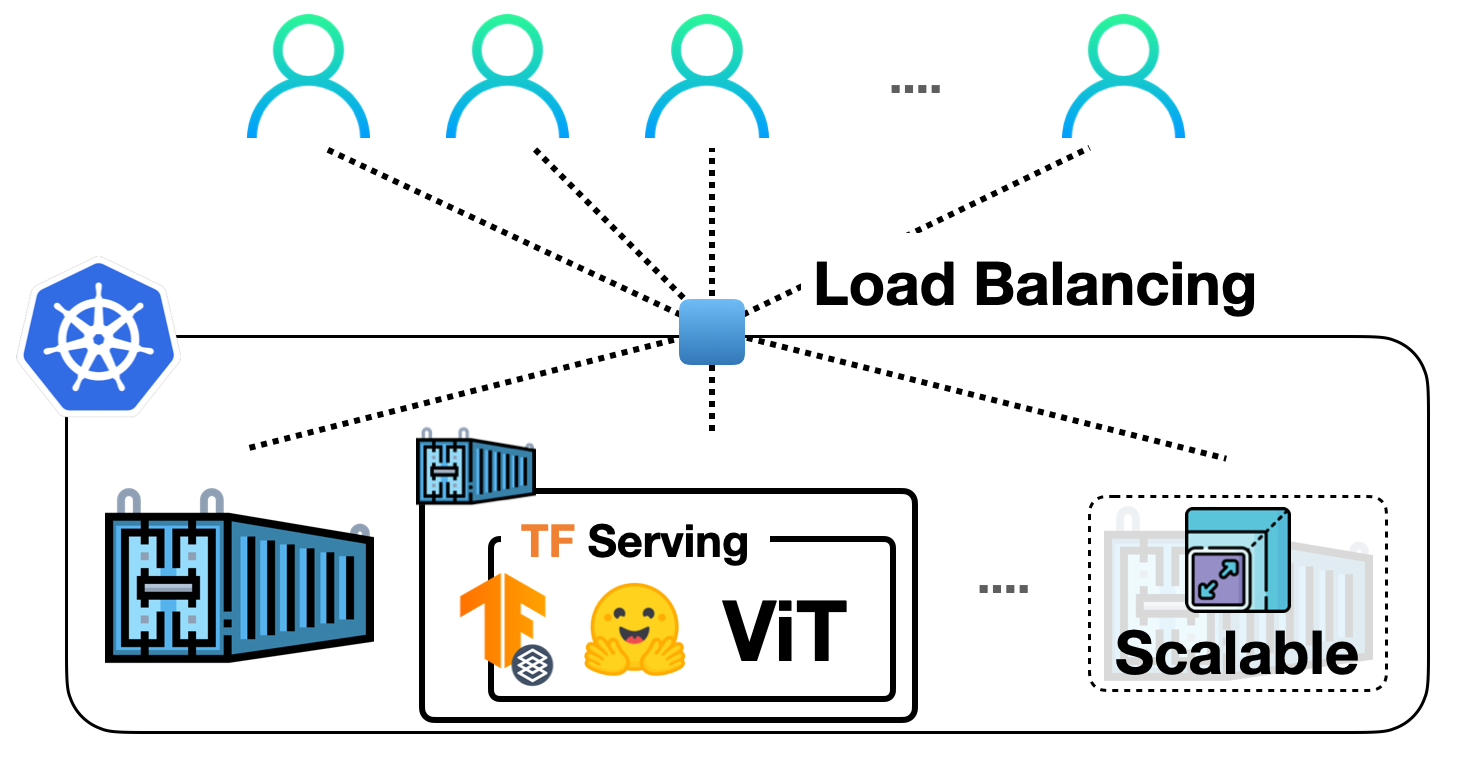
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr

ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
ავარჯიშეთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი: როგორ აამუშავოთ Half-Cheetah
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს, თუ როგორ უნდა ავარჯიშოთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი ნულიდან. ის განმარტავს Decision Transformer-ის ძირითად კონცეფციას, რომელიც აძლიერებს სწავლის პრობლემას პირობით-თანმიმდევრობის მოდელირების ამოცანად გარდაქმნის გზით, რათა წარმოქმნას მომავალი ქმედებები სასურველი შედეგების, წარსული მდგომარეობებისა და ქმედებების საფუძველზე. გაკვეთილი ფოკუსირებულია ოფლაინ მიდგომაზე, Google Colab-ის, 🤗 Trainer-ის და სპეციალური მონაცემთა კოლატორის გამოყ

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ

LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ
ჰომომორფული დაშიფვრა მოქმედებაში: სენტიმენტების ანალიზი დაშიფრულ მონაცემებზე Concrete-ML-ით
ახალი ტექნოლოგიური მიღწევა მონაცემთა კონფიდენციალურობის სფეროში: სტატია იკვლევს ჰომომორფულ დაშიფრვას (FHE), რომელიც იძლევა დაშიფრულ მონაცემებზე გამოთვლების საშუალებას მათი გაშიფვრის გარეშე. Concrete-ML ბიბლიოთეკის დახმარებით, მონაცემთა მეცნიერებს შეუძლიათ შექმნან მანქანური სწავლების მოდელები FHE გარემოში კრიპტოგრაფიის ცოდნის გარეშე. გთავაზობთ პრაქტიკულ სახელმძღვანელოს დაშიფრულ მონაცემებზე სენტიმენტების ანალიზის მოდელის შესაქმნელად, დემო ვერსიით Hugging Face Spaces-ზე.
Hugging Face-ი მანქანური სწავლების მოდელების დოკუმენტაციის გასაუმჯობესებლად ახალ ხელსაწყოებსა და სახელმძღვანელოს უშვებს
Hugging Face-ი აქვეყნებს მოდელის ბარათის შექმნის ხელსაწყოსა და სახელმძღვანელოს, რაც მიზნად ისახავს მანქანური სწავლების (ML) მოდელების დოკუმენტაციის გამარტივებას, სტანდარტიზაციასა და გაუმჯობესებას. ეს ინიციატივა ხელს შეუწყობს სხვადასხვა წარმომავლობისა და როლის მქონე მომხმარებლების ჩართულობას, მათ შორის დეველოპერების, სტუდენტების, პოლიტიკოსების, ეთიკოსების და მათ, ვისზეც ML მოდელები გავლენას ახდენენ. პროექტი მოიცავს პროგრამირების გარეშე ბარათების შექმნის საშუალებას, განახლებულ შაბლონს და დეტალურ ი
თამაშების დიზაინი AI-ის დახმარებით: Stable Diffusion და Unity
ეს სტატია გთავაზობთ სახელმძღვანელოს, თუ როგორ გამოვიყენოთ Stable Diffusion ხელოვნური ინტელექტის მოდელი, რათა შევქმნათ უნიკალური ვიზუალური სტილი ჩვენი თამაშისთვის, კერძოდ კი სოფლის მეურნეობის სიმულატორისთვის Unity-ში. განხილულია Stable Diffusion-ის ლოკალურად ან ონლაინ გაშვების მეთოდები, პრომპტინგის რჩევები და საბოლოოდ, კონცეპტუალური ხელოვნების ინტეგრაცია Unity-ში.

სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ