SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ
LLM-ის მუშაობის ლიდერბორდი: სიჩქარე, ფასი და ხარისხი AI აპლიკაციებისთვის Hugging Face-ზე
Artificial Analysis-მა გამოაქვეყნა LLM-ის მუშაობის ლიდერბორდი Hugging Face-ზე, რომელიც აფასებს 100-ზე მეტი უსერვერო LLM API ენდპოინტის სიჩქარეს, ფასსა და ხარისხს. ეს ინსტრუმენტი მიზნად ისახავს AI ინჟინრებს დაეხმაროს გადაწყვეტილებების მიღებაში, თუ რომელი მოდელები და პროვაიდერები გამოიყენონ თავიანთ აპლიკაციებში, რადგან სამომხმარებლო და კომპლექსური AI სისტემებისთვის მუშაობის ეს ფაქტორები კრიტიკულია.

KV ქეშის კვანტიზაცია: მეხსიერების რევოლუცია დიდ ენობრივ მოდელებში
KV ქეშის კვანტიზაცია ამცირებს მეხსიერების მოხმარებას დიდ ენობრივ მოდელებში (LLM) ხანგრძლივი ტექსტის გენერაციისას, ხარისხზე მინიმალური გავლენით, და გვთავაზობს კონფიგურირებად კომპრომისებს მეხსიერების ეფექტურობასა და გენერაციის სიჩქარეს შორის.
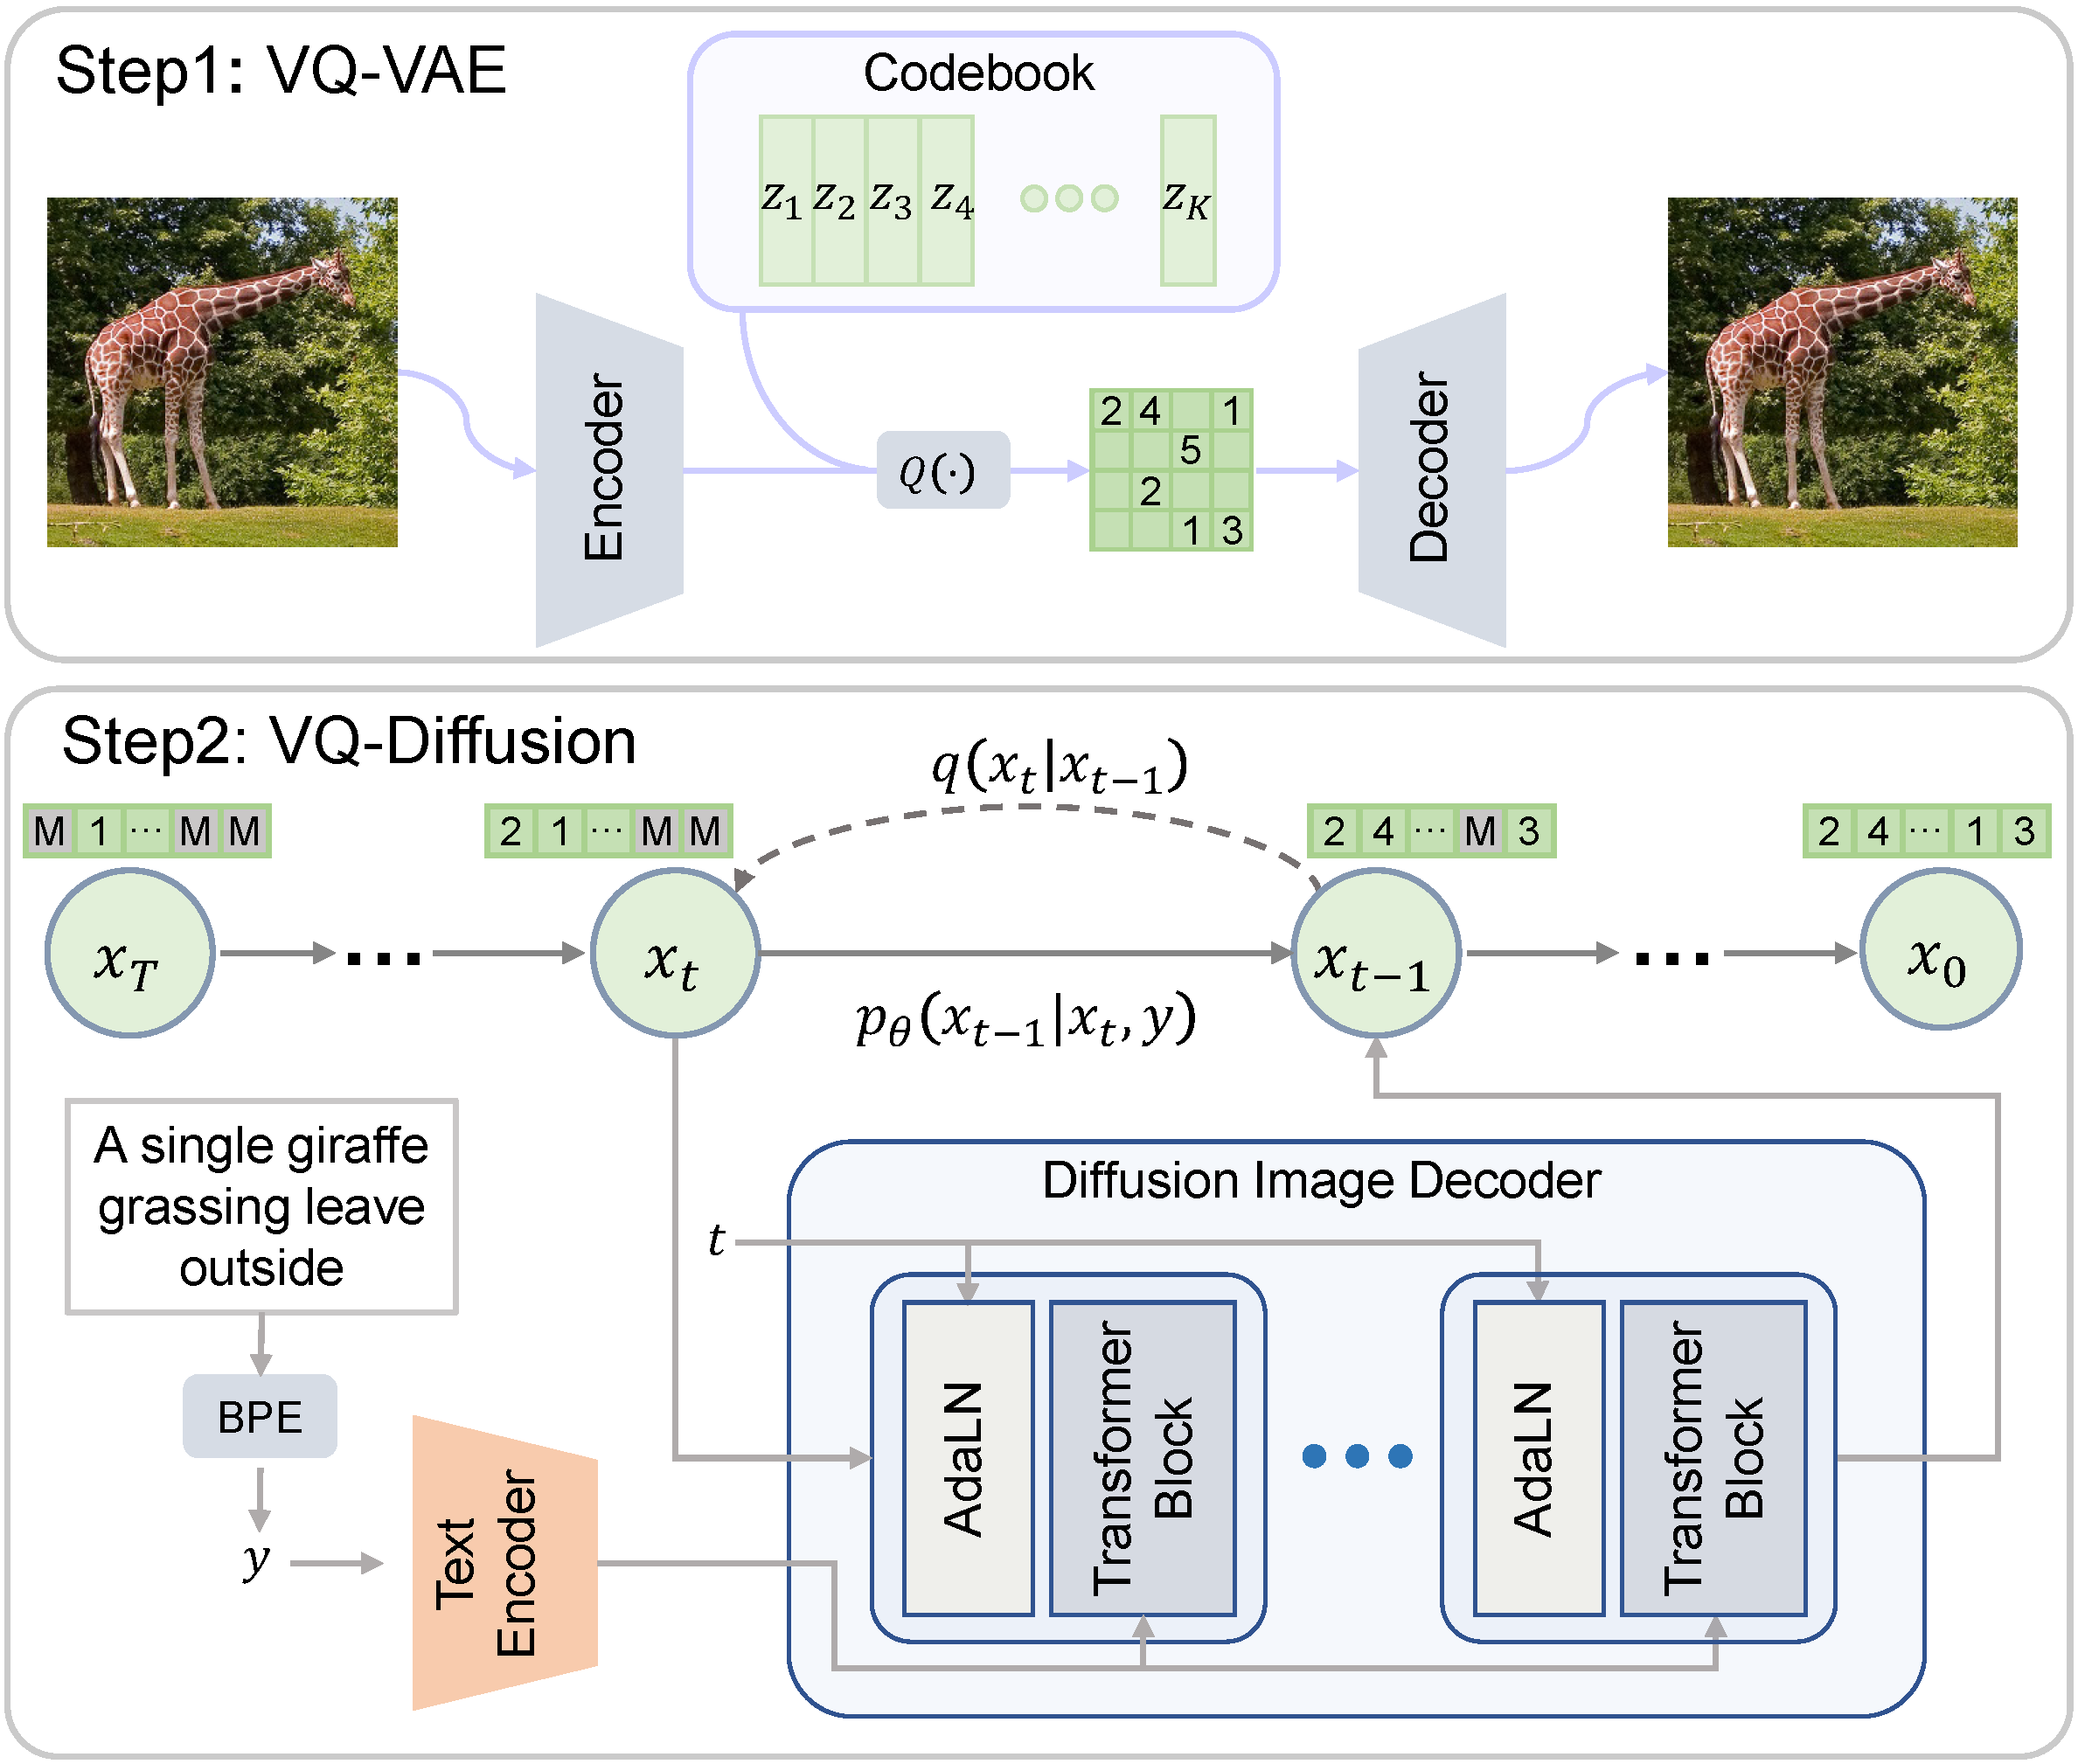
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ

შეუძლებელის ზღვარზე: ილია მალინინი და ფიგურული სრიალის მომავალი
სტატია მოგვითხრობს ფიგურულ სრიალში ოთხმაგი ნახტომების ისტორიულ განვითარებაზე, კურტ ბრაუნინგის პირველი ოთხმაგი თოუ-ლუპიდან ილია მალინინის გარღვევამდე ოთხმაგი აქსელის შესრულებით, რაც ბევრს, მათ შორის მწვრთნელ ალექსეი მიშინს და მოციგურავე ტიმოთი გოებელს, შეუძლებლად მიაჩნდა. ხაზგასმულია მალინინის უნიკალური ტექნიკა, რომელიც მას საშუალებას აძლევს ეფექტურად მიაღწიოს მაღალ კუთხურ სიჩქარეს, რაც 2026 წლის ოლიმპიადის უდავო ფავორიტად აქცევს და უპრეცედენტო ხუთმაგი ნახტომის ძლიერ პრეტენდენტად, მიუხედავად Asso
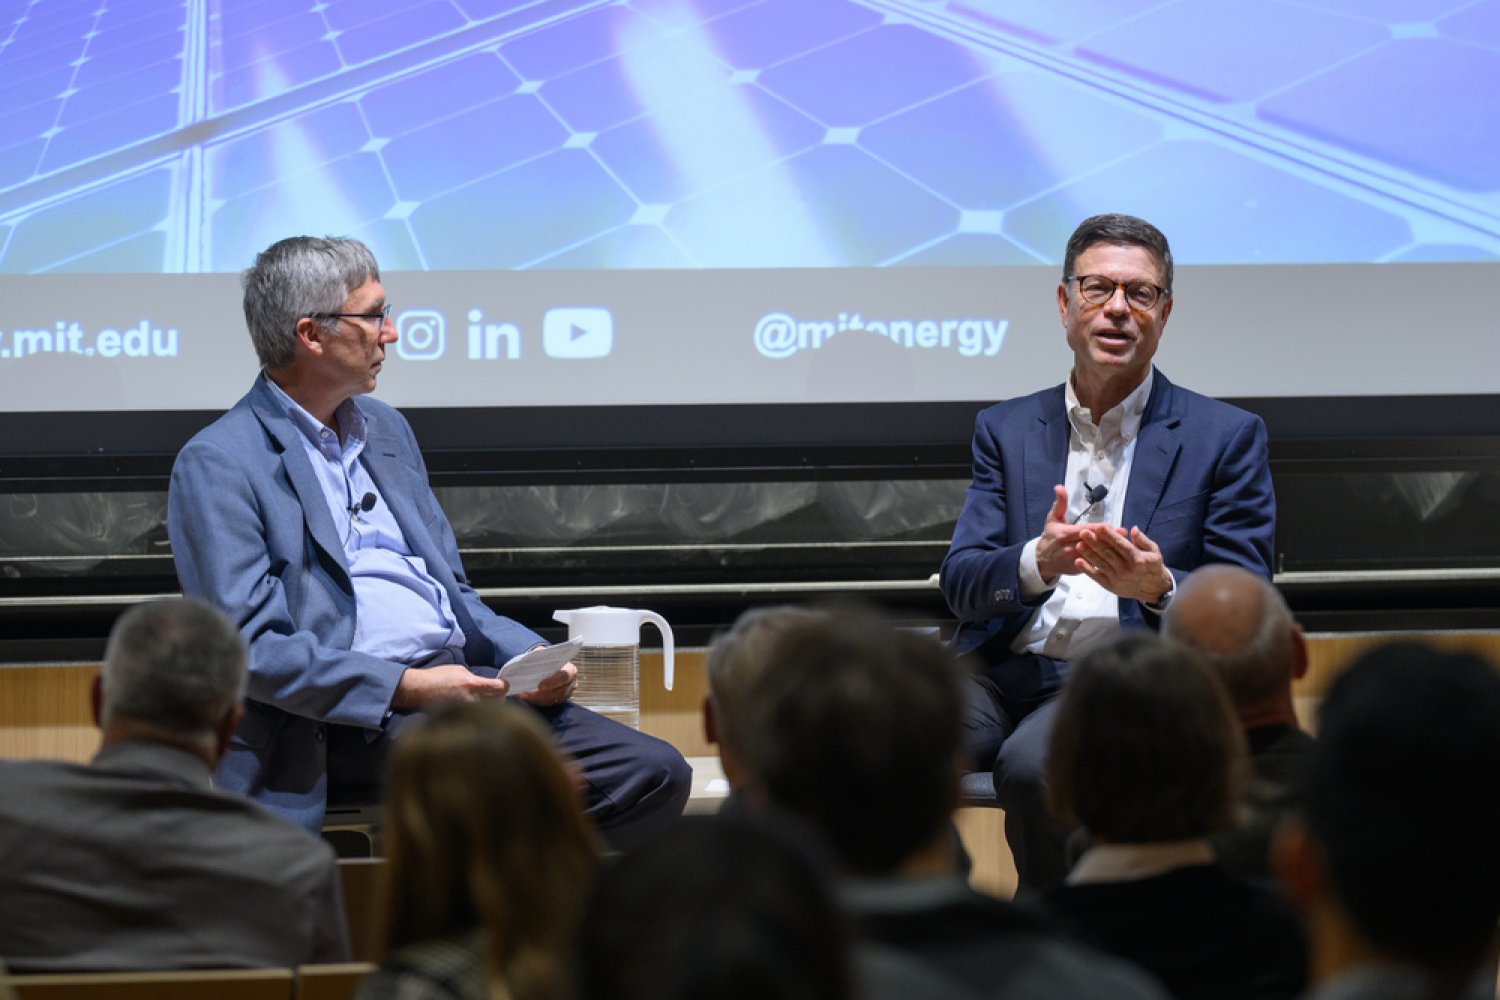
General Motors-ი ბატარეის ინოვაციების წამყვანი ძალა: ლაბორატორიიდან კომერციალიზაციამდე
General Motors-ის (GM) ბატარეების, ამძრავის სისტემებისა და მდგრადობის ვიცე-პრეზიდენტის, კურტ კელტის განცხადებით, ბატარეის ინოვაციები რევოლუციას ახდენს მობილობისა და ენერგეტიკულ სისტემებში. MIT ენერგეტიკული ინიციატივის (MITEI) კოლოკვიუმზე კელტიმ ისაუბრა GM-ის მიდგომაზე, რომელიც მიზნად ისახავს ახალი თაობის ბატარეის ტექნოლოგიების ლაბორატორიიდან კომერციალიზაციამდე მიტანას. ძირითადი აქცენტი კეთდება ხელმისაწვდომობის გაუმჯობესებაზე, ბატარეის მუშაობის მაჩვენებლების გაზრდაზე (დატენვის სიჩქარე, ენერგიის ს
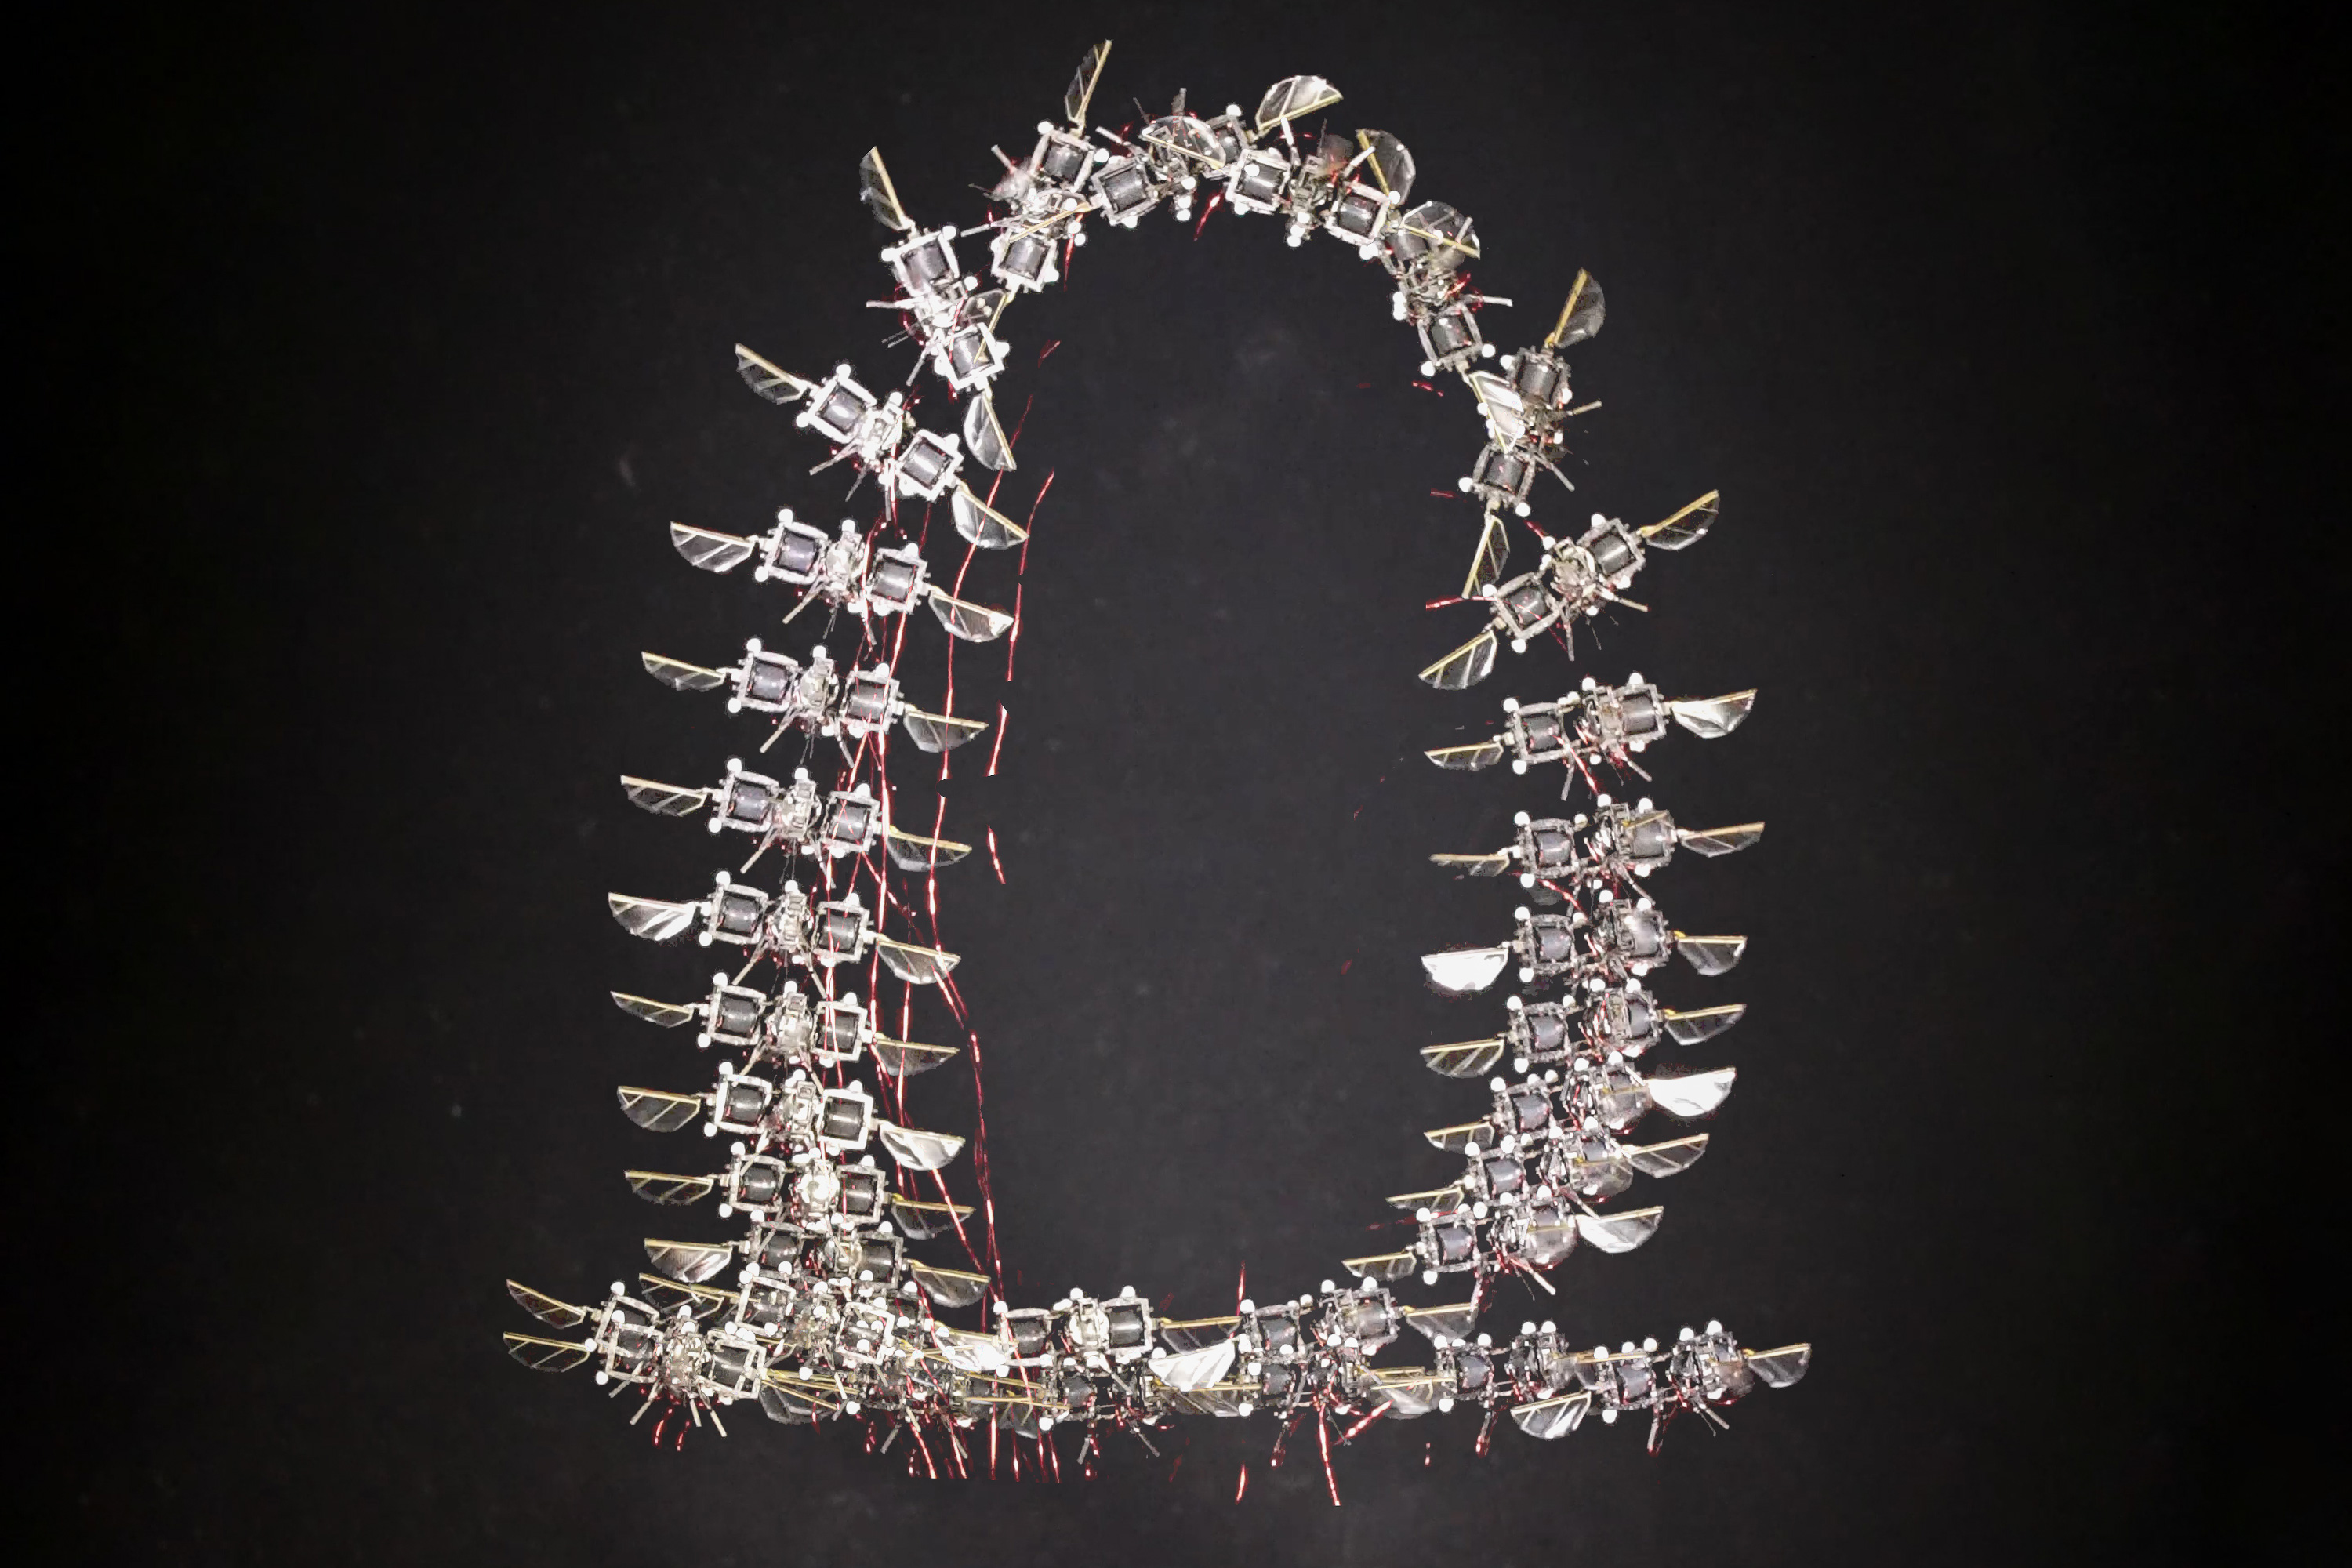
MIT-ის მკვლევარებმა შექმნეს მოქნილი, მწერების მსგავსი მფრინავი მიკრობოტები
MIT-ის მკვლევარებმა შეიმუშავეს საჰაერო მიკრობოტები, რომლებსაც შეუძლიათ იფრინონ ნამდვილი მწერების მსგავსი სისწრაფითა და მოქნილობით, რაც მნიშვნელოვანი ნახტომია წინა ვერსიებთან შედარებით. ახალი ხელოვნურ ინტელექტზე დაფუძნებული კონტროლერის მეშვეობით, ამ პატარა რობოტებს შეუძლიათ შეასრულონ რთული მანევრები, როგორიცაა უწყვეტი სალტოები, რითაც მათი სიჩქარე 450%-ით, ხოლო აჩქარება 250%-ით გაიზარდა. ეს მიღწევა ხსნის შესაძლებლობებს მათ გამოსაყენებლად სტიქიური უბედურებების ზონებში, გადარჩენის ოპერაციებისთვის, ს