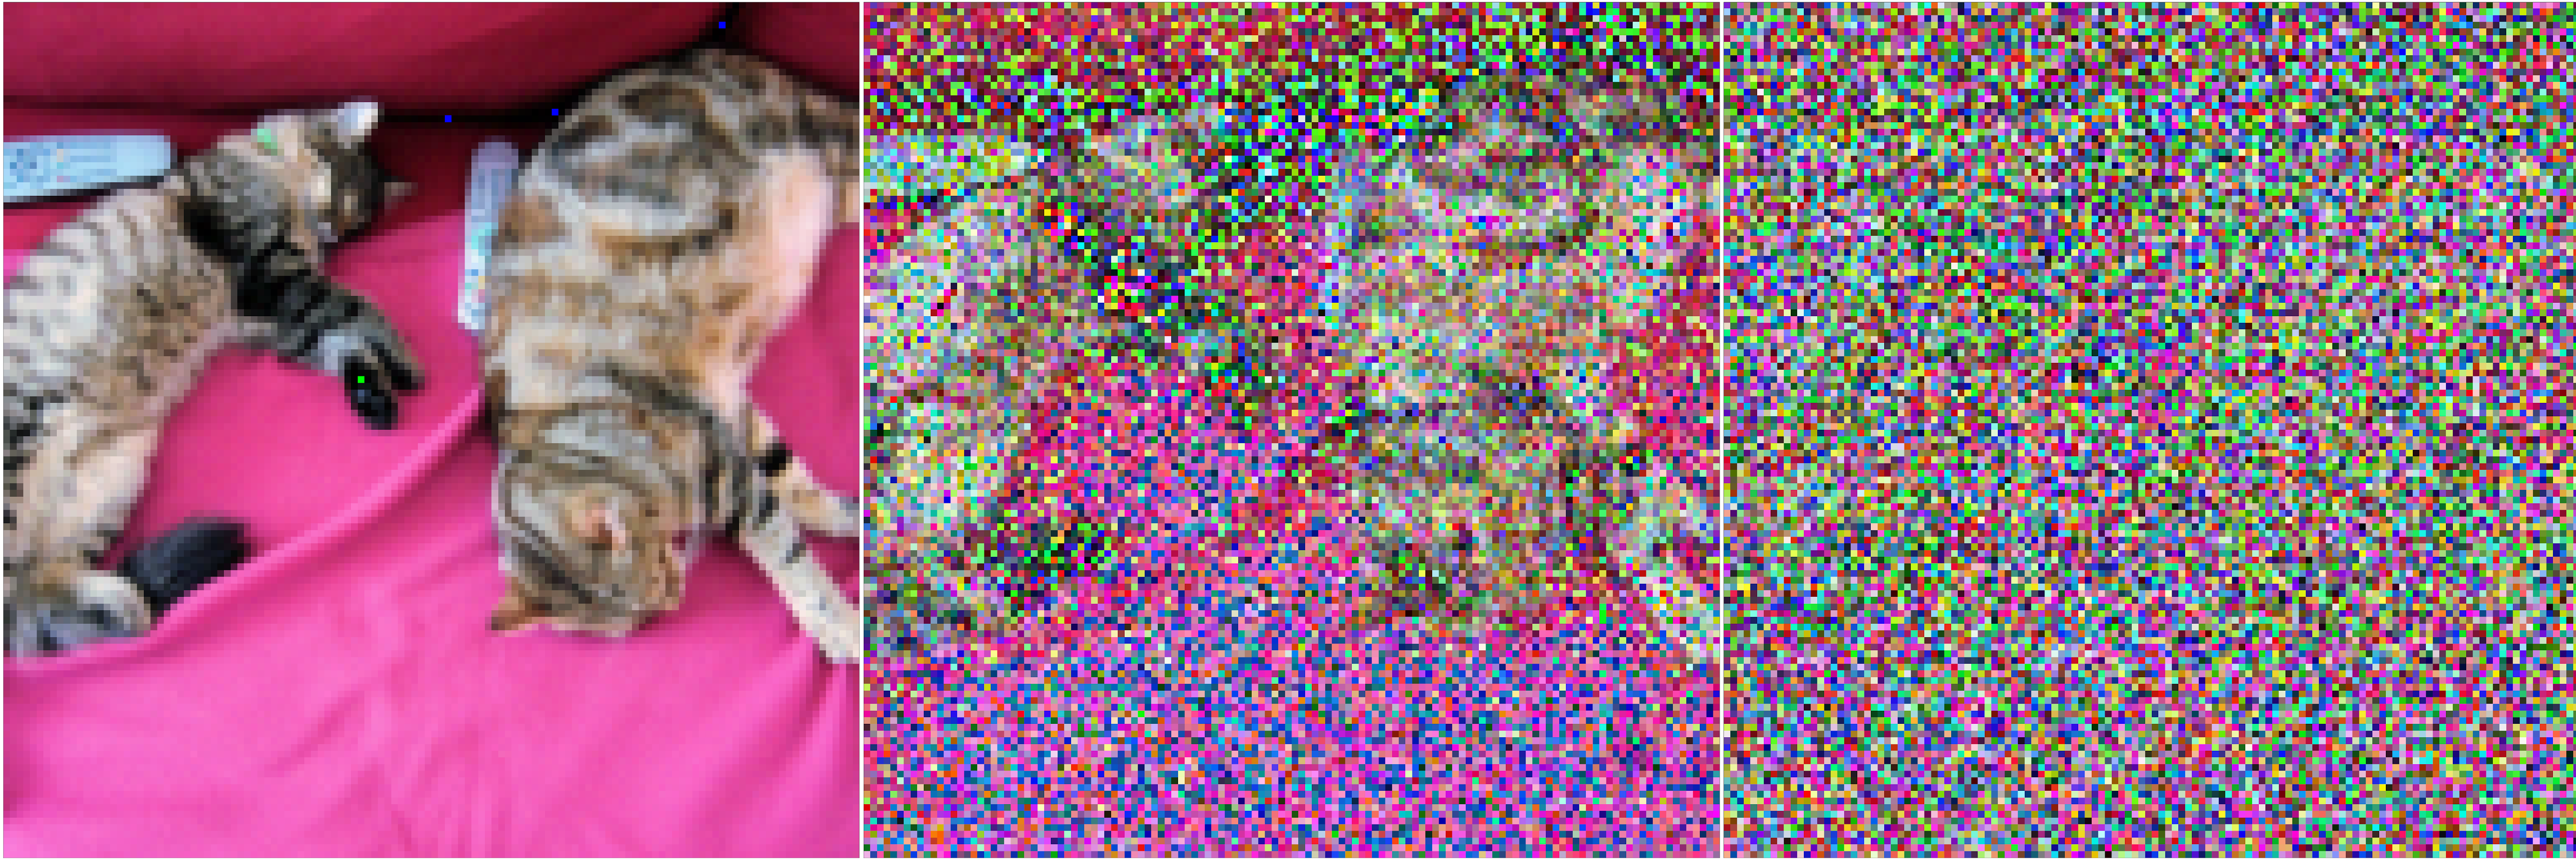
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.
მანქანური სწავლება ფინანსურ სექტორში: გამოწვევები, ნდობა და ინოვაციების როლი
სტატია განიხილავს მანქანური სწავლების (ML) დირექტორების უნიკალურ გამოწვევებს ფინანსურ სექტორში, მათ შორის მოძველებული სისტემების მართვას, მოდელების ინტერპრეტაციას და მომხმარებელთა ნდობის შენარჩუნებას მკაცრი რეგულაციების პირობებში. ხაზგასმულია, თუ როგორ გამოიწვია ML-მა დისკუსიები ფინანსურ გადაწყვეტილებებში ნდობის შესახებ და გახდა გარდამტეხი ძალა, რამაც ახალი ბიზნეს შესაძლებლობები შექმნა. წამყვანი ფინანსური ინსტიტუტების ექსპერტები იზიარებენ თავიანთ შეხედულებებს ამ გამოწვევებზე, განსაკუთრებით მოძვე
ტექსტის გენერაციის პაიპლაინი Intel® Gaudi® 2-ზე: მოქნილობა და Llama 2-ის ინტეგრაცია
წარმოდგენილია პერსონალური პაიპლაინის კლასი, რომელიც შექმნილია Intel® Gaudi® 2 AI აქსელერატორისთვის, რაც უზრუნველყოფს ტექსტის გენერაციის მოქნილობას, სიმარტივეს და აბსტრაქციის მაღალ დონეს. ის მხარს უჭერს Llama 2 მოდელებს და ინტეგრირდება LangChain-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შექმნან ტექსტი, როგორც სტანდარტული სკრიპტებით, ასევე საკუთარ პროექტებში. სტატია დეტალურად აღწერს წვდომის მიღების, ინსტალაციისა და გამოყენების ნაბიჯებს, ასევე Llama 2-ის ლიცენზირების მნიშვნელოვან დეტალებს.

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
Hugging Face და Argilla: ერთობლივი ძალებით უკეთესი მონაცემთა ბაზებისთვის
Hugging Face და Argilla ერთობლივ ინიციატივას იწყებენ, რათა საზოგადოებას დაეხმარონ მაღალი ხარისხის მონაცემთა ბაზების შექმნაში, განსაკუთრებით ნაკლებად წარმოდგენილი ენებისა და ამოცანებისთვის. პროექტი გულისხმობს ინსტრუმენტების, როგორიცაა Argilla და Hugging Face Spaces, გამოყენებას ანოტაციის პროცესის გასამარტივებლად. მოწვეულნი არიან დაინტერესებული თემები, რათა შეუერთდნენ საწყის კოჰორტას და წვლილი შეიტანონ ხელოვნური ინტელექტის განვითარებაში, კოდირების ცოდნის გარეშეც.
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging
ხელოვნური ინტელექტი ვებ-დიზაინს HTML კოდში აქცევს: WebSight და Sightseer
ვებ-დიზაინის HTML კოდში გადაქცევა ხშირად გამოცდილ დეველოპერს მოითხოვს. ეს სტატია იკვლევს, თუ როგორ შეუძლიათ ვიზუალური ენის მოდელებს (VLMs) ამ პროცესის გამარტივება. წარმოდგენილია WebSight მონაცემთა ბაზა და Sightseer მოდელი, რომლებიც ხელოვნურ ინტელექტს საშუალებას აძლევენ ვიზუალური დიზაინი ფუნქციურ HTML კოდში გადაიყვანოს, რაც ვებ-დეველოპმენტს უფრო ეფექტურსა და ხელმისაწვდომს ხდის.

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო
ღრმა გაძლიერებითი სწავლება: პოლიტიკაზე დაფუძნებული მეთოდები და Reinforce
სტატია მიმოიხილავს პოლიტიკაზე დაფუძნებულ მეთოდებს ღრმა გაძლიერებით სწავლებაში, უპირისპირებს რა მათ ღირებულებაზე დაფუძნებულ მიდგომებს. განმარტებულია, რომ პოლიტიკაზე დაფუძნებული მეთოდები უშუალოდ ოპტიმიზაციას უკეთებენ პოლიტიკას შუალედური ღირებულების ფუნქციის გარეშე, კონკრეტულად კი ალგორითმ Reinforce-ის მაგალითზე. ხაზგასმულია ძირითადი უპირატესობები, როგორიცაა ინტეგრაციის სიმარტივე, სტოქასტური პოლიტიკის სწავლის უნარი და ისეთი პრობლემების გადაჭრა, როგორიცაა აღქმითი ალიასინგი, ასევე უწყვეტი მოქმედებები
Hugging Face-ი და NVIDIA-ი „ტრენინგს DGX Cloud-ზე“ უშვებენ Enterprise Hub-ის ორგანიზაციებისთვის
Hugging Face-მა NVIDIA-სთან ერთად წარადგინა „ტრენინგი DGX Cloud-ზე“, ახალი სერვისი Hugging Face Hub-ზე, რომელიც განკუთვნილია Enterprise Hub-ის ორგანიზაციებისთვის. ეს პლატფორმა მომხმარებლებს აძლევს მყისიერ წვდომას NVIDIA H100 Tensor Core GPU-ებზე, რათა მარტივად დახვეწონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. სერვისი ამარტივებს ხელოვნური ინტელექტის მოდელების წვრთნის პროცესს კოდის გარეშე მუშაობის (no-code) და მოხმარების მიხედვით გადახდის (pay-as-you-go) მო
Hugging Face-ი NVIDIA-სთან პარტნიორობით „Train on DGX Cloud“ სერვისს უშვებს Enterprise Hub ორგანიზაციებისთვის
Hugging Face-ი, NVIDIA-სთან ერთად, წარმოგიდგენთ „Train on DGX Cloud“-ს – ახალ სერვისს, რომელიც ხელმისაწვდომია Enterprise Hub ორგანიზაციებისთვის Hugging Face Hub-ზე. ეს პლატფორმა ამარტივებს ღია მოდელების გამოყენებას NVIDIA DGX Cloud-ის მაღალსიჩქარიან გამოთვლით ინფრასტრუქტურასთან. სერვისი მომხმარებლებს აძლევს მყისიერ წვდომას უახლეს NVIDIA H100 Tensor Core GPU-ებზე, რაც მათ საშუალებას აძლევს, მარტივად დააზუსტონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. „Train

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.

GaLore: გარღვევა ხელოვნური ინტელექტის მოდელების ვარჯიშში სამომხმარებლო GPU-ებზე
GaLore-ის ინოვაციური შესაძლებლობა, ავარჯიშოს 7 მილიარდ პარამეტრამდე ხელოვნური ინტელექტის მოდელები, როგორიცაა Llama არქიტექტურაზე დაფუძნებული მოდელები, სამომხმარებლო GPU-ებზე (მაგალითად, NVIDIA RTX 4090), წარმოადგენს მნიშვნელოვან გარღვევას. ეს მიიღწევა ოპტიმიზატორის მდგომარეობებისა და გრადიენტებისთვის საჭირო მეხსიერების მოთხოვნების მკვეთრი შემცირებით, დაბალი რანგის პროექციისა და 8-ბიტიანი სიზუსტის ოპტიმიზატორების კომბინაციით, რაც დიდ მოდელებს უფრო ხელმისაწვდომს ხდის ფართო მომხმარებლისთვის და ზღვა

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები