
დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
ღრმა განმტკიცებითი სწავლება: ხელოვნური ინტელექტის მომავალი (სრული კურსის პირველი ნაწილი)
ეს სტატია ღრმა განმტკიცებითი სწავლების კურსის შესავალი ნაწილია, რომელიც ხელოვნური ინტელექტის ერთ-ერთ ყველაზე მომხიბვლელ სფეროს ეხება. აქ განმარტებულია, თუ როგორ სწავლობს აგენტი გარემოში ქცევას მოქმედებების შესრულებითა და შედეგების დანახვით. განიხილება დარგის მნიშვნელოვანი მიღწევები და მოწოდებულია დეტალური ინფორმაცია უფასო კურსის შესახებ, სადაც შეისწავლით თეორიასა და პრაქტიკას ცნობილი ბიბლიოთეკების გამოყენებით.

დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M

Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა

Falcon-H1: ხელოვნური ინტელექტის მოდელების ინოვაციური სერია ჰიბრიდული არქიტექტურით
წარმოგიდგენთ Falcon-H1 სერიას, ექვს ღია კოდის მოდელს 0.5B-დან 34B პარამეტრამდე, რომლებიც ხელმისაწვდომია როგორც საბაზო, ასევე ინსტრუქციებზე მორგებულ ვარიანტებში. ამ მოდელების გულში დგას ჰიბრიდული არქიტექტურა, რომელიც აერთიანებს კლასიკური ტრანსფორმერზე დაფუძნებული ყურადღების მექანიზმისა და მდგომარეობის სივრცის მოდელის (SSM) ძლიერ მხარეებს. ეს ინოვაციური მიდგომა უზრუნველყოფს უპრეცედენტო წარმადობას, მაღალ ეფექტურობას და ფართო მასშტაბურობას, რაც Falcon-H1-ს კონკურენტუნარიანს ხდის წამყვან ტრანსფორმერზ

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ
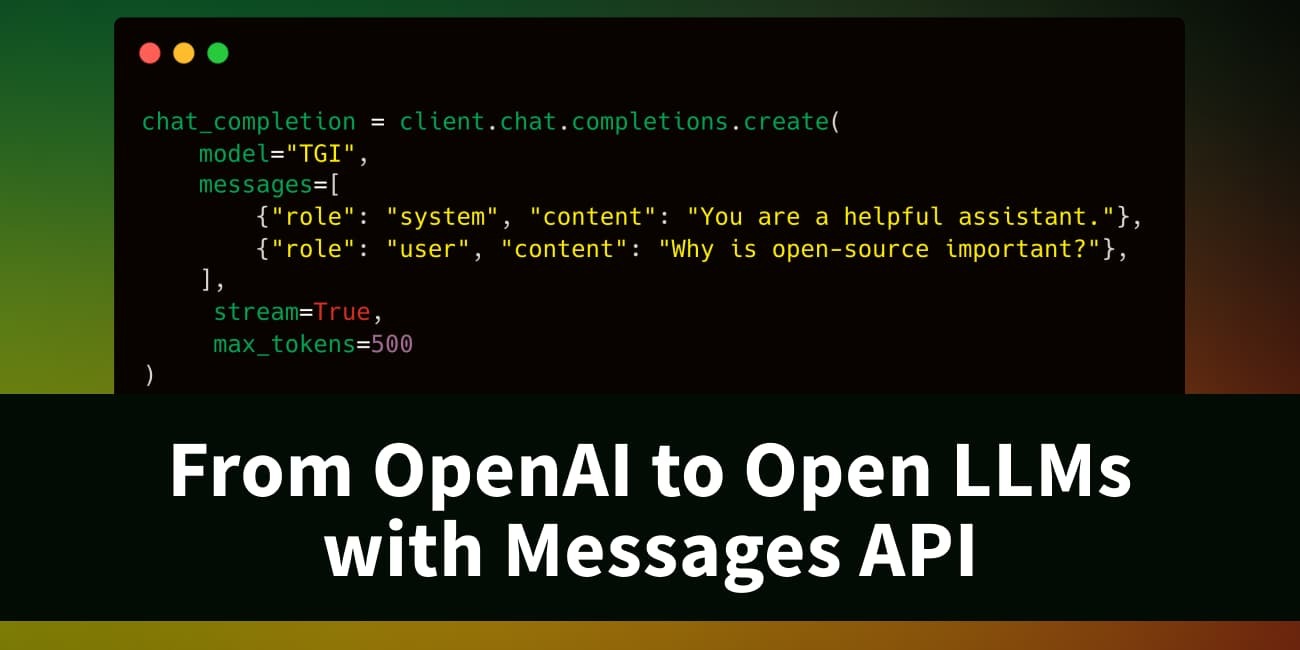
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
ინტერვიუ საშა ლუჩიონთან: AI-ს ეთიკური გამოყენება და მისი გარემოზე ზემოქმედება
წარმოგიდგენთ ინტერვიუს საშა ლუჩიონთან, Hugging Face-ის მკვლევარ მეცნიერთან, რომელიც მუშაობს მანქანური სწავლის მოდელებისა და მონაცემთა ნაკრებების ეთიკურ და საზოგადოებრივ გავლენებზე. საშა ასევე Big Science Workshop-ის ნახშირბადის კვალის სამუშაო ჯგუფის თანათავმჯდომარე და Climate Change AI (CCAI) ორგანიზაციის დამფუძნებელი წევრია. ამ ეპიზოდში ის საუბრობს იმაზე, თუ როგორ ზომავს ელექტრონული ფოსტის ნახშირბადის კვალს, როგორ დაეხმარა ადგილობრივ საქველმოქმედო სამზარეულოს ML-ის გამოყენებაში და როგორ ანიჭებს
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
LoRA ადაპტერების შერწყმის ახალი მეთოდები AI მოდელებში
ეს პოსტი Hugging Face-ის PEFT ბიბლიოთეკაში LoRA ადაპტერების შერწყმის ინოვაციურ მეთოდებს წარმოგიდგენთ. ის დეტალურად განიხილავს, თუ როგორ შეიძლება ერთი და იგივე საბაზისო მოდელიდან მიღებული სხვადასხვა ადაპტერების გაერთიანება, რათა მიღებულ იქნეს ოპტიმალური შედეგები, მეხსიერების შეზღუდვის მიუხედავად. აღწერილია კონკატენაციის, შეწონილი ჯამის, ამოცანის არითმეტიკისა და TIES მეთოდები, კოდის მაგალითებითა და სამომავლო გეგმებით.

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.

Hugging Face და NVIDIA AI კვლევისთვის GPU რესურსებს ხელმისაწვდომს ხდიან „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) მეშვეობით
Hugging Face და NVIDIA აცხადებენ თანამშრომლობის შესახებ და წარმოადგენენ „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) ინიციატივას. ეს პლატფორმა მიზნად ისახავს AI-ის მკვლევრებისთვის და ორგანიზაციებისთვის GPU კლასტერებზე ხელმისაწვდომობის გაფართოებას, რათა მათ შეძლონ ხელოვნური ინტელექტის მოდელების ეფექტურად მომზადება. სერვისი გთავაზობთ მოქნილ გადახდის მოდელს, რაც რესურსების მოთხოვნისამებრ გამოყენების საშუალებას იძლევა და ამცირებს „გამოთვლითი რესურსების ხარვეზს“.
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ
ღრმა Q-სწავლება: როგორ ვავარჯიშოთ აგენტები Atari-ს თამაშებში
ეს სტატია ღრმა გაძლიერებული სწავლების კურსის ნაწილია. განვიხილავთ, თუ როგორ გადადის ტრადიციული Q-სწავლება, რომელსაც შეზღუდვები აქვს დიდი მდგომარეობათა სივრცეების შემთხვევაში, ღრმა Q-სწავლებაში. ეს უკანასკნელი იყენებს ნერვულ ქსელებს Q-მნიშვნელობების აპროქსიმაციისთვის, რაც საშუალებას გვაძლევს მოვამზადოთ აგენტები რთული გარემოებისთვის, როგორიცაა Atari-ს თამაშები. სტატია დეტალურად აღწერს Deep Q-Network-ის არქიტექტურას, მონაცემთა წინასწარ დამუშავებას და ჩარჩოების დაწყობის მნიშვნელობას დროითი შეზღუდვებ

ხელოვნური ინტელექტის მიერ გენერირებული კონტენტის წყლის ნიშნები და მისი ავთენტურობის დაცვა
ამ ბლოგპოსტში განვიხილავთ ხელოვნური ინტელექტის (AI) მიერ გენერირებული კონტენტის წყლის ნიშნების დამატების მეთოდებს, მათ უპირატესობებსა და ნაკლოვანებებს, ასევე Hugging Face Hub-ზე არსებულ ინსტრუმენტებს. სტატია ასევე აანალიზებს კონტენტის ავთენტურობის დაცვის სხვა ტექნიკებს, როგორიცაა გამოსახულების ცვლილება და „მოწამვლა“, და მიმოიხილავს ღია და დახურული სისტემების გამოწვევებს სხვადასხვა მოდიფიკაციისთვის.