
Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
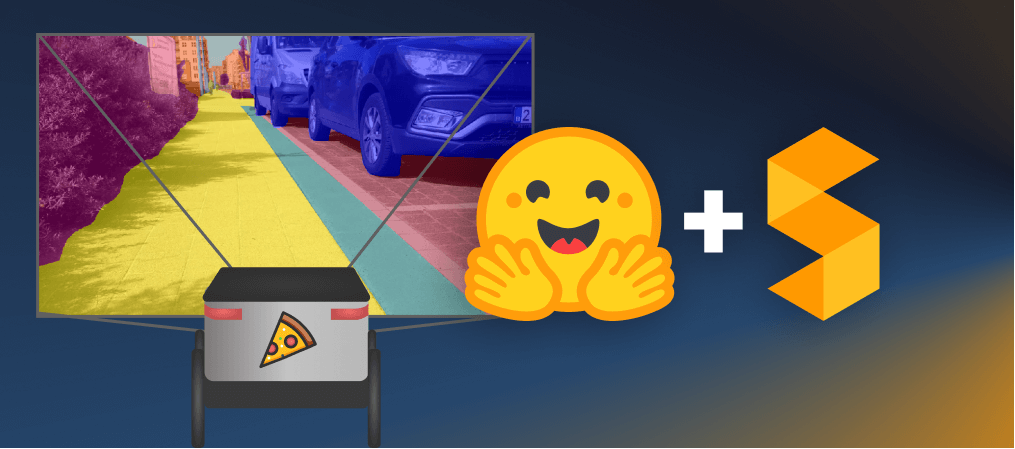
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ

olmOCR-ის გაუმჯობესება: სრული დოკუმენტის კონტექსტის ამოცნობა სათაურებისა და ქვედა კოლონტიტულების ჩათვლით
olmOCR ხშირად უგულებელყოფს მნიშვნელოვან ინფორმაციას დოკუმენტების სათაურებსა და ქვედა კოლონტიტულებში, რაც მის საწყის სატრენინგო მონაცემთა ბაზის თავისებურებებით იყო განპირობებული. ამ პრობლემის გადასაჭრელად, მკვლევრებმა olmOCR-ის მოდელი დახვეწეს Qwen2.5-VL-72B-Instruct-ის მიერ გენერირებული 8,000 დოკუმენტისგან შემდგარი ახალი მონაცემთა ბაზის გამოყენებით. შედეგად, მოდელი ახლა სრულყოფილად იღებს მთელ კონტენტს, მათ შორის ადრე გამოტოვებულ მონაცემებსაც, რაც გადამწყვეტია ბიზნეს აპლიკაციებისთვის, როგორიცაა ი

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე
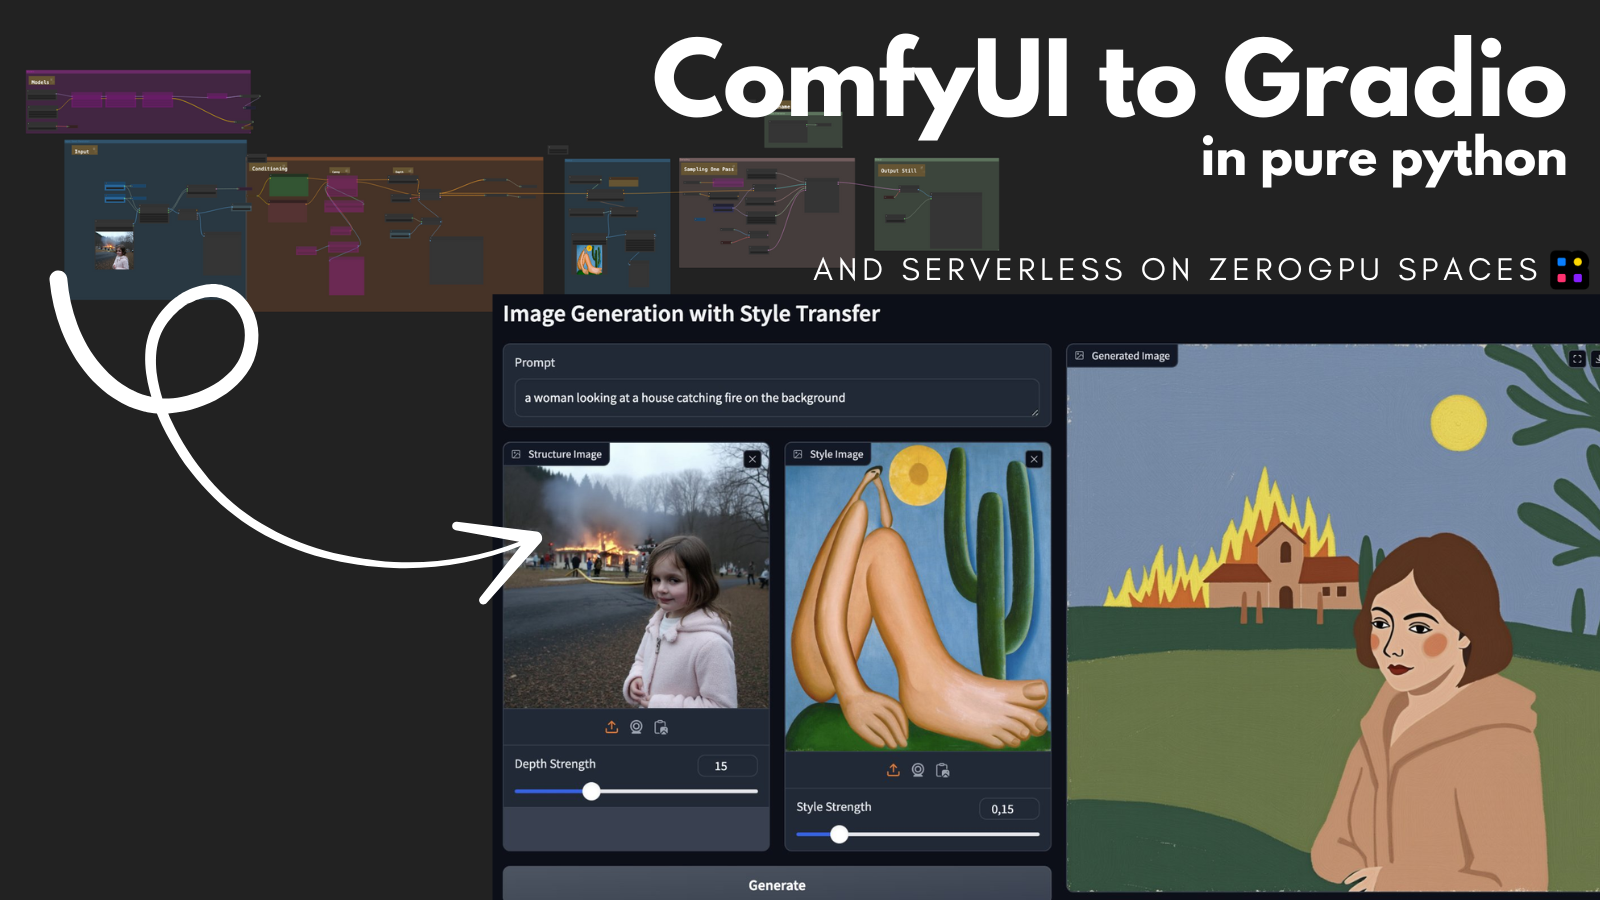
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
მანქანური სწავლების მოდელების ნახშირბადის კვალის თვალყურის დევნება და შემცირება
ეს სტატია განიხილავს მანქანური სწავლების მოდელების ვარჯიშისა და განთავსების ეკოლოგიურ ზემოქმედებას, კერძოდ, მათ ნახშირბადის ემისიებს. წარმოდგენილია ისეთი ხელსაწყოები, როგორიცაა huggingface_hub ბიბლიოთეკა და codecarbon ინტეგრაცია, რომლებიც ხელს უწყობენ ამ ემისიების თვალყურის დევნას, ანგარიშგებას და მართვას, რითაც ხდება ეკო-მეგობრული AI-ის განვითარების ხელშეწყობა.

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
ხედვა-ენობრივი მოდელების ევოლუცია: სიახლეები, ტენდენციები და მომავალი
ხედვა-ენობრივი მოდელები (VLMs) დღესდღეობით ერთ-ერთი ყველაზე განხილვადი თემაა. 2024 წლის აპრილის ბლოგ პოსტში ვრცლად ვისაუბრეთ VLMs-ზე, მათ შორის LLaVA-ზე, პირველ წარმატებულ ღია წყაროს ხედვა-ენობრივ მოდელზე. მას შემდეგ მრავალი რამ შეიცვალა: მოდელები უფრო მცირე, მაგრამ ძლიერი გახდა, გაჩნდა ახალი არქიტექტურები და შესაძლებლობები (არგუმენტაცია, მოქმედება, გრძელი ვიდეოების გაგება). პარალელურად, განვითარდა ახალი პარადიგმები, როგორიცაა მულტიმოდალური ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) და მუ
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ
Hugging Face-ი მანქანურ სწავლებას ყველასთვის ხელმისაწვდომს ხდის: 5 მილიონი ადამიანის განათლების მიზანი
როგორც ღია კოდის კომპანია, რომელიც მანქანური სწავლების დემოკრატიზაციას ახდენს, Hugging Face-ი მიზნად ისახავს 2023 წლის ბოლოსთვის 5 მილიონი ადამიანისთვის მანქანური სწავლების სწავლებას. კომპანიამ უკვე მოამზადა 1000-ზე მეტი სტუდენტი 16 ქვეყნიდან 2022 წლის მარტში და ახლა აფართოებს თავის საგანმანათლებლო ინიციატივებს უფასო ონლაინ კურსებით, ვორქშოფებითა და რესურსებით პედაგოგებისთვის, რათა მანქანური სწავლების პოტენციალი და შეზღუდვები ყველასთვის გასაგები გახადოს.
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ
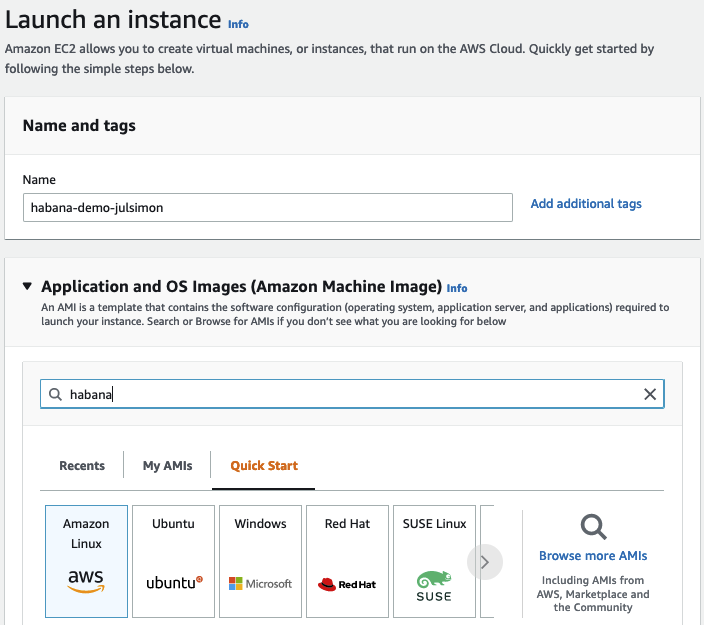
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან
Hugging Face და Google Cloud-ი აძლიერებენ პარტნიორობას ღია AI-ს დემოკრატიზაციისთვის
Hugging Face-ი და Google Cloud-ი ღრმა სტრატეგიულ პარტნიორობას აცხადებენ, რომლის მიზანია კომპანიებს საშუალება მისცეს, შექმნან საკუთარი ხელოვნური ინტელექტი ღია მოდელებისა და ღია კოდის ტექნოლოგიების გამოყენებით. თანამშრომლობა მოიცავს ღია მეცნიერებას, ღია კოდს, ღრუბლოვან სერვისებსა და აპარატურას, რათა მომხმარებლებს გაუმარტივდეს Hugging Face-ის უახლესი ღია მოდელების და Google Cloud-ის ინფრასტრუქტურის (როგორიცაა Vertex AI და TPU) გამოყენება. პარტნიორობა გააძლიერებს AI კვლევის ხელმისაწვდომობას და უზრუნ

Falcon-Edge: BitNet არქიტექტურაზე დაფუძნებული მძლავრი ენის მოდელების ახალი სერია
Falcon-Edge წარმოგიდგენთ მძლავრ, უნივერსალურ და კონფიგურირებად ენის მოდელებს, რომლებიც დაფუძნებულია BitNet არქიტექტურაზე და ხელმისაწვდომია სამმაგ ფორმატში. ეს სერია ახორციელებს ახალ წინასწარ წვრთნის პარადიგმას, რომელიც ერთდროულად აწვდის როგორც არაკვანტიზებულ, ასევე კვანტიზებულ მოდელის ვარიანტებს, მათ შორის bfloat16 ფორმატის, მშობლიურ BitNet მოდელს და წინასწარ კვანტიზებულ BitNet ვარიანტს მარტივი დაზუსტებისთვის. მოდელები ხელმისაწვდომია 1 მილიარდი და 3 მილიარდი პარამეტრის ზომებში, როგორც საბაზისო,
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.
როგორ გავიგოთ მომხმარებლის საჭიროებები HuggingFace AutoTrain-ისა და Kili-ის დახმარებით: აქტიური სწავლების დანერგვა
ეს სტატია იკვლევს ავტომატური მანქანური სწავლების (Auto ML) და აქტიური სწავლების გამოყენებას მომხმარებლის საჭიროებების გასაგებად, ტექსტის კლასიფიკაციისა და სენტიმენტების ანალიზზე ფოკუსირებით. ის დეტალურად აღწერს, თუ როგორ უნდა შეიქმნას აქტიური სწავლების მილსადენი HuggingFace AutoTrain-ისა და Kili-ის, მონაცემებზე ორიენტირებული AI ვარჯიშის პლატფორმის გამოყენებით. პროცესი მოიცავს მომხმარებლის მიმოხილვების ანოტირებას, კლასიფიკაციის მოდელების შექმნას (როგორც AutoTrain-ით, ისე მის გარეშე) და სენტიმენტე