OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
ღია კოდის ემბედინგის მოდელების განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და დაბალი ხარჯები
Hugging Face Inference Endpoints-ზე ღია კოდის ემბედინგის მოდელების განთავსების შესახებ სტატია აღწერს, თუ როგორ უზრუნველყოფს Text Embedding Inference (TEI) ამ მოდელების სწრაფ და ხარჯთეფექტურ გამოყენებას. ემბედინგის მოდელები, LLM-ებთან შედარებით, მცირე ზომისაა და სწრაფ ინფერენსს გვთავაზობს, რაც გადამწყვეტია ოპტიმალური მომხმარებლის გამოცდილებისა და ხარჯების შესამცირებლად. TEI-ის საშუალებით შესაძლებელია 450+ მოთხოვნა/წამში წარმადობის მიღწევა და 64-ჯერ უფრო დაბალი ხარჯები, ვიდრე OpenAI Embeddings-ის

DeepSeek-V3-0324: AI მოდელის ჩუმი გამოშვება გაუმჯობესებული შესაძლებლობებით
ამ კვირაში DeepSeek-მა ჩუმად გამოუშვა DeepSeek-V3-ის განახლებული ვერსია, DeepSeek-V3-0324, რომელიც ახლა MIT ლიცენზიით არის ხელმისაწვდომი. ეს ახალი მოდელი, რომელიც ორიგინალ V3-თან ერთნაირ არქიტექტურას იზიარებს, ფოკუსირებულია ინსტრუქციების შესრულების, კოდირებისა და მათემატიკური შესაძლებლობების გაუმჯობესებაზე. ის აჩვენებს ძლიერ შედეგებს ბენჩმარკებში, ხშირად GPT-4.5-ის დონეზე. სტატია ასევე განიხილავს მოდელის გამოყენების მეთოდებსა და უსაფრთხოების მნიშვნელოვან ასპექტებს, როგორიცაა ჩამოტვირთვის უსაფრთხ
Perceiver: ტრანსფორმერის არქიტექტურის შეზღუდვების დაძლევა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს Transformer-ის მოდელის რევოლუციურ ზეგავლენას ხელოვნური ინტელექტის (AI) სფეროზე, თუმცა ხაზს უსვამს მის მნიშვნელოვან შეზღუდვას: თვითყურადღების მექანიზმის გამო, ის ცუდად მასშტაბირდება მაღალი განზომილების მონაცემებთან. სტატია წარმოგიდგენთ Perceiver-ის არქიტექტურას, როგორც ამ პრობლემის გადაჭრის საშუალებას. Perceiver იყენებს ლატენტურ ცვლადებსა და ჯვარედინ ყურადღებას, რაც უზრუნველყოფს ხაზოვან დამოკიდებულებას შეყვანის ზომაზე და საშუალებას აძლევს მას ეფექტურად იმუშაოს მრავალფეროვან მ
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ
Hugging Face: როგორ გააუმჯობესეს საიდუმლოებების მართვა Infisical-ით და გაზარდეს უსაფრთხოება
Hugging Face-ის საინჟინრო გუნდმა, მრავალღრუბლოვანი ინფრასტრუქტურის პირობებში, საიდუმლოებების მართვის გაუმჯობესების მიზნით, Infisical აირჩია. ამ ქეის-სტადიაში დეტალურად არის აღწერილი მიგრაციის პროცესი, Infisical-ის ისეთი ფუნქციების ინტეგრაცია, როგორიცაა Kubernetes ოპერატორი, CI/CD ინტეგრაცია და დეტალური RBAC სისტემა. აღნიშნული გადაწყვეტილებით Hugging Face-მა მნიშვნელოვნად გააუმჯობესა უსაფრთხოება, გაამარტივა სამუშაო პროცესები და გაზარდა ინჟინრების ეფექტურობა საიდუმლოებების ცენტრალიზებული და უსაფრთ
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.
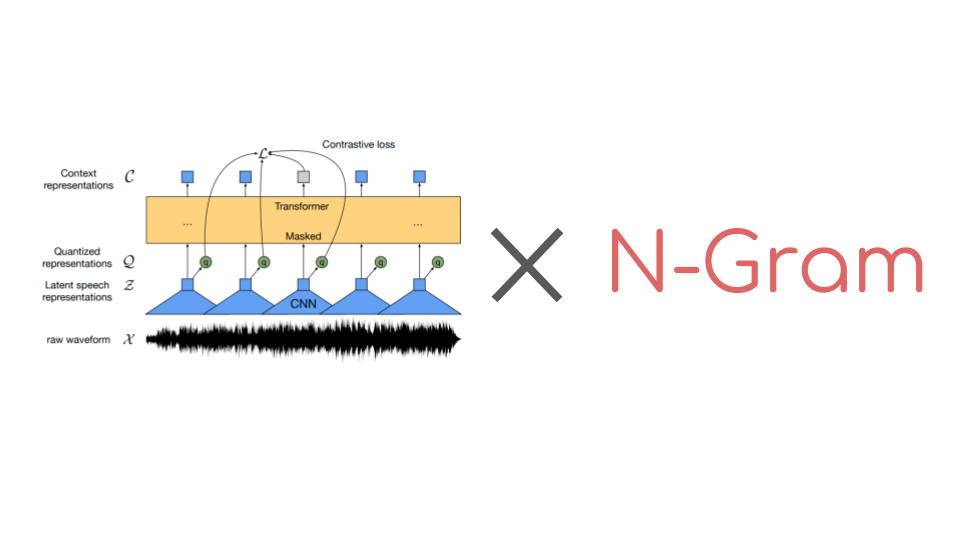
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს
ემოციური ანალიზი: ყოვლისმომცველი გზამკვლევი პითონის გამოყენებით
ეს სტატია განმარტავს, თუ როგორ გახდა ემოციური ანალიზი, რომელიც ადრე მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, ახლა ყველასთვის გამოსაყენებელი ხელოვნური ინტელექტის (AI) ინსტრუმენტების წყალობით. იგი მოიცავს ემოციური ანალიზის არსს, მის გამოყენებას მონაცემების ფართომასშტაბიანი დამუშავებისთვის და გაჩვენებთ, თუ როგორ უნდა დაიწყოთ პითონით, Hugging Face Hub-ზე არსებული მოდელების გამოყენებით, მანქანური სწავლის წინასწარი გამოცდილების გარეშე.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google
SetFitABSA: ინოვაციური მიდგომა ასპექტზე დაფუძნებული სენტიმენტის ანალიზისთვის
SetFitABSA, Intel Labs-ისა და Hugging Face-ის მიერ წარმოდგენილი ფრეიმვორკი, წარმოადგენს ეფექტურ ტექნიკას ტექსტში კონკრეტული ასპექტების მიმართ სენტიმენტის აღმოსაჩენად. ის განკუთვნილია დომენის სპეციფიკური ABSA (ასპექტზე დაფუძნებული სენტიმენტის ანალიზი) მოდელების მცირე მონაცემებით (few-shot) წვრთნისთვის და კონკურენტუნარიანია, უმჯობესდება კიდეც გენერაციულ მოდელებს, როგორიცაა Llama2 და T5. მისი ძირითადი უპირატესობებია პრომპტების არარსებობა და სწრაფი წვრთნის შესაძლებლობა მცირე რაოდენობის ეტიკეტირებული

HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა

Cohere Hugging Face Hub-ზე: ინოვაციური AI მოდელები საწარმოებისთვის
კომპანია Cohere Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა, რაც პირველი შემთხვევაა, როდესაც მოდელის შემქმნელი პირდაპირ ემსახურება საკუთარ მოდელებს პლატფორმაზე. Cohere, თავისი ყოვლისმომცველი, უსაფრთხო AI გადაწყვეტილებებით, რომელიც მოიცავს გენერაციულ AI-ს, ემბედინგსა და რანჟირების მოდელებს, განკუთვნილია საწარმოო გამოყენებისთვის. მათი მოდელები, როგორებიცაა Command R+, Aya, Command R და Aya Vision, ახლა ხელმისაწვდომია უსერვერო ინფერენსისთვის, რაც ხაზს უსვამს მრავალენოვან მხარდაჭერას,
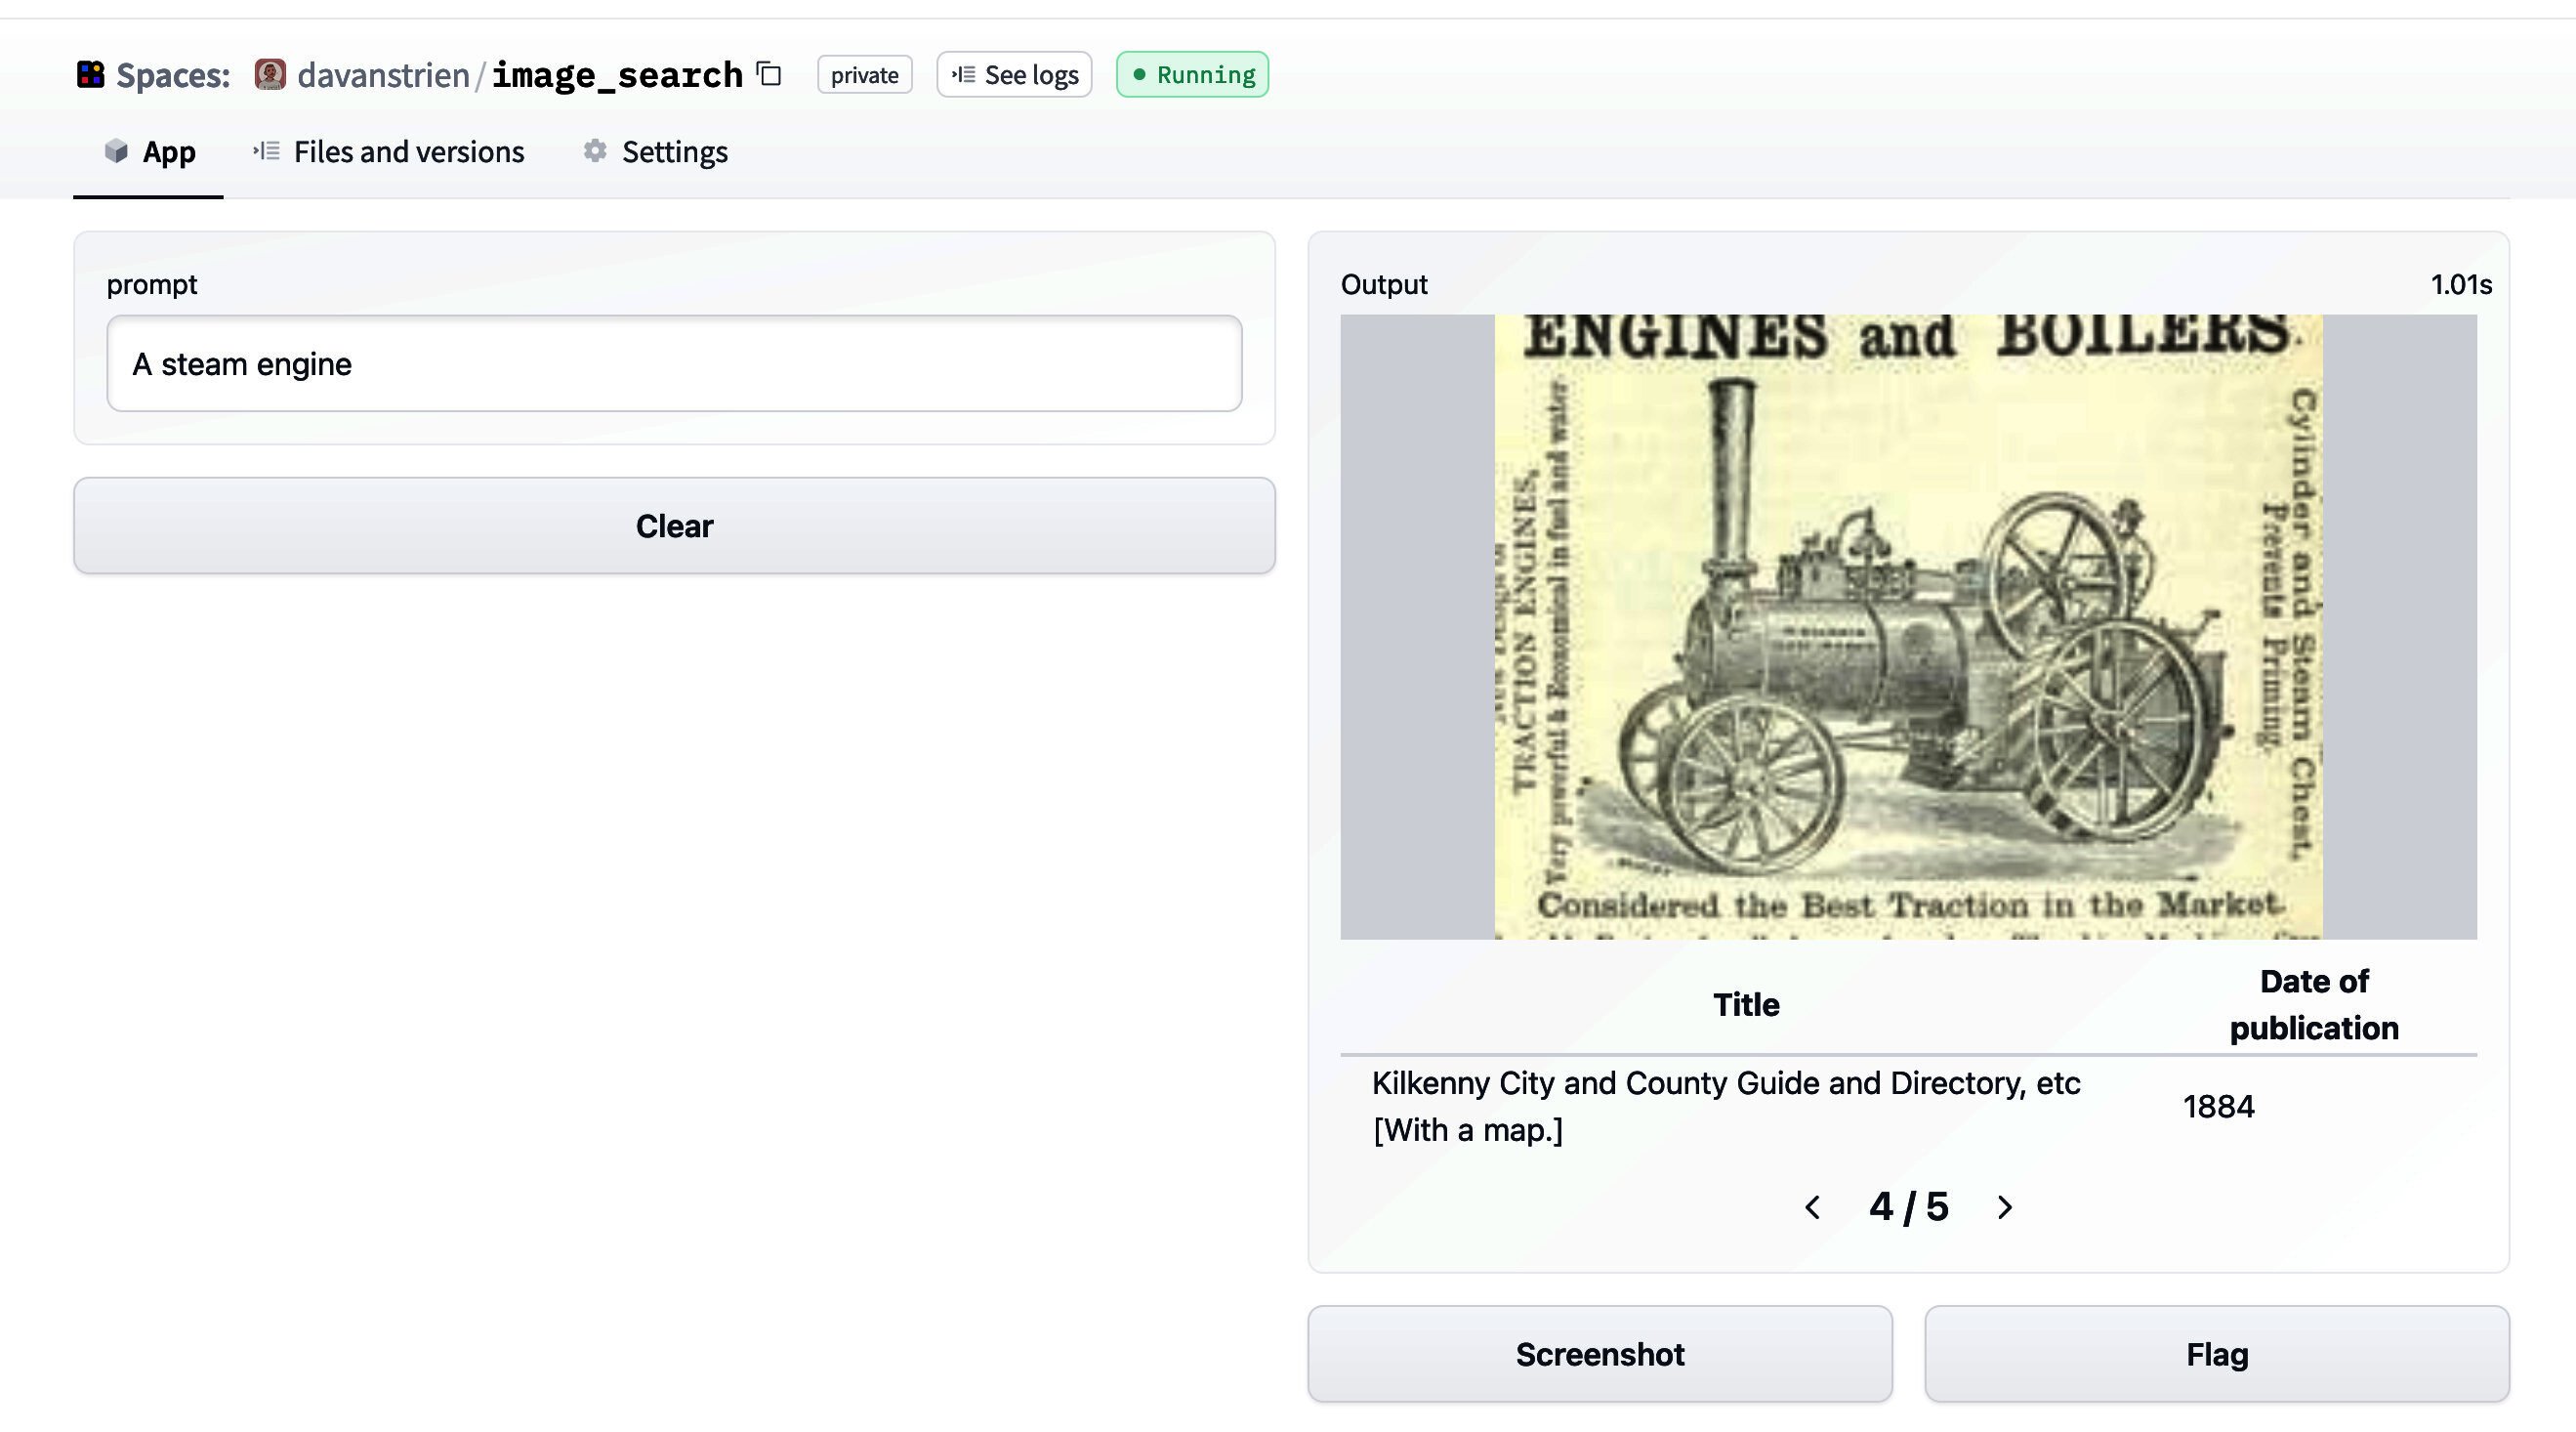
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.