როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო

Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის
Streamlit Hugging Face Spaces-ში: ML მოდელებისა და მონაცემთა ვიზუალიზაცია
ეს სტატია განმარტავს, თუ როგორ გამოიყენოთ Streamlit Hugging Face Spaces-თან ერთად მანქანური სწავლების მოდელების დემოების შესაქმნელად და მონაცემთა ნაკრებების ვიზუალიზაციისთვის. ის მოიცავს მოდელების ჰოსტინგს, ინტერფეისის აგებას, მონაცემთა სტრიმინგსა და ვიზუალიზაციის კომპონენტების გამოყენებას, მაგალითად, „Write with Transformer“-ის რეპლიკაციით.

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
მანქანური სწავლა ყველგან: როგორ ვაქციოთ AI საწარმოო რეალობად MLOps-ისა და ტრანსფორმერების დახმარებით
მანქანური სწავლისა (ML) და ხელოვნური ინტელექტის (AI) ფართო დანერგვის ფონზე, ტექსტი აყენებს კითხვას ინდუსტრიის მზაობის შესახებ ამ მასშტაბური განთავსებისთვის. ავტორი ხაზს უსვამს MLOps-ის მნიშვნელობას, რომელიც აერთიანებს პროგრამული ინჟინერიის საუკეთესო პრაქტიკებს (ვერსიონირება, ხელახალი გამოყენება, ტესტირება) მანქანური სწავლის სამუშაო პროცესებთან. იგი ამტკიცებს, რომ საჭიროა მეტი ML-ში გათვითცნობიერებული პროგრამული უზრუნველყოფის და DevOps ინჟინერი, ვიდრე უბრალოდ მონაცემთა მეცნიერი, რათა მოდელები წარ
ხელოვნური ინტელექტი და მისი განვითარება: გამოწვევები, MLOps-ის მნიშვნელობა და ტრანსფორმერების აღზევება
ხელოვნური ინტელექტი (ხი) და მანქანური სწავლება (მს) სულ უფრო ხშირად გამოიყენება კრიტიკულ ინფრასტრუქტურაში, თუმცა ჩნდება კითხვები ინდუსტრიის სიმწიფისა და მასშტაბური დანერგვის შესახებ. სტატია განიხილავს მყარი მს-სამუშაო პროცესების შექმნის აუცილებლობას, ხაზს უსვამს MLOps-ის, როგორც DevOps-ის გაგრძელების, მნიშვნელობას და ამტკიცებს, რომ პროგრამული უზრუნველყოფის და DevOps ინჟინრები, რომლებსაც ესმით მანქანური სწავლება, უფრო მეტად არიან საჭირო, ვიდრე უბრალოდ მონაცემთა მეცნიერები. ასევე, ყურადღება ექცევა
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე
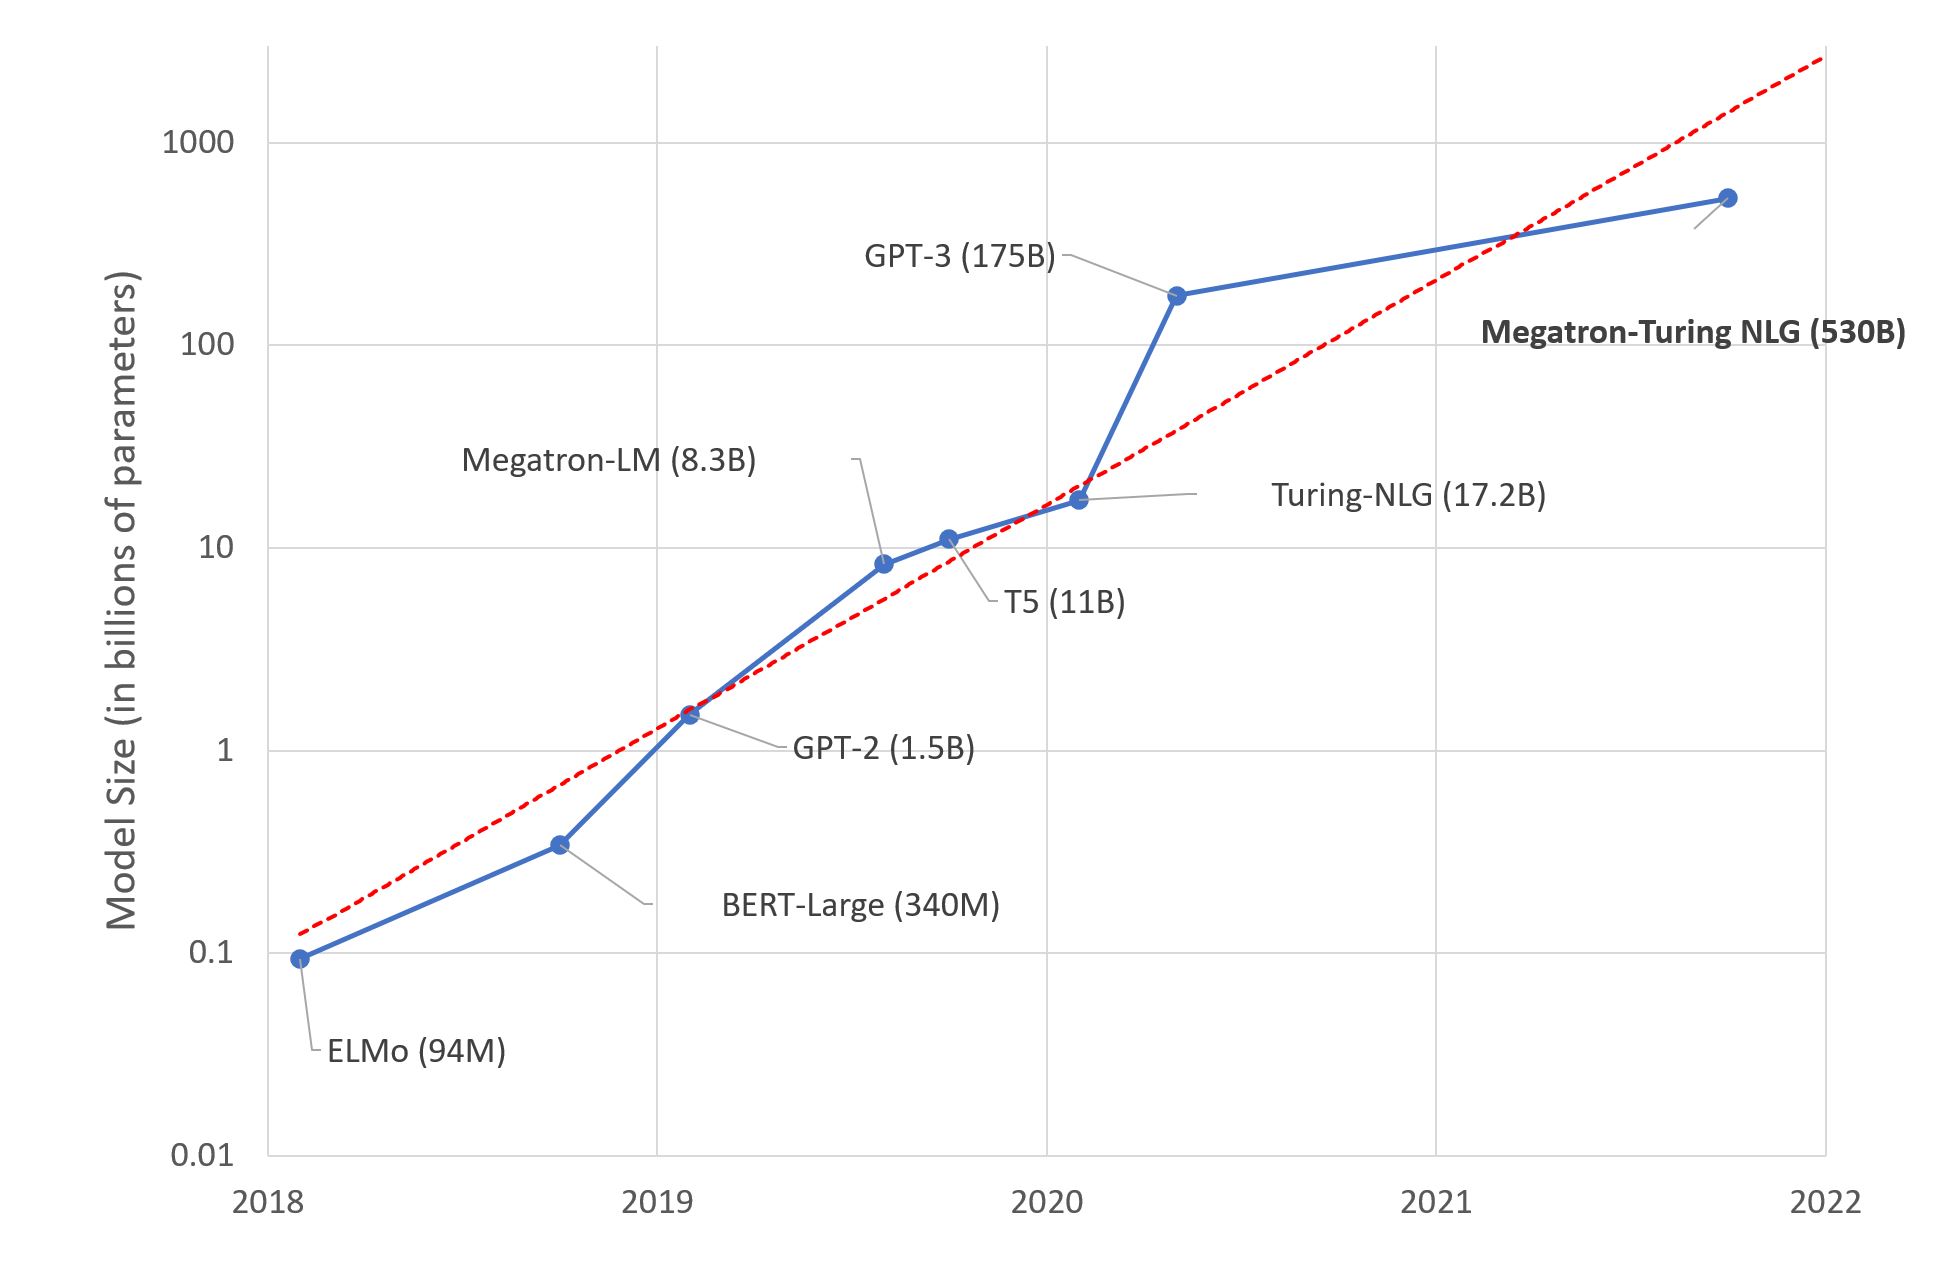
ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
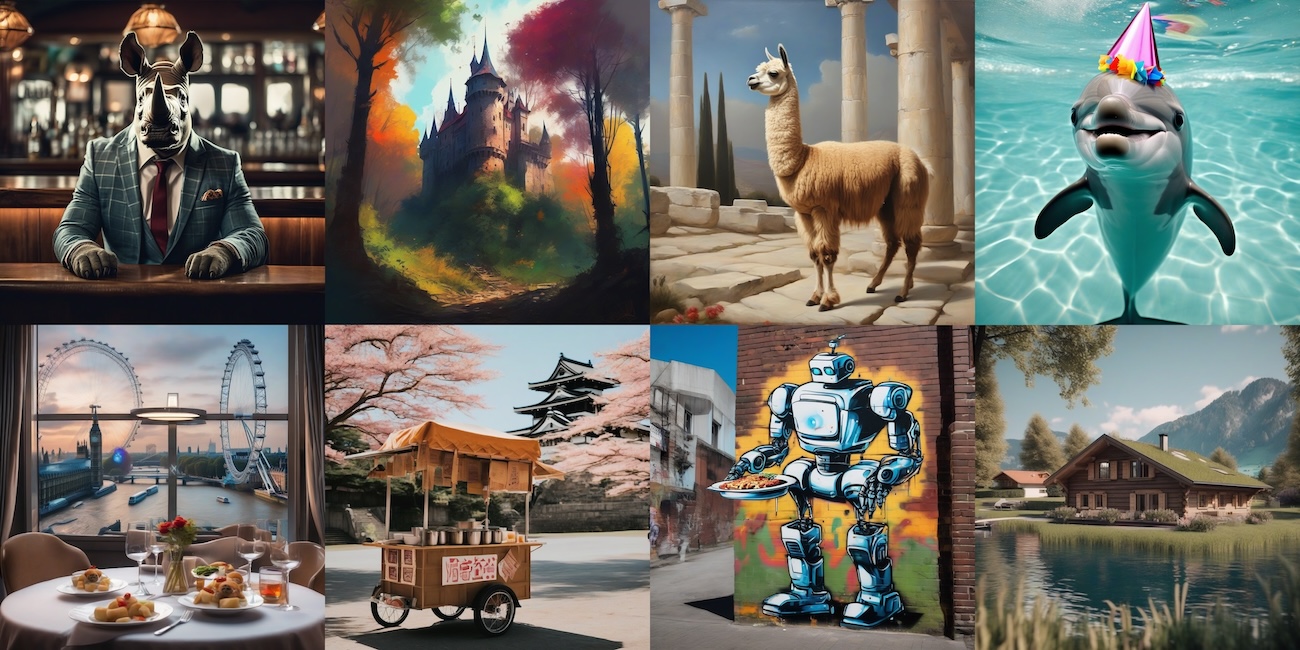
მაღალეფექტური და ხარჯთეფექტური SDXL სერვისინგი JAX-ით Google Cloud TPU v5e-ზე
Google Cloud-ის ახალი TPU v5e, JAX-თან და Diffusers-თან ერთად, შესაძლებელს ხდის დიდი ხელოვნური ინტელექტის მოდელების, მაგალითად SDXL-ის, მაღალპროდუქტიულ და ხარჯთეფექტურ ტრეინინგსა და ინფერენსს. სტატია მიმოიხილავს, თუ როგორ ხდის JIT კომპილაცია და XLA-ზე დაფუძნებული პარალელიზაცია მასშტაბურ გენერაციულ AI-ს ხელმისაწვდომსა და ეფექტურს, წარმოადგენს დემოს და განმარტავს ამ ტექნოლოგიების გამოყენების დეტალებს.
ხელოვნური ინტელექტის ღია მიდგომების წარმატება: რატომ არის ის სასიცოცხლოდ მნიშვნელოვანი?
ხელოვნური ინტელექტის (AI) განვითარებაში ღია მიდგომები არამხოლოდ უფრო გამჭვირვალე, ადაპტირებადი და მეცნიერულად დასაბუთებულია, არამედ მუდმივად აჭარბებს კომერციული შეთავაზებების წარმადობას. უახლესი მაგალითები, როგორიცაა OlympicCoder-ისა და OLMo 2-ის წარმატებები, ადასტურებს, რომ მძლავრი AI სტრატეგია ღია და კოლაბორაციულ განვითარებას უნდა ეფუძნებოდეს, რათა ხელი შეუწყოს ტექნოლოგიის წარმადობას, დანერგვასა და უსაფრთხოებას. სტატია გვთავაზობს სამ ძირითად რეკომენდაციას AI-ის ტექნიკური და ეკონომიკური წარმატე

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
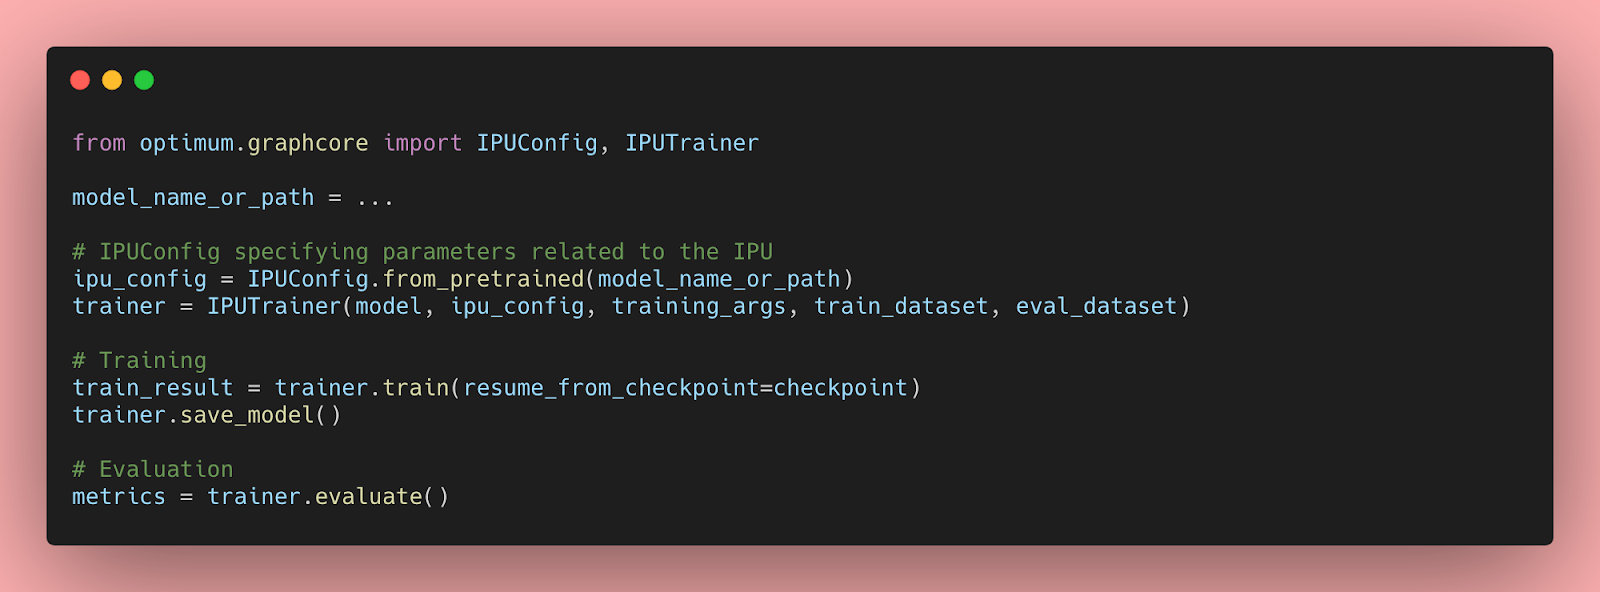
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.