Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.

Hugging Face-ის Trackio: ახალი ღია კოდის გადაწყვეტა მანქანური სწავლის ექსპერიმენტების თრექინგისთვის
Trackio არის Hugging Face-ის მიერ შემუშავებული ღია კოდის Python ბიბლიოთეკა მანქანური სწავლის მოდელების ვარჯიშის პროგრესის თრექინგისთვის. ის გვთავაზობს მარტივ გაზიარებას, მონაცემთა ხელმისაწვდომობას, ენერგიის მოხმარების გამჭვირვალობას და მოქნილობას ექსპერიმენტებისთვის. ბიბლიოთეკა, რომელიც თავსებადია ისეთ ინსტრუმენტებთან, როგორიცაა wandb, საშუალებას გაძლევთ ადვილად ვიზუალიზაცია მოახდინოთ Gradio დაფაზე და სინქრონიზაცია გაუკეთოთ Hugging Face Spaces-ს.
Hugging Face წარმოგიდგენთ Trackio-ს: ღია კოდის ბიბლიოთეკა ML ექსპერიმენტების მარტივი თვალთვალისთვის
Hugging Face-ის გუნდმა შეიმუშავა Trackio, ღია კოდის Python ბიბლიოთეკა მანქანური სწავლების ექსპერიმენტების თვალთვალისთვის. ის გამოირჩევა გაზიარების სიმარტივით, მონაცემთა ხელმისაწვდომობითა და მოქნილობით. Trackio იყენებს ლოკალურ Gradio დაფას, რომელიც შეიძლება სინქრონიზდეს Hugging Face Spaces-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ პროგრესი. ის ინტეგრირდება Hugging Face-ის სხვა ბიბლიოთეკებთან და მიზნად ისახავს საზოგადოების ჩართულობით განვითარებას, როგორც მსუბუქი და გამჭვირვალე ალ
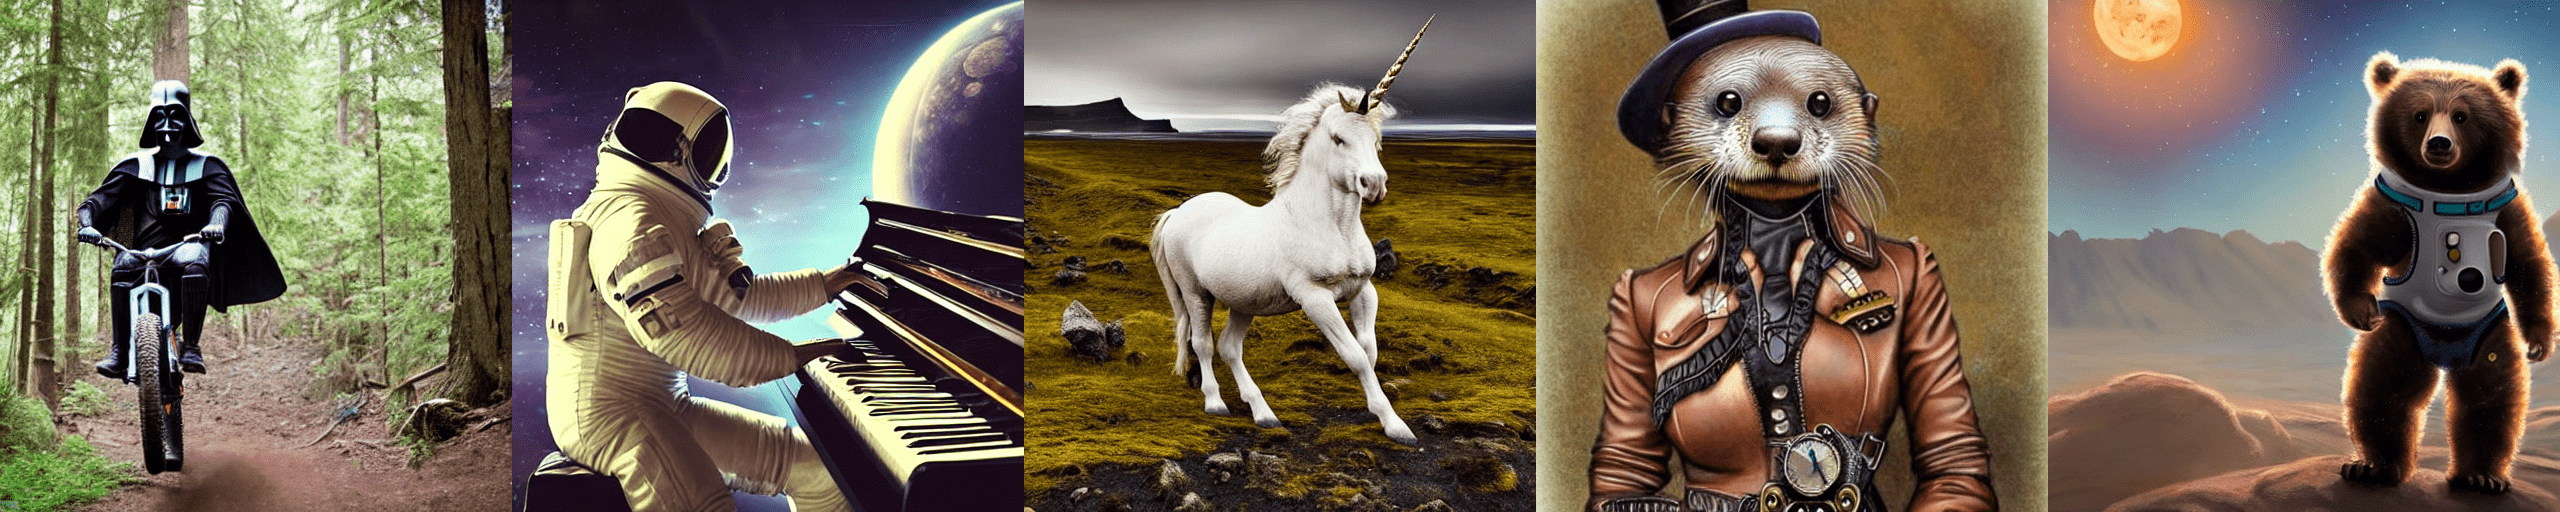
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g
დიდი ენობრივი მოდელები ჯანდაცვაში: პოტენციალი, გამოწვევები და შეფასების პლატფორმა
დიდი ენობრივი მოდელები (LLM) უდიდეს პოტენციალს ფლობს ჯანდაცვის სფეროს რევოლუციონიზაციისთვის, თუმცა მათ გამოყენებას თან ახლავს სერიოზული გამოწვევები სიზუსტისა და სანდოობის კუთხით, რადგან სამედიცინო შეცდომებმა შეიძლება სიცოცხლისთვის საშიში შედეგები გამოიწვიოს. ამ პრობლემების გადასაჭრელად შეიქმნა „Open Medical-LLM Leaderboard“, სტანდარტიზებული პლატფორმა, რომელიც აფასებს და ადარებს LLM-ების მუშაობას სხვადასხვა სამედიცინო ამოცანასა და მონაცემთა ბაზაზე (როგორიცაა MedQA, MedMCQA, PubMedQA, MMLU). მიზან

შექმენით AI შოპინგ ასისტენტი Gradio-თი: ვირტუალური მოზომება და ონლაინ დათვალიერება
პითონის დეველოპერებისთვის Gradio ამარტივებს მძლავრი MCP სერვერების იმპლემენტაციას. წარმოიდგინეთ: გძულთ შოპინგი დროის სიმცირის გამო და არ გიყვართ ტანსაცმლის მოზომება. ეს პოსტი გიჩვენებთ, როგორ შექმნათ ხელოვნური ინტელექტის ასისტენტი, რომელიც დაათვალიერებს ონლაინ მაღაზიებს, იპოვის სასურველ სამოსს და ვირტუალური მოზომების მოდელის გამოყენებით გაჩვენებთ, როგორ მოგიხდებათ ის. პროექტი აერთიანებს IDM-VTON-ს, Gradio-ს და Visual Studio Code-ის AI ჩატის ფუნქციას.
როგორ მოვახდინოთ ცილების სტრუქტურის ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js-ის გამოყენებით
ამ სტატიაში აღწერილია, თუ როგორ შეიძლება ცილის სტრუქტურების ინტერაქტიული ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js ბიბლიოთეკისა და Gradio-ს გამოყენებით. ცილები სასიცოცხლოდ მნიშვნელოვანია, ხოლო მანქანური სწავლა გვეხმარება ახალი ცილების შექმნაში. სტრუქტურის გაგება გადამწყვეტია მათი ფუნქციისთვის. სტატია დეტალურად განიხილავს დემო აპლიკაციის შექმნას PDB კოდის ან ფაილის გამოყენებით, ტექნიკურ ასპექტებს iframe-ებით და ბრაუზერის უსაფრთხოების წესებს. მოცემულია ინტეგრაციის მეთოდები ML მოდელებთან და მოწი

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც
ავარჯიშეთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი: როგორ აამუშავოთ Half-Cheetah
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს, თუ როგორ უნდა ავარჯიშოთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი ნულიდან. ის განმარტავს Decision Transformer-ის ძირითად კონცეფციას, რომელიც აძლიერებს სწავლის პრობლემას პირობით-თანმიმდევრობის მოდელირების ამოცანად გარდაქმნის გზით, რათა წარმოქმნას მომავალი ქმედებები სასურველი შედეგების, წარსული მდგომარეობებისა და ქმედებების საფუძველზე. გაკვეთილი ფოკუსირებულია ოფლაინ მიდგომაზე, Google Colab-ის, 🤗 Trainer-ის და სპეციალური მონაცემთა კოლატორის გამოყ
ოფლაინ გადაწყვეტილების ტრანსფორმატორის მოდელის გაწვრთნა: ნახევრად-გეპარდის სიმულაციის მიღწევა
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა გაწვრთნათ ოფლაინ გადაწყვეტილების ტრანსფორმატორის (Decision Transformer) მოდელი ნულიდან, რათა სიმულაციურ გარემოში ნახევრად-გეპარდმა შეძლოს მოძრაობა. განხილულია მოდელის ფუნდამენტური პრინციპები, რომელიც განმტკიცებით სწავლებას მიმდევრობის მოდელირების პრობლემად აღიქვამს და წარსული მონაცემებისა და სასურველი შედეგების საფუძველზე სამომავლო მოქმედებებს აგენერირებს. პრაქტიკული გაკვეთილი, რომელიც Google Colab-ზე სრულდება, ხსნის მონაცემთა დამუშავებასა და Hugging Fac

მოდელების ეფექტური ვარჯიში: პარალელიზმის სტრატეგიების მიმოხილვა Accelerate-სა და Axolotl-ში
ეს სტატია განიხილავს მოდელების ვარჯიშის პარალელიზმის სხვადასხვა სტრატეგიას, მათ შორის მონაცემთა პარალელიზმს (DP) და სრულად დაშარდულ მონაცემთა პარალელიზმს (FSDP), აქცენტს აკეთებს მათ მუშაობის პრინციპებზე, უპირატესობებსა და გამოყენების შემთხვევებზე. განხილულია, თუ როგორ შეიძლება ამ ტექნიკების ინტეგრირება Accelerate-სა და Axolotl-ის ბიბლიოთეკებში, როგორ უნდა მოხდეს მათი კომბინირება და რა გამოწვევები არსებობს დიდ მოდელებთან მუშაობისას, განსაკუთრებით კომუნიკაციის დანახარჯების მინიმიზაციის კუთხით მრავ
Stable Diffusion-ის რევოლუციური განახლებები: გამოსახულებიდან გამოსახულების გენერაცია, ოპტიმიზაცია და საზოგადოების წვლილი
Hugging Face-ის Stable Diffusion-ის უახლესი განახლებები მოიცავს დიდი ხნის ნანატრი ფუნქციებს, როგორიცაა გამოსახულებიდან გამოსახულების გენერაცია, ტექსტუალური ინვერსია და ინფეინთინგი. ასევე, წარმოდგენილია მნიშვნელოვანი ოპტიმიზაციები VRAM-ის გამოყენებისთვის, M1/M2 ჩიპების მხარდაჭერა და ONNX-თან თავსებადობა. გამოვიდა გაუმჯობესებული დოკუმენტაცია, ხოლო საზოგადოებამ შექმნა მრავალი ინოვაციური ინსტრუმენტი, როგორიცაა Stable Diffusion Videos და Waifu Diffusion.

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

Hugging Face-ის AI Sheets: ხელოვნური ინტელექტის უკოდო ინსტრუმენტი მონაცემთა ნაკრებების შექმნისა და მართვისთვის
Hugging Face-მა წარმოადგინა AI Sheets – ახალი, ღია წყაროს მქონე უკოდო ინსტრუმენტი, რომელიც მომხმარებლებს საშუალებას აძლევს შექმნან, გაამდიდრონ და გარდაქმნან მონაცემთა ნაკრებები ხელოვნური ინტელექტის მოდელების გამოყენებით. ის ინტეგრირებულია Hugging Face Hub-თან და გთავაზობთ ათასობით ღია მოდელის გამოყენების შესაძლებლობას სწრაფი ექსპერიმენტებისა და მონაცემთა დამუშავებისთვის. ინსტრუმენტი გამოირჩევა მარტივი, ცხრილის მსგავსი ინტერფეისით და ხელს უწყობს ეფექტურ მუშაობას როგორც მცირე, ისე მსხვილ მონაცემთა

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ
Hugging Face-ის ვალდებულება ეთიკური ხელოვნური ინტელექტისადმი: ღია თანამშრომლობა და ახალი საინფორმაციო ბიულეტენი
Hugging Face, რომელიც ღია წყაროს კომპანიად ჩამოყალიბდა, ტექნოლოგიების სფეროში ძირითადი ეთიკური ღირებულებების, როგორიცაა თანამშრომლობა, პასუხისმგებლობა და გამჭვირვალობა, საფუძველზეა დაფუძნებული. კომპანია აქტიურად ავითარებს ხელოვნური ინტელექტის (AI) ეთიკურ ასპექტებს, სადაც რეპროდუცირებადობა, აუდიტირებადობა და სისტემების გაგება ცენტრალურ ადგილს იკავებს. ამ ძალისხმევის ფარგლებში, Hugging Face-მა ახლახან გამოუშვა საინფორმაციო ბიულეტენი „ეთიკა და საზოგადოება“, რომელიც მიზნად ისახავს AI-ს ეთიკური საკით
Hugging Face-ის ეთიკური ხედვა ხელოვნურ ინტელექტში: მომავლის ფორმირება თანამშრომლობითა და გამჭვირვალობით
Hugging Face, რომელიც დაარსდა ეთიკურ პრინციპებზე (თანამშრომლობა, პასუხისმგებლობა, გამჭვირვალობა), აქტიურად ნერგავს ამ ღირებულებებს ხელოვნური ინტელექტის განვითარებაში. კომპანია ხაზს უსვამს ღიაობის, რეპროდუცირებადობის, აუდიტურობისა და გაგების მნიშვნელობას. ახალი ინიციატივებით, როგორიცაა „ეთიკისა და საზოგადოების“ ბიულეტენი, Hugging Face მიზნად ისახავს AI-ს მომავლის ფორმირებას, ეთიკური საკითხების გადაჭრას მთელი საზოგადოების ჩართულობით და ღია დისკუსიის ხელშეწყობით.

TextQuests: ახალი ბენჩმარკი ხელოვნური ინტელექტის აგენტების შესაძლებლობების შესაფასებლად
ახალი ბენჩმარკი, TextQuests, იყენებს 25 კლასიკურ Infocom-ის ინტერაქციულ მხატვრულ თამაშს, რათა შეაფასოს ხელოვნური ინტელექტის აგენტების უნარი, იმუშაონ ავტონომიურად რთულ საძიებო გარემოში. იგი ავლენს LLM-ების გამოწვევებს ხანგრძლივი კონტექსტის გაგებაში, როგორიცაა ჰალუცინაციები და სივრცითი მსჯელობის სირთულეები.
როგორ აძლიერებს Intel-ი RAG აპლიკაციებს OPEA პლატფორმაზე: Gaudi 2 და Xeon CPU-ები
ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) კრიტიკულად მნიშვნელოვანია დიდი ენობრივი მოდელებისთვის (LLM) ახალი ცოდნის ინკორპორირებისთვის, რაც აუმჯობესებს წარმადობასა და უსაფრთხოებას. Intel, OPEA პლატფორმის ფარგლებში, დეველოპერებს სთავაზობს სრულყოფილ გადაწყვეტილებებს RAG აპლიკაციების შესაქმნელად და ოპტიმიზაციისთვის. სტატია დეტალურად აღწერს Intel Gaudi 2 AI ამაჩქარებლებისა და Xeon CPU-ების როლს საწარმოო წარმადობის მნიშვნელოვნად გაზრდაში. ასევე განხილულია LangChain ფრეიმვორკის გამოყენება RAG ა