როგორ გავუშვათ მასშტაბური ენობრივი მოდელები მომხმარებლის აპარატურაზე: Hugging Face-ის Accelerate
Meta AI-მ და BigScience-მა ცოტა ხნის წინ საჯაროდ ხელმისაწვდომი გახადეს ძალიან დიდი ენობრივი მოდელები, რომლებიც მომხმარებლის უმეტესი აპარატურის მეხსიერებაში (RAM ან GPU) არ ეტევა. Hugging Face-ის Accelerate ბიბლიოთეკა გვთავაზობს ინოვაციურ გადაწყვეტებს, მათ შორის PyTorch-ის „მეტა მოწყობილობის“ გამოყენებას და ავტომატურ მოწყობილობათა რუკას, რათა შესაძლებელი გახდეს ამ მოდელების ეფექტურად ჩატვირთვა და გაშვება შეზღუდული RAM-ისა და GPU მეხსიერების პირობებშიც კი. ეს მეთოდები საშუალებას იძლევა უზარმაზარი
როგორ განვაახლოთ Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS ანგარიშის გამოყენებით
გაიგეთ, თუ როგორ უნდა განაახლოთ თქვენი Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS Marketplace-ის მეშვეობით, რათა ისარგებლოთ გაფართოებული უსაფრთხოების ფუნქციებით, წვდომის კონტროლით და ხელოვნური ინტელექტის კერძოდ და უსაფრთხოდ შექმნის შესაძლებლობით GDPR-თან შესაბამის და SOC2 Type 2 სერტიფიცირებულ პლატფორმაზე.

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ

განახლება, 2025 წლის ოქტომბერი: Claude-ის Hugging Face-თან დაკავშირება მოწინავე გამოსახულების გენერაციისთვის
სტატიაში დეტალურად არის აღწერილი, თუ როგორ დავაკავშიროთ Claude Hugging Face-ის MCP სერვერთან, რათა გამოვიყენოთ ხელოვნური ინტელექტის მოწინავე გამოსახულების გენერაციის მოდელები, როგორიცაა Krea და Qwen-Image. ეს აფართოებს Claude-ის შესაძლებლობებს რეალისტური ვიზუალის შექმნისა და ტექსტის ზუსტი რენდერინგის მიმართულებით, Anthropic-ის პოლიტიკის განახლების შემდეგ.

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
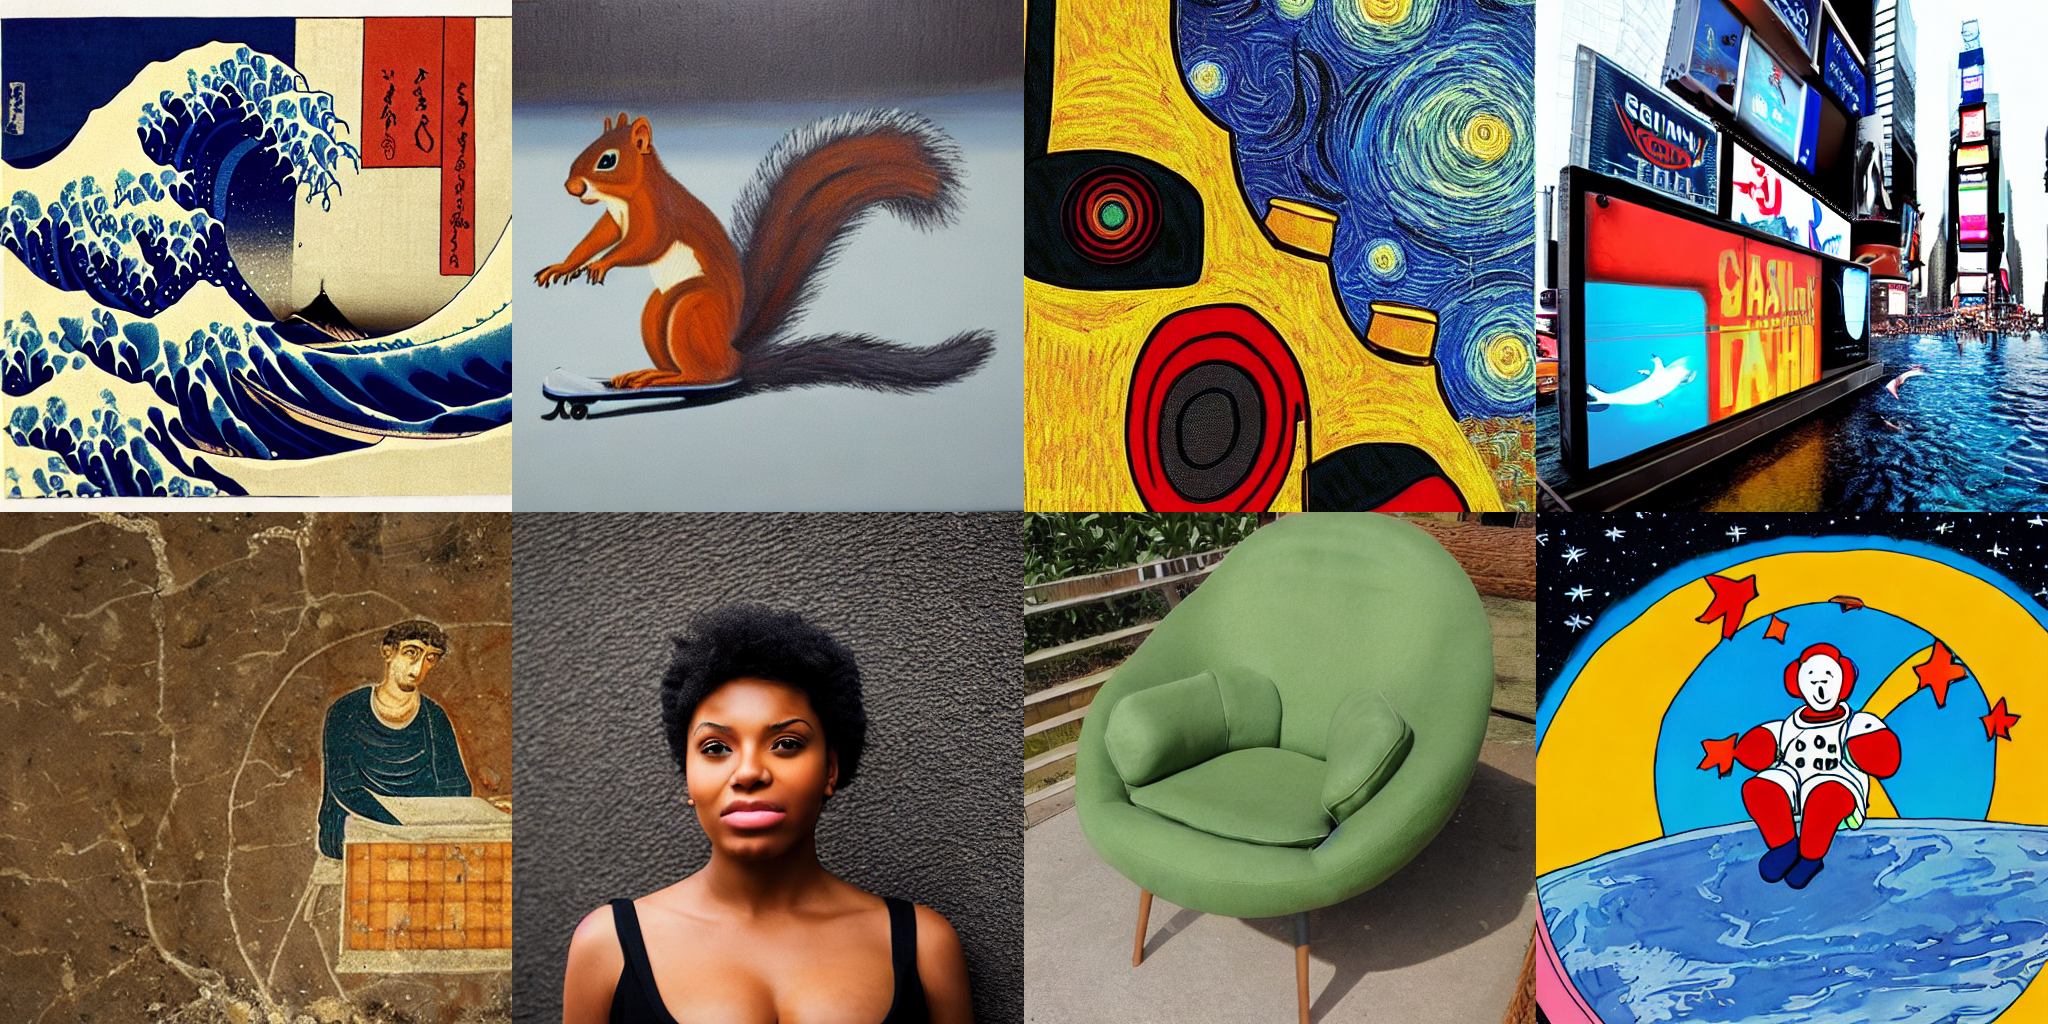
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ

PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა
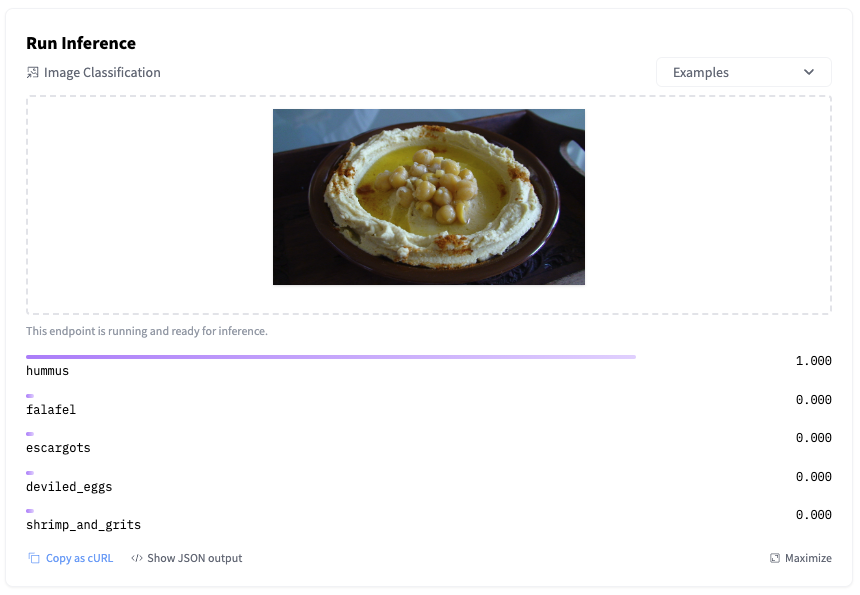
Hugging Face Inference Endpoints: ML მოდელების პროდუქციაში განთავსების გამარტივება
ეს სტატია განმარტავს, თუ როგორ ამარტივებს Hugging Face Inference Endpoints მანქანური სწავლების (ML) მოდელების პროდუქციაში განთავსების რთულ პროცესს. სერვისი საშუალებას გაძლევთ, რამდენიმე დაწკაპუნებით განათავსოთ მოდელები უშუალოდ Hugging Face Hub-იდან მართულ ინფრასტრუქტურაზე, რაც უზრუნველყოფს სიმარტივეს, უსაფრთხოებას და მასშტაბურობას. სტატია დეტალურად აღწერს, თუ როგორ ხდება დაცული და პირადი Endpoint-ების კონფიგურაცია AWS-ზე.
დღეს წარვადგენთ Dell Enterprise Hub-ს: ღია მოდელების მარტივი წვრთნა და განთავსება Dell-ის პლატფორმებზე
Dell Enterprise Hub, Hugging Face-ის ახალი შეთავაზება, ამარტივებს ღია ხელოვნური ინტელექტის მოდელების (როგორიცაა Llama 3 და Mixtral) ლოკალურ წვრთნასა და განთავსებას Dell-ის პლატფორმების გამოყენებით. ის კვირების საინჟინრო სამუშაოს წუთებამდე ამცირებს, გვთავაზობს შერჩეულ მოდელებს და უზრუნველყოფს უსაფრთხო, შესაბამის დახვეწასა და განთავსებას საწარმოს გარემოში.
Dell Enterprise Hub-ის გაშვება Hugging Face-ზე: ხელოვნური ინტელექტის მოდელების მარტივი ტრენინგი და განთავსება ადგილზე
Dell Technologies-ისა და Hugging Face-ის პარტნიორობის ფარგლებში, წარმოდგენილია Dell Enterprise Hub. ეს ახალი პლატფორმა საშუალებას აძლევს საწარმოებს, მარტივად მოამზადონ და განათავსონ ღია ხელოვნური ინტელექტის მოდელები საკუთარ ინფრასტრუქტურაზე (on-premises), Dell-ის პლატფორმების გამოყენებით. Dell Enterprise Hub მნიშვნელოვნად ამცირებს განთავსების დროს კვირებიდან წუთებამდე, უზრუნველყოფს მონაცემთა უსაფრთხოებას, კონფიდენციალურობასა და შესაბამისობას, და გთავაზობთ წვდომას უახლეს ღია მოდელებზე, როგორიცაა
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
Hugging Face-ის ბიბლიოთეკაში ენის მოდელების მიკერძოების შეფასების ახალი მეტრიკები დაემატა
Hugging Face-მა თავის 🤗 Evaluate ბიბლიოთეკას დაამატა ახალი მეტრიკები და საზომები, რომლებიც მიმართულია ენის მოდელებში (როგორიცაა GPT-2 და BLOOM) არსებული მიკერძოებების შესასწავლად. ეს ხელსაწყოები საშუალებას იძლევა შეფასდეს ტოქსიკურობა, პოლარობა და მტკივნეულობა (hurtfulness), რითაც ხელს უწყობს ენის მოდელებში დაშიფრული სოციალური საკითხების უკეთ გაგებას და მათთან ბრძოლას. სტატია დეტალურად განიხილავს ამ ხელსაწყოების გამოყენებას სხვადასხვა ამოცანებში.
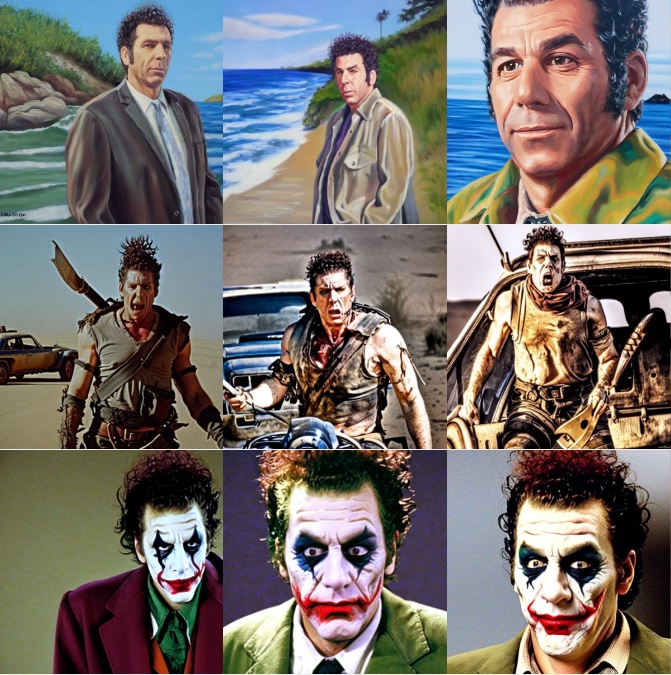
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტული მიგნებები და რჩევები Stable Diffusion-ისთვის
ამ პოსტში წარმოდგენილია Dreambooth-ის პარამეტრების ანალიზის შედეგები Stable Diffusion-ის დახვეწისას. მოცემულია რჩევები საუკეთესო შედეგების მისაღებად, მათ შორის სწავლის ტემპისა და სწავლის ნაბიჯების ოპტიმიზაცია, 'prior preservation' ტექნიკის გამოყენება, შესაბამისი განრიგის (scheduler) არჩევა (როგორიცაა DDIM) და ტექსტის ენკოდერის დახვეწის მნიშვნელობა, განსაკუთრებით სახეების დამუშავებისას. ხაზგასმულია მეთოდის ეთიკური გამოყენების აუცილებლობა.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.

Public AI Hugging Face Hub-ის მხარდაჭერილი გამოცნობის პროვაიდერი გახდა
Hugging Face Hub-მა გამოაცხადა Public AI-ის, როგორც ახალი მხარდაჭერილი გამოცნობის პროვაიდერის, ინტეგრაცია, რაც მნიშვნელოვნად აფართოებს სერვერული გამოცნობის შესაძლებლობებს. Public AI, არაკომერციული, ღია კოდის პროექტი, ხელს უწყობს საჯარო AI მოდელებზე წვდომას განაწილებული ინფრასტრუქტურის მეშვეობით. სტატია დეტალურად განმარტავს პლატფორმის გამოყენების პირობებს, მათ შორის უფასო წვდომასთან დაკავშირებულ შეზღუდვებს, ფასწარმოქმნას და Hugging Face-ის საკრედიტო სისტემას სხვადასხვა მომხმარებლისთვის.

AI თამაშებში: წარმოგიდგენთ NPC-Playground-ს - ახალი ერა ინტელექტუალური პერსონაჟებით
კომპანიებმა Cubzh-მა და Gigax-მა წარმოადგინეს NPC-Playground, დემო ვერსია, რომელიც გვიჩვენებს, თუ როგორ შეუძლიათ დიდ ენობრივ მოდელებს (LLM) შექმნან რეალისტური და ინტელექტუალური სათამაშო პერსონაჟები (NPC), რითაც მნიშვნელოვნად გაუმჯობესდება მოთამაშის გამოცდილება. ეს 3D დემო მომხმარებლებს საშუალებას აძლევს, იურთიერთონ NPC-ებთან და ასწავლონ მათ ახალი უნარები, რაც უდიდეს წინსვლას წარმოადგენს ტრადიციულ, წესებზე დაფუძნებულ სისტემებთან შედარებით.
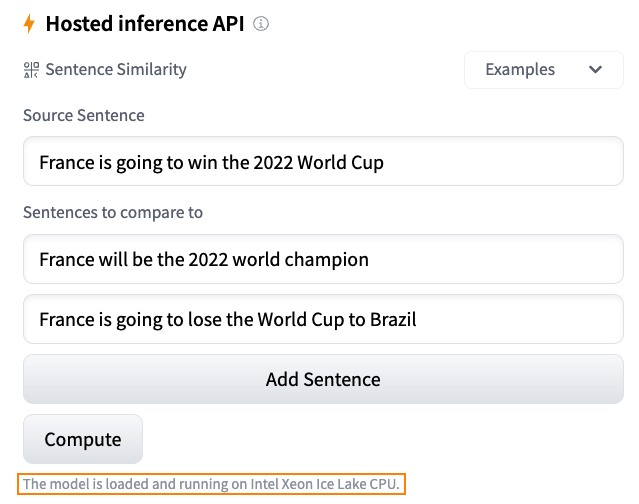
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.

Scaleway Hugging Face Hub-ის დასკვნის (Inference) პროვაიდერებს უერთდება
Scaleway, ღრუბლოვანი სერვისების წამყვანი პროვაიდერი, Hugging Face Hub-ის მხარდაჭერილი დასკვნის (Inference) პროვაიდერების ეკოსისტემას შეუერთდა. ეს ინტეგრაცია აფართოებს serverless inference-ის შესაძლებლობებს Hub-ზე, მომხმარებლებს უადვილებს წვდომას პოპულარულ ღია მოდელებზე, როგორიცაა gpt-oss, Qwen3 და Gemma 3. Scaleway გთავაზობთ კონკურენტულ ფასებს, ევროპულ მონაცემთა ცენტრებს და მოწინავე ფუნქციებს, რაც უზრუნველყოფს სწრაფ და უსაფრთხო AI ინფერენსს.
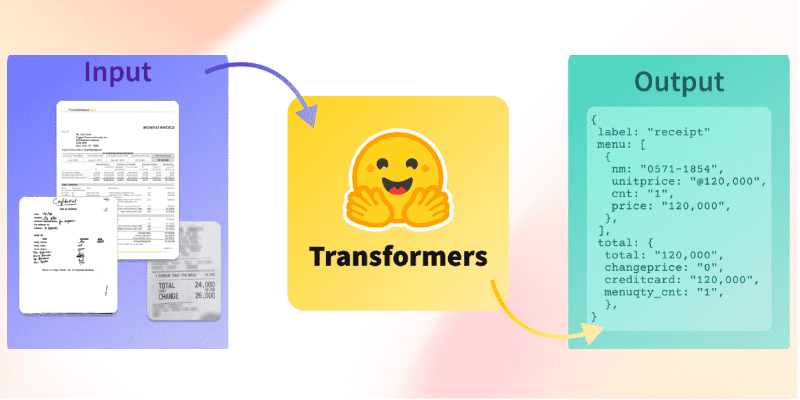
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.
მანქანური სწავლების გავლენა ინდუსტრიებზე: წამყვანი დირექტორების ხედვები
ეს სტატია წარმოგიდგენთ მანქანური სწავლების (ML) ლიდერთა შეხედულებების სერიის მეოთხე ნაწილს. მასში განხილულია, თუ რა გავლენას ახდენს ML სხვადასხვა ინდუსტრიაზე, ისეთი წამყვანი სპეციალისტების პერსპექტივიდან, როგორებიც არიან ხავიერ მანილა (Mercado Libre) და შონ გიტენსი (MasterPeace Solutions). ისინი საუბრობენ ML-ის გამოყენების მაგალითებზე ელექტრონულ კომერციაში, ფინტექში, მოწინავე ტექნოლოგიებსა და კიბერსერვისებში, ასევე გამოწვევებზე, ხშირ შეცდომებსა და სამომავლო ტენდენციებზე.