
ციფრული ინტერაქციის მომავალი: GUI ავტომატიზაცია ხედვა-ენის მოდელებით
ეს ბლოგ-პოსტი წარმოგიდგენთ მრავალფაზიან სტრატეგიას ხედვა-ენის მოდელების გასაწვრთნელად, რათა მიღწეულ იქნას გრაფიკული ინტერფეისის (GUI) ავტომატიზაცია. განხილულია, თუ როგორ შეიძლება მოდელების ტრანსფორმაცია, საწყისი დამიწების შესაძლებლობების გარეშე, აგენტურ კოდერებად, რომლებსაც შეუძლიათ ინტერფეისების გაგება და მათთან ურთიერთობა. ხაზგასმულია მონაცემთა დამუშავებიდან მოდელის ტრენინგამდე მიმავალი ყოვლისმომცველი პროცესი. მიდგომა ეფუძნება SmolVLM2-2.2B-Instruct მოდელს და მოიცავს მონაცემთა გაერთიანების პაი
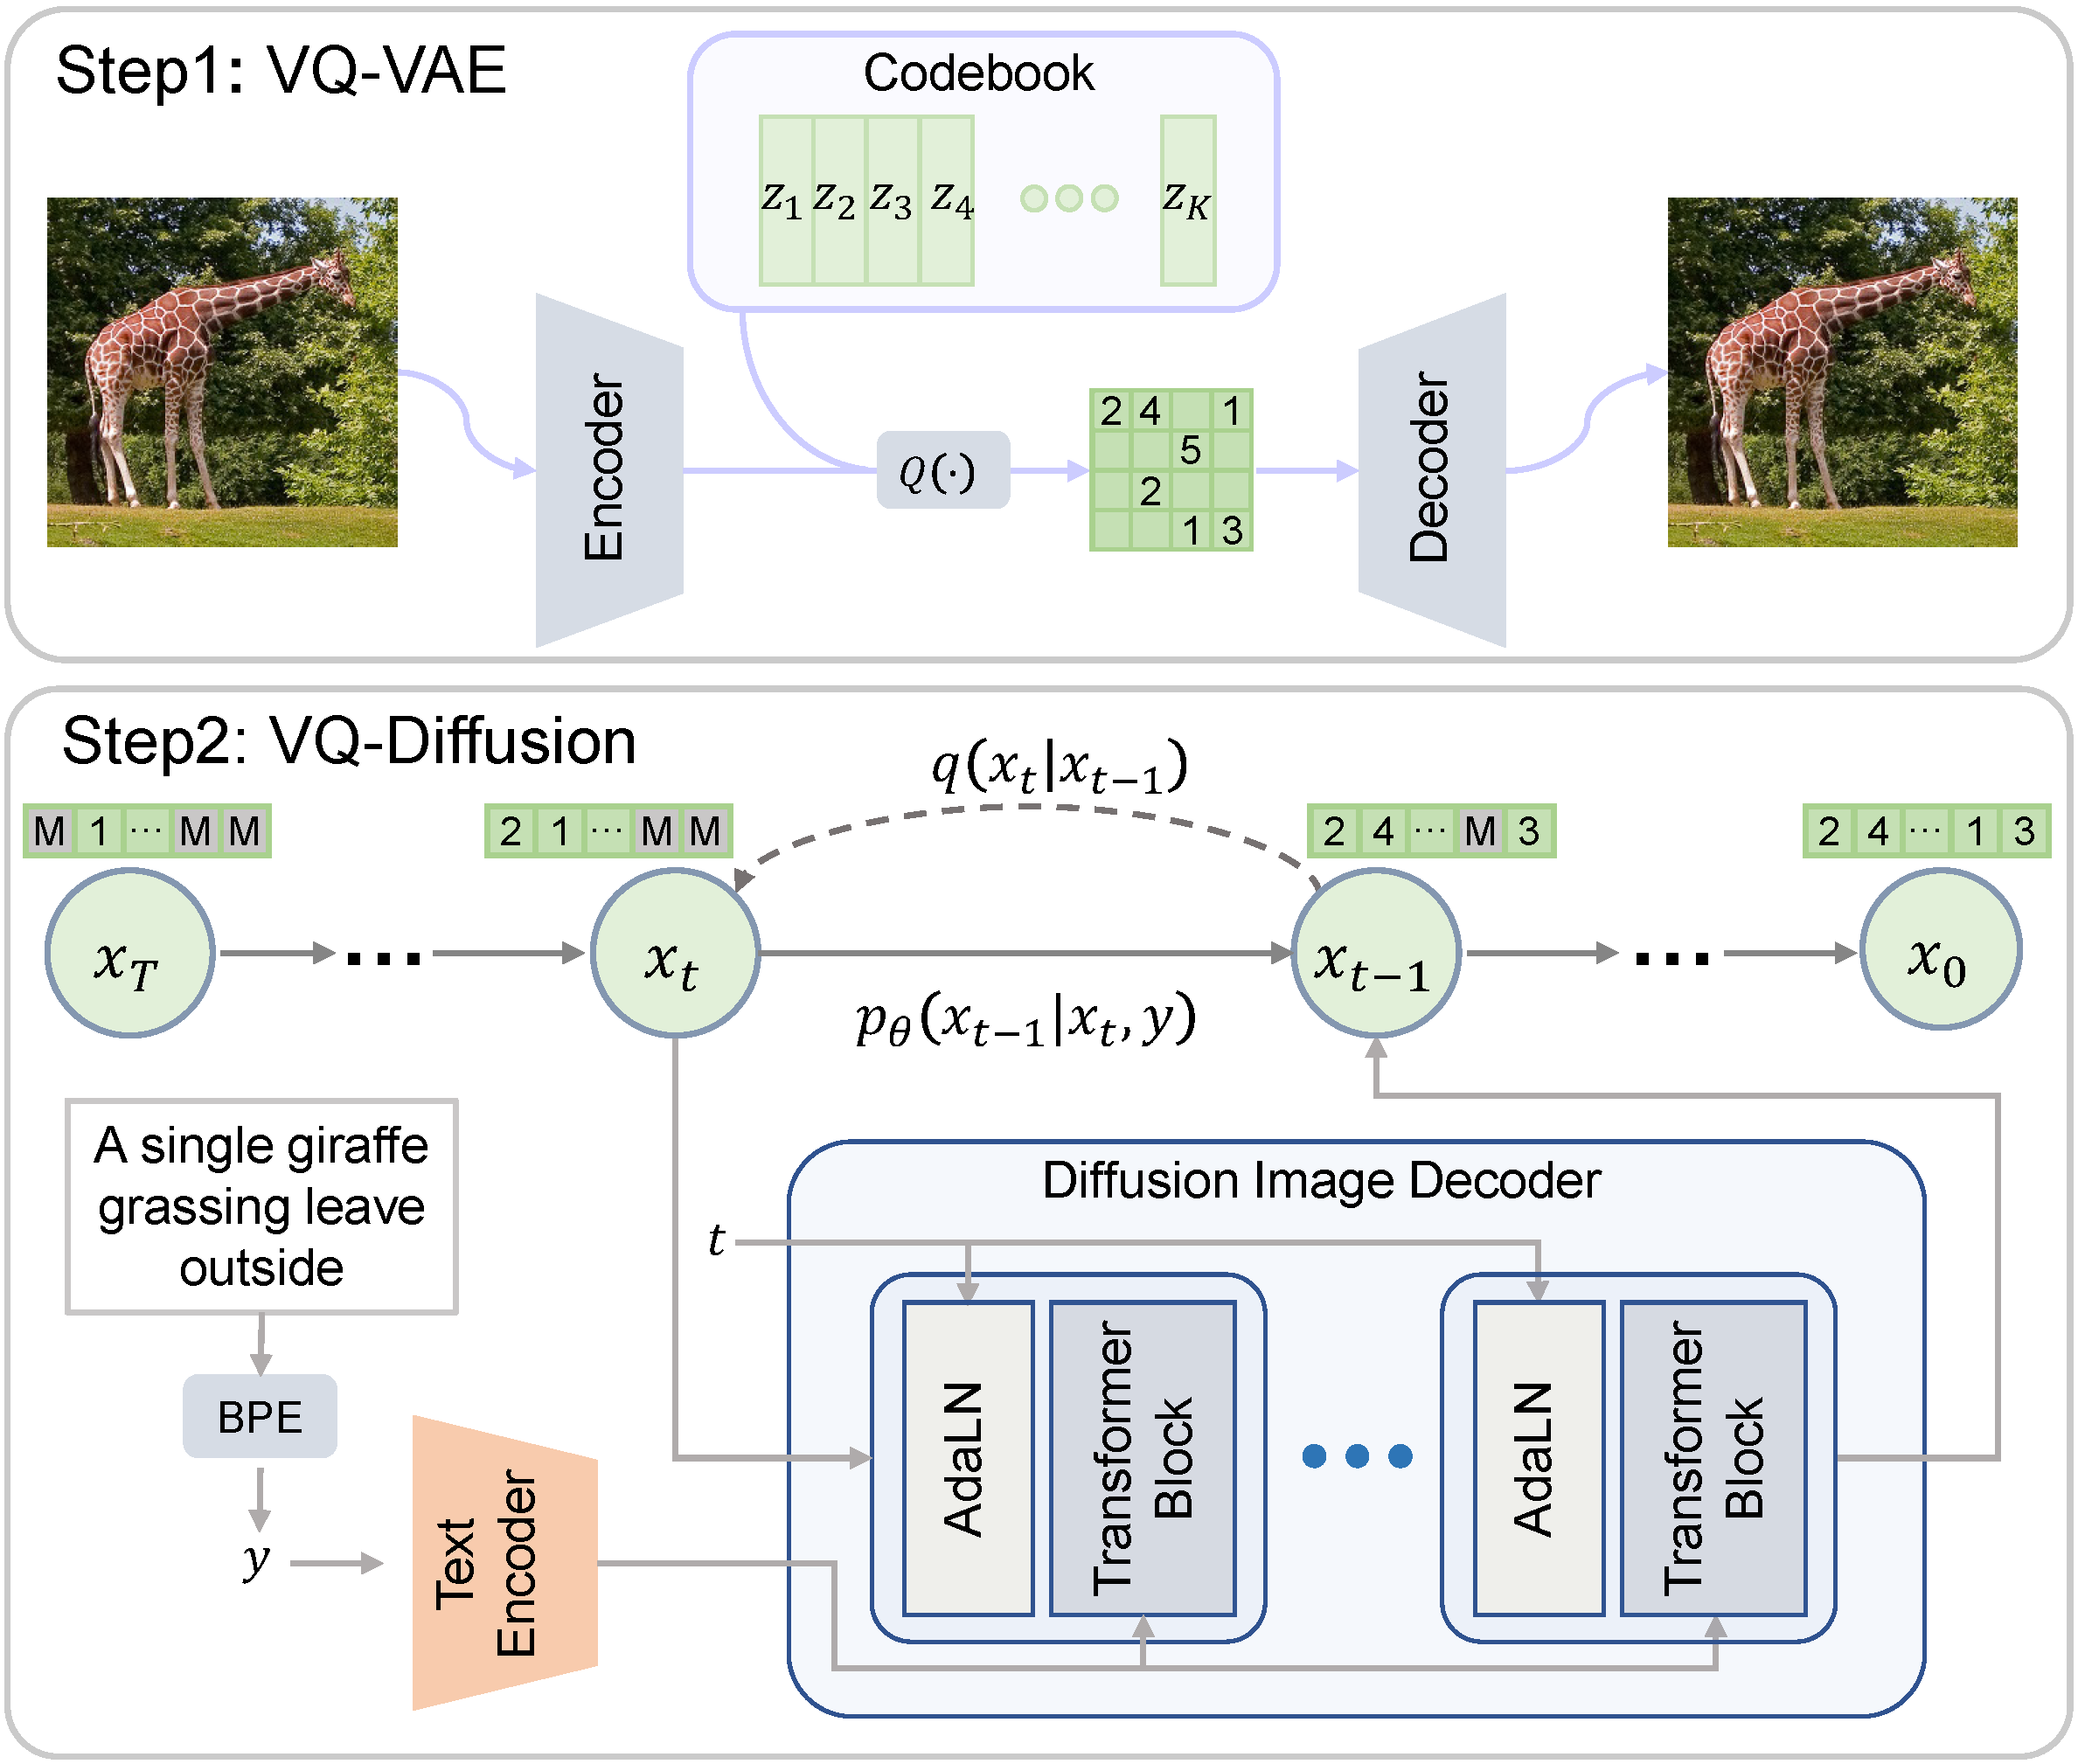
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა

RTEB: ახალი ბენჩმარკი ხელოვნური ინტელექტის მოდელების მოძიების ხარისხის საიმედო შეფასებისთვის
ხელოვნური ინტელექტის აპლიკაციების მუშაობა, როგორიცაა RAG და რეკომენდაციის სისტემები, მნიშვნელოვნად შეზღუდულია ძიებისა და მოძიების ხარისხით. დეველოპერებისთვის პრობლემას წარმოადგენს ემბედინგის მოდელების მოძიების ხარისხის ზუსტი გაზომვა, რადგან არსებული ბენჩმარკები ხშირად აჩვენებენ „განზოგადების ხარვეზს“ და არ შეესაბამებიან რეალურ საწარმოო გამოყენების შემთხვევებს. ამ გამოწვევების გადასაჭრელად შეიქმნა RTEB – ახალი, საიმედო ბენჩმარკი, რომელიც ზომავს მოძიების სიზუსტეს. ის იყენებს ჰიბრიდულ სტრატეგიას (ღ

მანქანური სწავლება Elixir-ში: ახალი შესაძლებლობები Bumblebee-სთან ერთად
Elixir-ის ეკოსისტემაში მანქანური სწავლების მხარდაჭერა მნიშვნელოვნად გაუმჯობესდა ისეთი პროექტების წყალობით, როგორებიცაა Nx, Axon, Explorer და, განსაკუთრებით, Bumblebee. Livebook პლატფორმაში ინტეგრირებული „Smart cells“-ის მეშვეობით, დეველოპერებს შეუძლიათ ნერვული ქსელების ამოცანების სწრაფად ინტეგრირება. Erlang ვირტუალური მანქანის კონკურენტულობისა და დისტრიბუციის წყალობით, ეს მოდელები ადვილად ინტეგრირდება არსებულ Elixir აპლიკაციებში, როგორიცაა Phoenix, Broadway და Nerves, და კომპილირდება როგორც CPU-

ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ
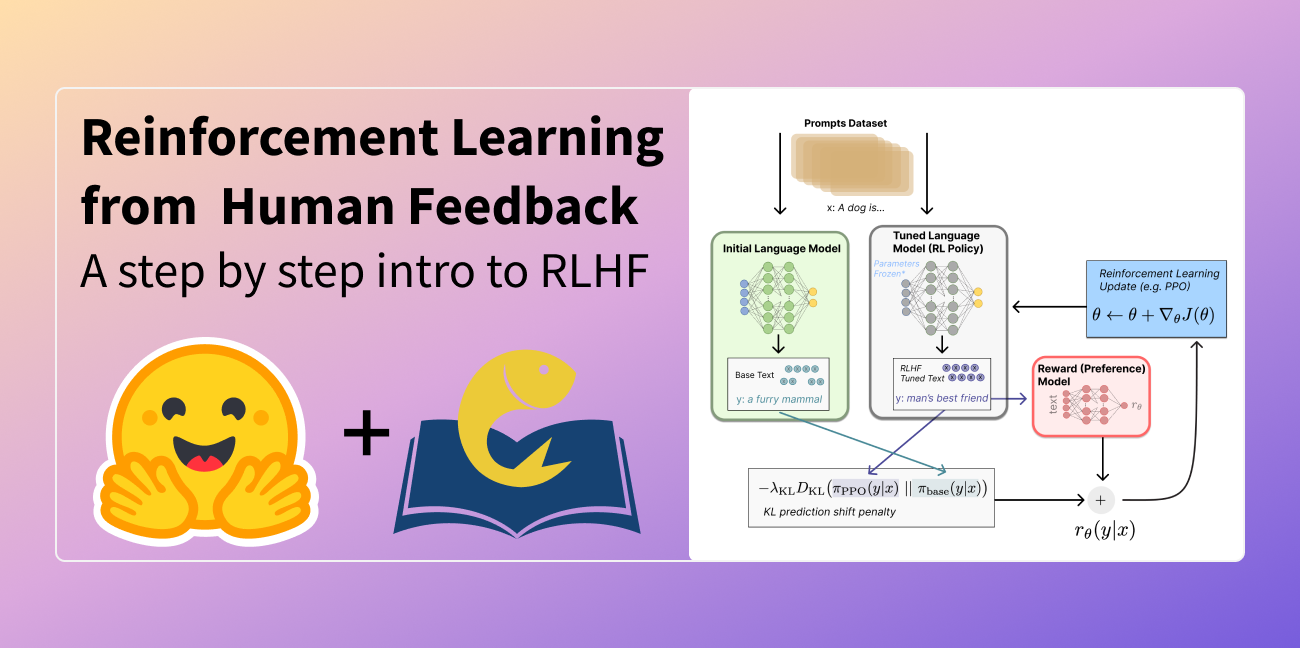
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,

Google-ის Gemma 2: ღია LLM-ების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
Google-მა წარმოადგინა Gemma 2, მისი ღია დიდი ენობრივი მოდელების (LLM) უახლესი ვერსია, ხელმისაწვდომი 9 და 27 მილიარდი პარამეტრის ზომებში. Gemma DeepMind Gemini-ზეა დაფუძნებული და გამოირჩევა მნიშვნელოვანი გაუმჯობესებებით, მათ შორის გაორმაგებული საწვრთნელი მონაცემებით (13 ტრილიონი ტოკენი 27B ვერსიისთვის), ოპტიმიზებული დიალოგური აპლიკაციებისთვის და ახალი არქიტექტურული ინოვაციებით, როგორიცაა ჰიბრიდული მოძრავი ფანჯრის ყურადღება (sliding window attention) და რბილი ზღვრის დადგენა (soft capping). მოდელი
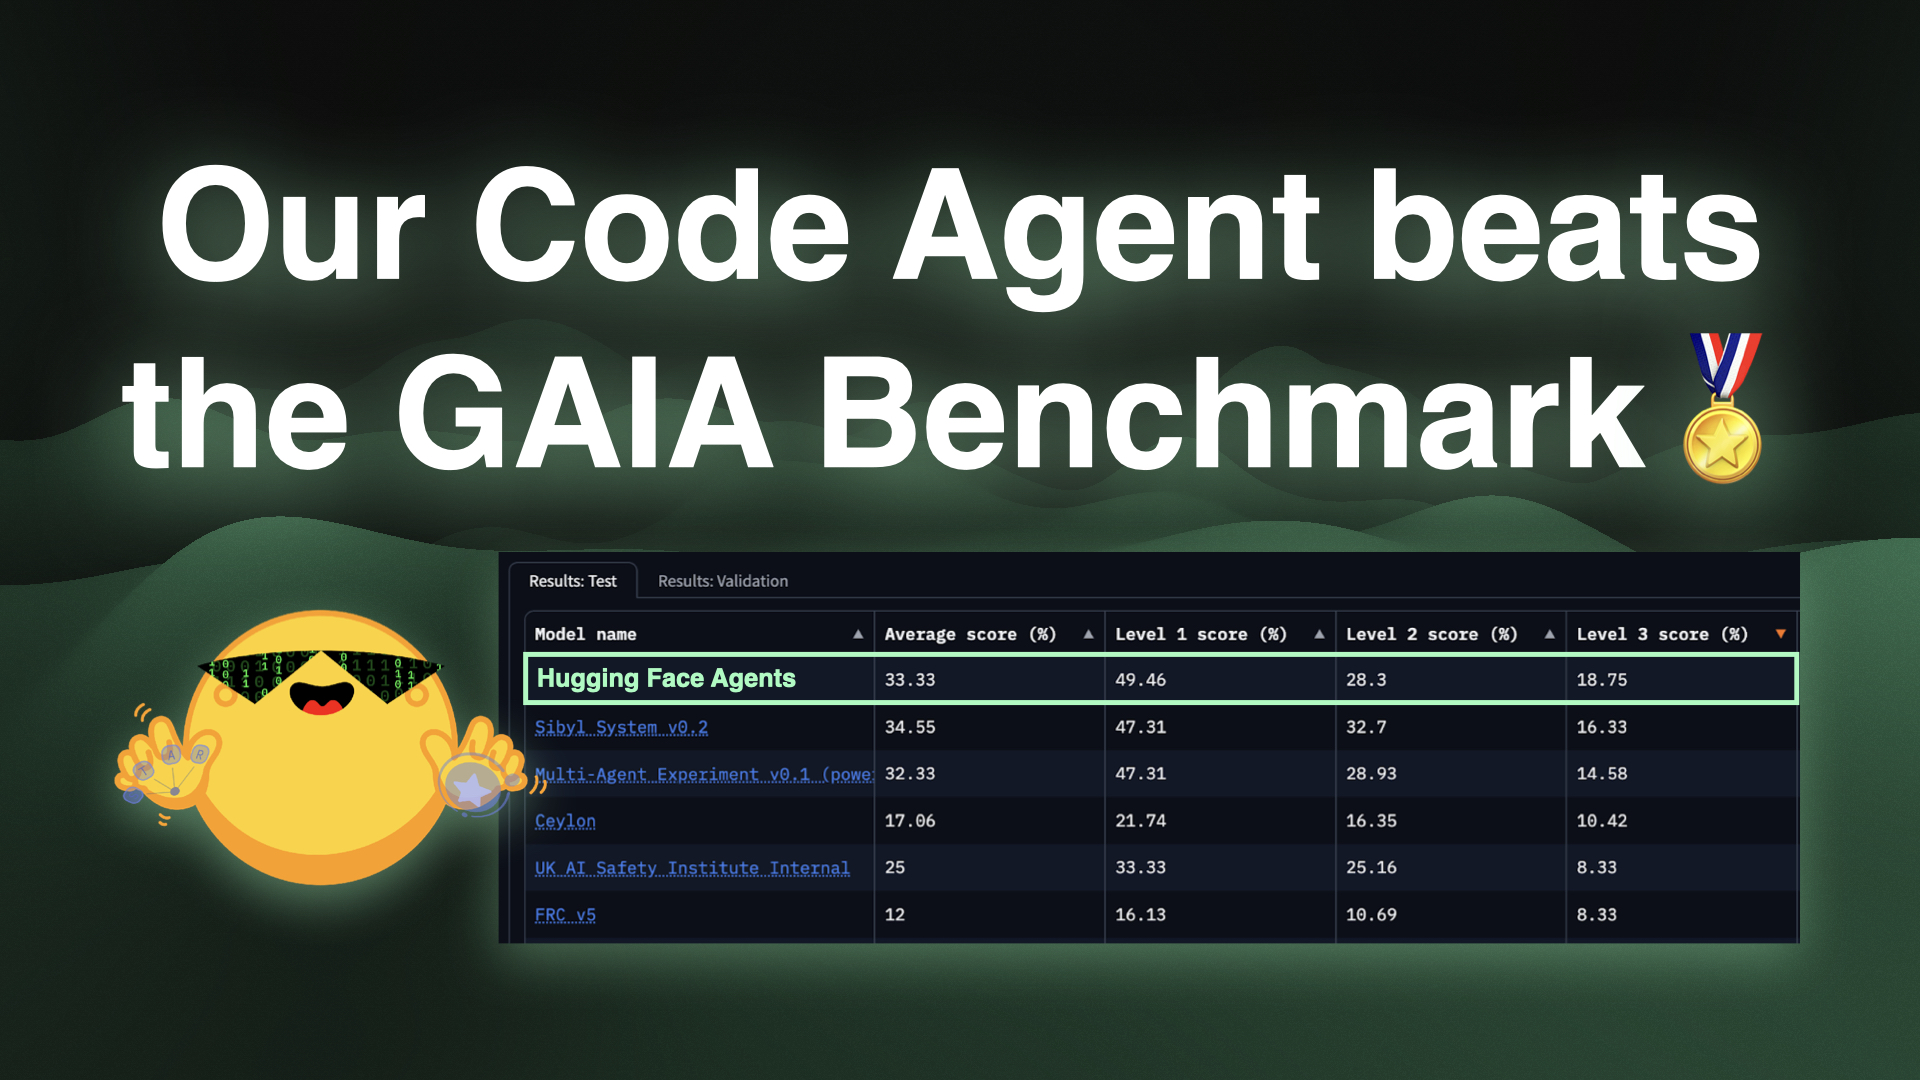
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ

ხელოვნური ინტელექტის როლი კვებითი ალერგიების კვლევასა და მკურნალობაში
ბიოსამედიცინო კვლევებმა და ხელოვნურმა ინტელექტმა ბოლო წლებში მნიშვნელოვან პროგრესს მიაღწიეს. ეს მიღწევები განსაკუთრებით შთამბეჭდავია კვებითი ალერგიების გაგების, პროგნოზირებისა და მკურნალობის კონტექსტში. სტატია აღწერს, თუ როგორ ცვლის AI პროტეინების სტრუქტურის პროგნოზირებას (მაგ., AlphaFold), აჩქარებს წამლის აღმოჩენას, აუმჯობესებს დიაგნოსტიკურ ხელსაწყოებს და უზრუნველყოფს კვების პროდუქტების უსაფრთხოებას, ეტიკეტების ანალიზის ჩათვლით. პროექტი „AI კვებითი ალერგიებისთვის“ მიზნად ისახავს საზოგადოებაზე ო
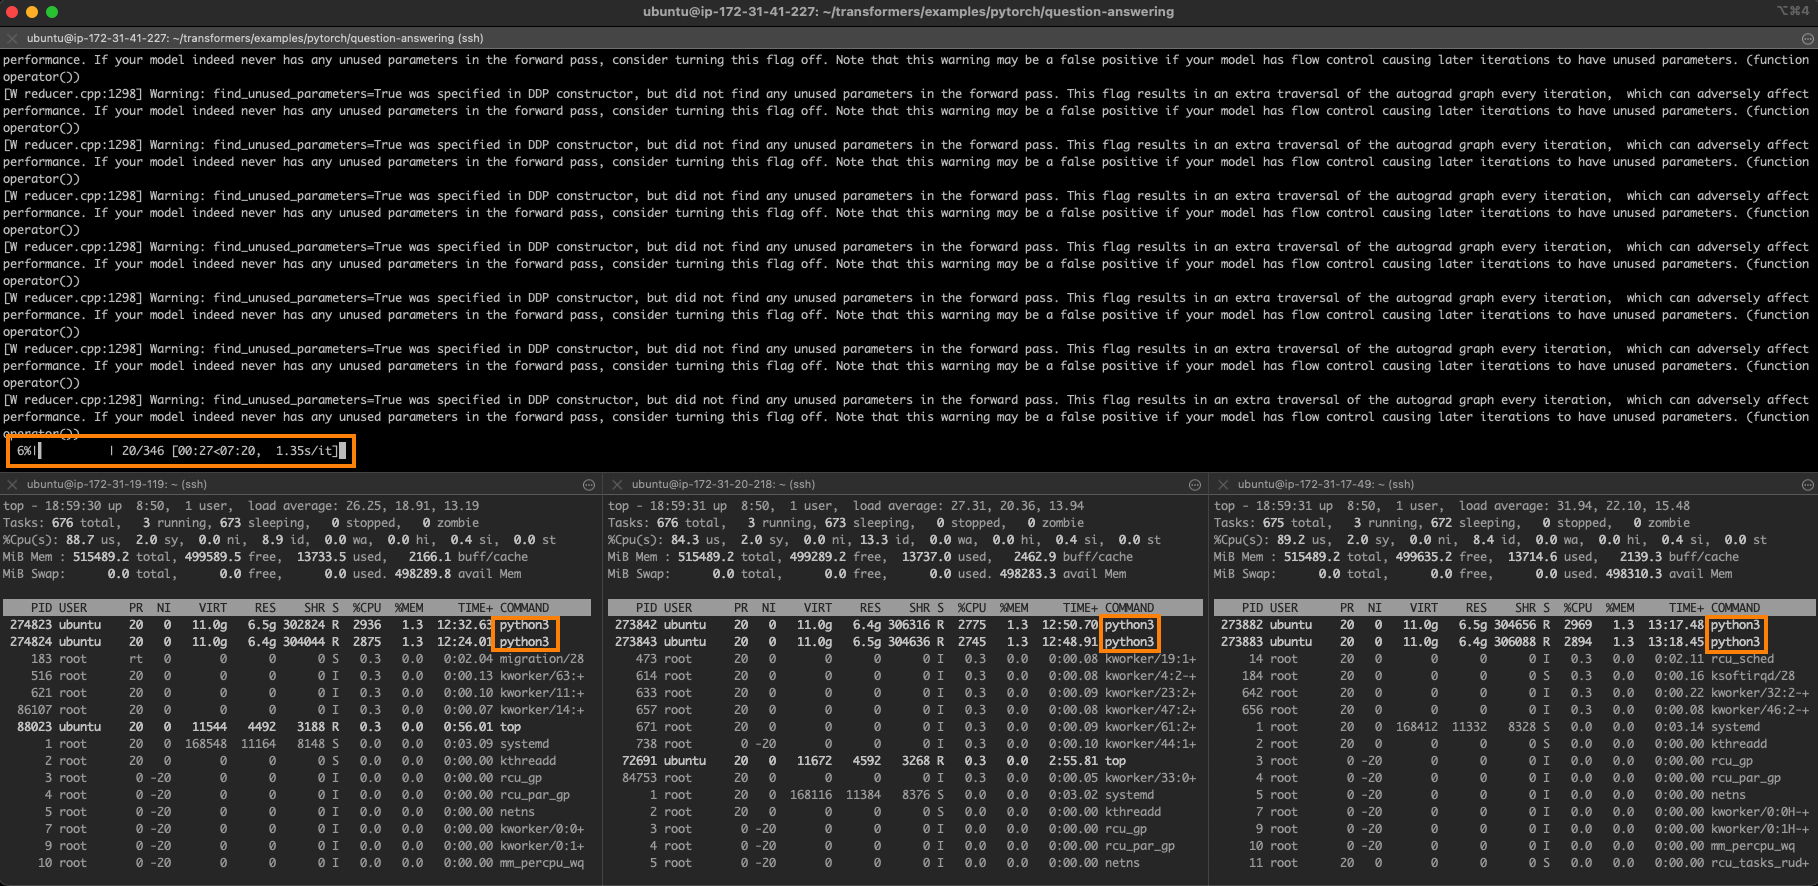
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც
თამაშების დიზაინი AI-ის დახმარებით: Stable Diffusion და Unity
ეს სტატია გთავაზობთ სახელმძღვანელოს, თუ როგორ გამოვიყენოთ Stable Diffusion ხელოვნური ინტელექტის მოდელი, რათა შევქმნათ უნიკალური ვიზუალური სტილი ჩვენი თამაშისთვის, კერძოდ კი სოფლის მეურნეობის სიმულატორისთვის Unity-ში. განხილულია Stable Diffusion-ის ლოკალურად ან ონლაინ გაშვების მეთოდები, პრომპტინგის რჩევები და საბოლოოდ, კონცეპტუალური ხელოვნების ინტეგრაცია Unity-ში.

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ