
LangChain და Hugging Face-ის პარტნიორობა: AI მოდელების ინტეგრაციის გაუმჯობესება
LangChain და Hugging Face ოფიციალურად გაერთიანდნენ, რათა მნიშვნელოვნად გააუმჯობესონ Hugging Face-ის მოდელების ინტეგრაცია LangChain-ის ეკოსისტემაში. ეს პარტნიორობა მიზნად ისახავს Hugging Face-ის ეკოსისტემაში არსებული ახალი ფუნქციების LangChain-ის მომხმარებლებისთვის უფრო სწრაფად მიწოდებას და მოძველებული კლასების პრობლემის გადაჭრას. ახალი `langchain-huggingface` პაკეტი უზრუნველყოფს მოდელების ეფექტურ გამოყენებას ტექსტის გენერირების, შეჯამებისა და თარგმანის ამოცანებში, გვთავაზობს მარტივ ინსტალაციას,
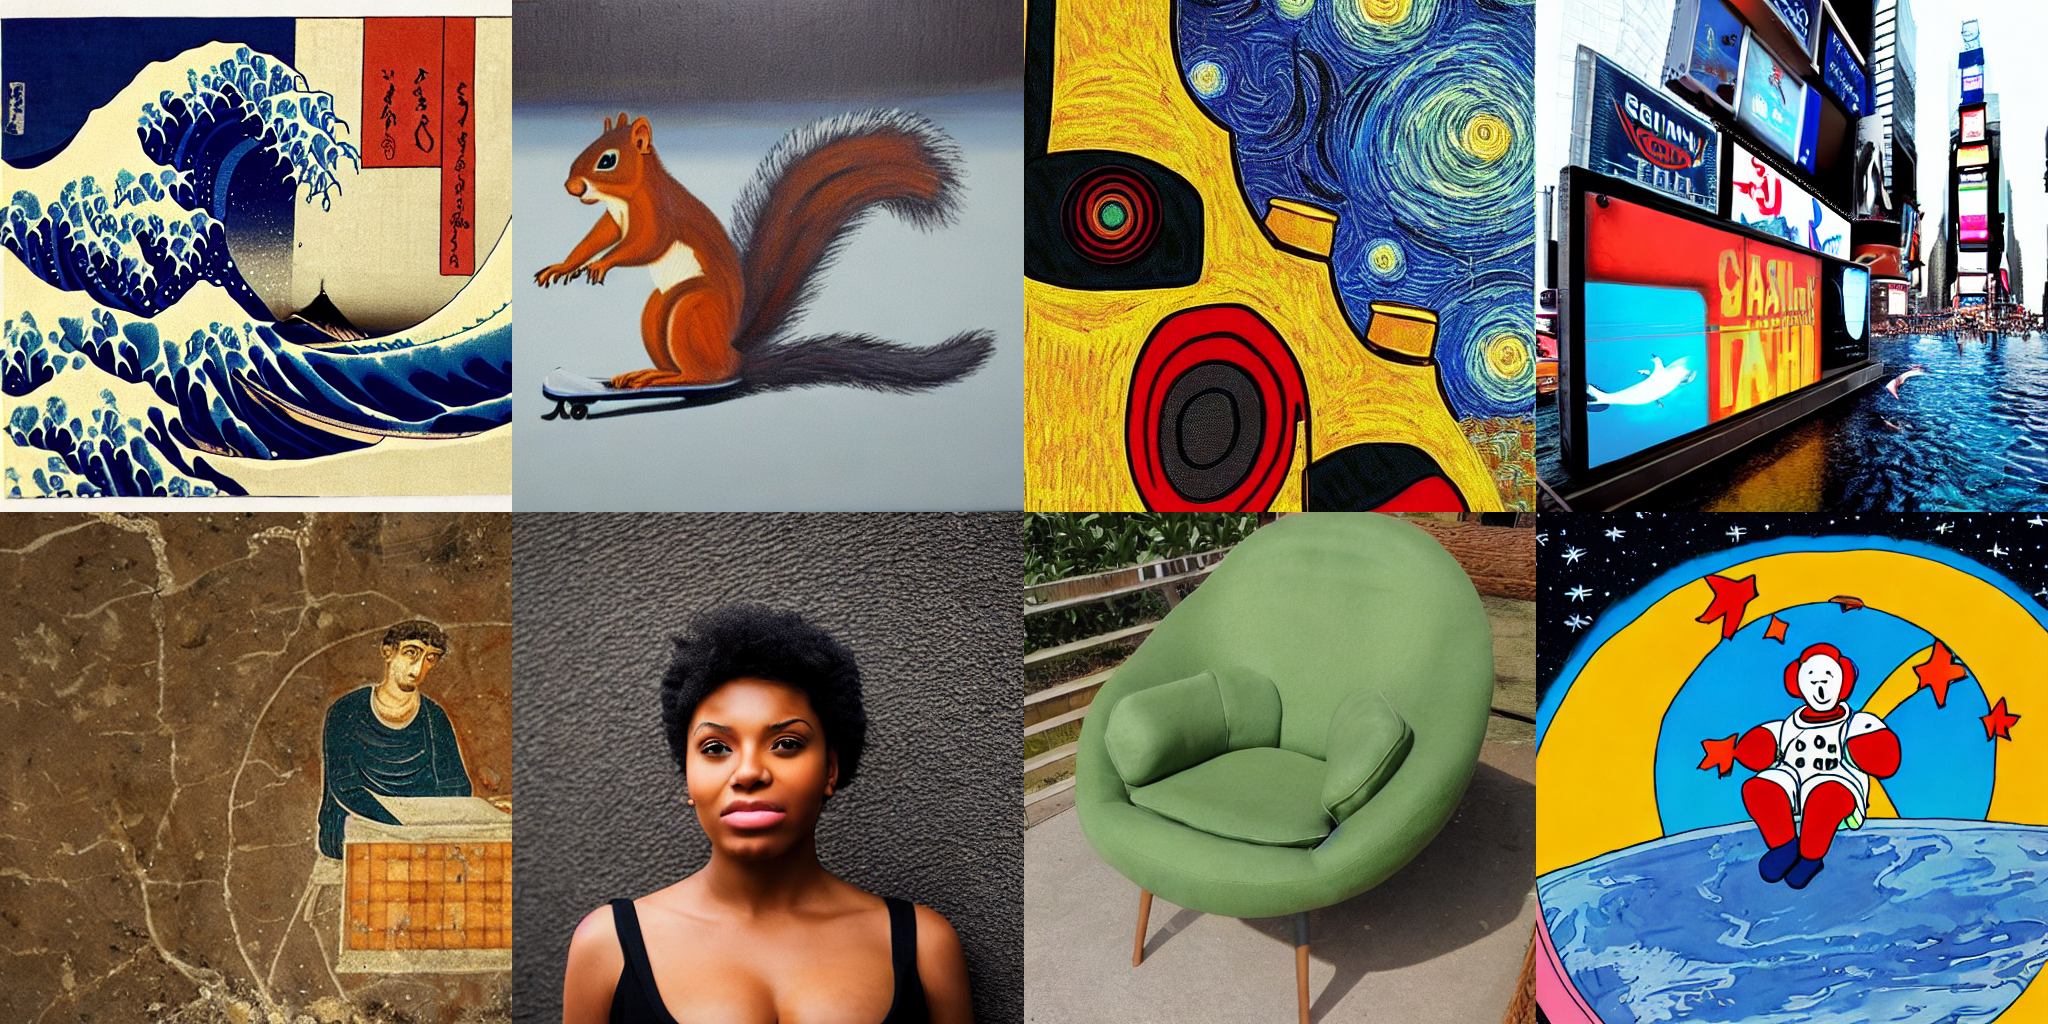
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ
Microsoft-ისა და Hugging Face-ის თანამშრომლობა Azure-ზე ხელოვნური ინტელექტის შექმნას ამარტივებს
Microsoft და Hugging Face აცხადებენ თანამშრომლობის გაღრმავებას, რაც მომხმარებლებს საშუალებას აძლევს, Azure-ზე ღია მოდელებით ხელოვნური ინტელექტი (AI) უფრო მარტივად ააწყონ. სიახლეები მოიცავს პოპულარული დიდი ენობრივი მოდელების (LLM) პირდაპირ ინტეგრაციას Azure AI Studio-ში, ახალი AMD Instinct MI300 GPU-ზე დაფუძნებული ვირტუალური მანქანების ხელმისაწვდომობას მაღალი წარმადობისთვის და Hugging Face Spaces-ის ინტეგრაციას VS Code-თან, რაც დეველოპერებისთვის AI აპლიკაციების შექმნას საგრძნობლად აჩქარებს.

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ

Google-მა გამოუშვა EmbeddingGemma: უახლესი მულტილინგვური ჩაშენების მოდელი მოწყობილობებისთვის
Google-მა წარადგინა EmbeddingGemma, უახლესი მულტილინგვური ჩაშენების მოდელი, რომელიც ოპტიმიზებულია მოწყობილობებზე გამოსაყენებლად. 308 მილიონი პარამეტრით და 2K კონტექსტური ფანჯრით, ის მხარს უჭერს 100-ზე მეტ ენას და MTEB ბენჩმარკზე 500M-ზე ნაკლებ მოდელებს შორის ყველაზე მაღალრეიტინგულია. მოდელი შექმნილია სიჩქარისა და ეფექტურობისთვის, მნიშვნელოვნად აფართოებს მობილური RAG კონვეიერების შესაძლებლობებს და ინტეგრირებულია პოპულარულ AI ხელსაწყოებთან.

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის
Intel-ი და Hugging Face-ი OpenVINO-ს Optimum Intel-ში აერთიანებენ AI მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა გამოაცხადეს Intel OpenVINO-ს Optimum Intel-ში ინტეგრაციის შესახებ, რაც ტრანსფორმერული მოდელების სწრაფ და ეფექტურ ინფერენსს შესაძლებელს ხდის Intel-ის პროცესორებზე. სიახლე მოიცავს მოდელების კვანტიზაციას ზომის შემცირებისა და პროგნოზირების დაყოვნების გაუმჯობესებისთვის, ასევე მოცემულია ვიზუალური ტრანსფორმერის (ViT) გამოყენების პრაქტიკული მაგალითი. დეველოპერებს მოუწოდებენ, გამოიკვლიონ ახალი შესაძლებლობები.

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
Together AI-ი და Hugging Face-ი LLM მოდელების დახვეწას რევოლუციურ ხდის
Together AI-ი და Hugging Face-ი აცხადებენ ინტეგრაციის შესახებ, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული LLM მოდელების დახვეწას Together AI-ის ინფრასტრუქტურის გამოყენებით, რაც ამცირებს სირთულეს, ღირებულებას და DevOps ექსპერტიზის საჭიროებას. ეს ახალი შესაძლებლობა გუნდებს საშუალებას აძლევს, სწრაფად მოახდინონ მოდელების პერსონალიზაცია კონკრეტული საჭიროებებისთვის.
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა

NVIDIA-მ წარადგინა Palmyra-mini AI მოდელები გაუმჯობესებული მსჯელობის უნარებით
NVIDIA-მ გამოუშვა Palmyra-mini ხელოვნური ინტელექტის მოდელების ახალი სერია, მათ შორის 'მოაზროვნე' ვარიანტები, რომლებიც გაწვრთნილია აზროვნების ჯაჭვის (CoT) მიდგომით. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ ლოგიკური აზროვნების უნარებს და ხელმისაწვდომია GGUF და MLX კვანტიზაციით. სერია მოიცავს მოდელებს, რომლებიც გამოირჩევიან რთული ამოცანების გადაჭრითა და მაღალი ქულებით სხვადასხვა ბენჩმარკებზე, რაც მათ მრავალმხრივ გადაწყვეტილებად აქცევს გენერაციული და ლოგიკური ამოცანებისთვის.
მნიშვნელოვანი განახლებები ჩვენს ფასწარმოქმნასა და სერვისებში
ჩვენს ფასწარმოქმნის გვერდზე მნიშვნელოვანი ცვლილებები განხორციელდა: Inference API სერვისი სრულად უფასო გახდა, დაინერგა „Inference Endpoints“ კორპორატიული გადაწყვეტილებებისთვის, ხოლო Spaces-ისთვის აპარატურული განახლებები მოხდა. ბილინგი ცენტრალიზებულია, ახალი სერვისებისთვის მხოლოდ ბარათის დამატებაა საჭირო, ყოველთვიური ინვოისებით. ჩვენ ვახდენთ მონეტიზაციას AI-სთვის გამოთვლით რესურსებზე მარტივი წვდომის უზრუნველყოფით.

AI კონტენტის გამჭვირვალობა: Hugging Face აადვილებს წყლის ნიშნების დამატებას
Hugging Face წარმოგიდგენთ მარტივ გზას ხელოვნური ინტელექტის მიერ გენერირებულ კონტენტზე ხილული წყლის ნიშნების დასამატებლად Gradio-ს გამოყენებით. ეს ინიციატივა მიზნად ისახავს AI-გენერირებული სურათების, ვიდეოების, აუდიოსა და ტექსტების იდენტიფიცირების სირთულის დაძლევას, გამჭვირვალობის გაზრდას და მომხმარებლებისთვის ნდობის ამაღლებას. კომპანია დეველოპერულ საზოგადოებას მოუწოდებს, მიიღონ ეს პრაქტიკა პოტენციური კანონმდებლობის თავიდან ასაცილებლად.

Public AI Hugging Face Hub-ის მხარდაჭერილი გამოცნობის პროვაიდერი გახდა
Hugging Face Hub-მა გამოაცხადა Public AI-ის, როგორც ახალი მხარდაჭერილი გამოცნობის პროვაიდერის, ინტეგრაცია, რაც მნიშვნელოვნად აფართოებს სერვერული გამოცნობის შესაძლებლობებს. Public AI, არაკომერციული, ღია კოდის პროექტი, ხელს უწყობს საჯარო AI მოდელებზე წვდომას განაწილებული ინფრასტრუქტურის მეშვეობით. სტატია დეტალურად განმარტავს პლატფორმის გამოყენების პირობებს, მათ შორის უფასო წვდომასთან დაკავშირებულ შეზღუდვებს, ფასწარმოქმნას და Hugging Face-ის საკრედიტო სისტემას სხვადასხვა მომხმარებლისთვის.

AI თამაშებში: წარმოგიდგენთ NPC-Playground-ს - ახალი ერა ინტელექტუალური პერსონაჟებით
კომპანიებმა Cubzh-მა და Gigax-მა წარმოადგინეს NPC-Playground, დემო ვერსია, რომელიც გვიჩვენებს, თუ როგორ შეუძლიათ დიდ ენობრივ მოდელებს (LLM) შექმნან რეალისტური და ინტელექტუალური სათამაშო პერსონაჟები (NPC), რითაც მნიშვნელოვნად გაუმჯობესდება მოთამაშის გამოცდილება. ეს 3D დემო მომხმარებლებს საშუალებას აძლევს, იურთიერთონ NPC-ებთან და ასწავლონ მათ ახალი უნარები, რაც უდიდეს წინსვლას წარმოადგენს ტრადიციულ, წესებზე დაფუძნებულ სისტემებთან შედარებით.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს

Scaleway Hugging Face Hub-ის დასკვნის (Inference) პროვაიდერებს უერთდება
Scaleway, ღრუბლოვანი სერვისების წამყვანი პროვაიდერი, Hugging Face Hub-ის მხარდაჭერილი დასკვნის (Inference) პროვაიდერების ეკოსისტემას შეუერთდა. ეს ინტეგრაცია აფართოებს serverless inference-ის შესაძლებლობებს Hub-ზე, მომხმარებლებს უადვილებს წვდომას პოპულარულ ღია მოდელებზე, როგორიცაა gpt-oss, Qwen3 და Gemma 3. Scaleway გთავაზობთ კონკურენტულ ფასებს, ევროპულ მონაცემთა ცენტრებს და მოწინავე ფუნქციებს, რაც უზრუნველყოფს სწრაფ და უსაფრთხო AI ინფერენსს.
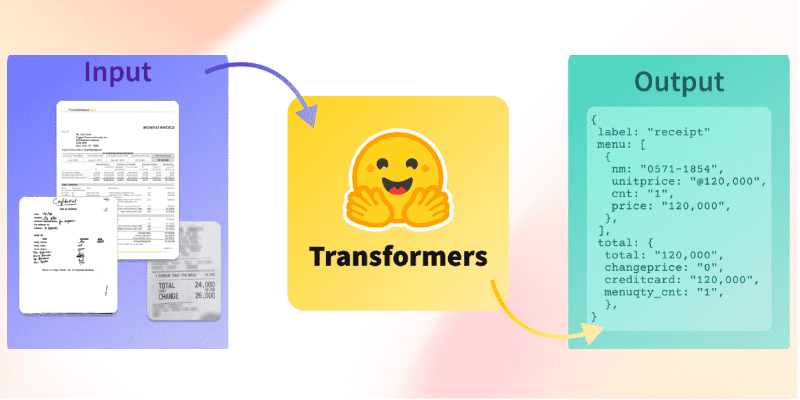
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ

Transformers-ის დოკუმენტაციის მასშტაბური განახლება: რატომ გახდა ის აუცილებელი
Transformers-ის ბიბლიოთეკის დოკუმენტაცია, რომელიც თავდაპირველად მანქანური სწავლების ინჟინრებსა და მკვლევრებზე იყო მორგებული, ხელოვნური ინტელექტის (AI) სწრაფი განვითარების ფონზე მოუწესრიგებელი და მოძველებული გახდა. მიმდინარეობს მასშტაბური რედიზაინი, რათა დოკუმენტაცია გახდეს კოდზე ორიენტირებული, გადაწყვეტილებებისკენ მიმართული და მომხმარებელზე მორგებული, განსაკუთრებით კი დეველოპერებისთვის. მიზანია, უზრუნველყოს მისი ზრდა და ადაპტაცია მომავალ საჭიროებებთან, სიხისტე კი მოქნილობით ჩანაცვლდეს.