
SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.
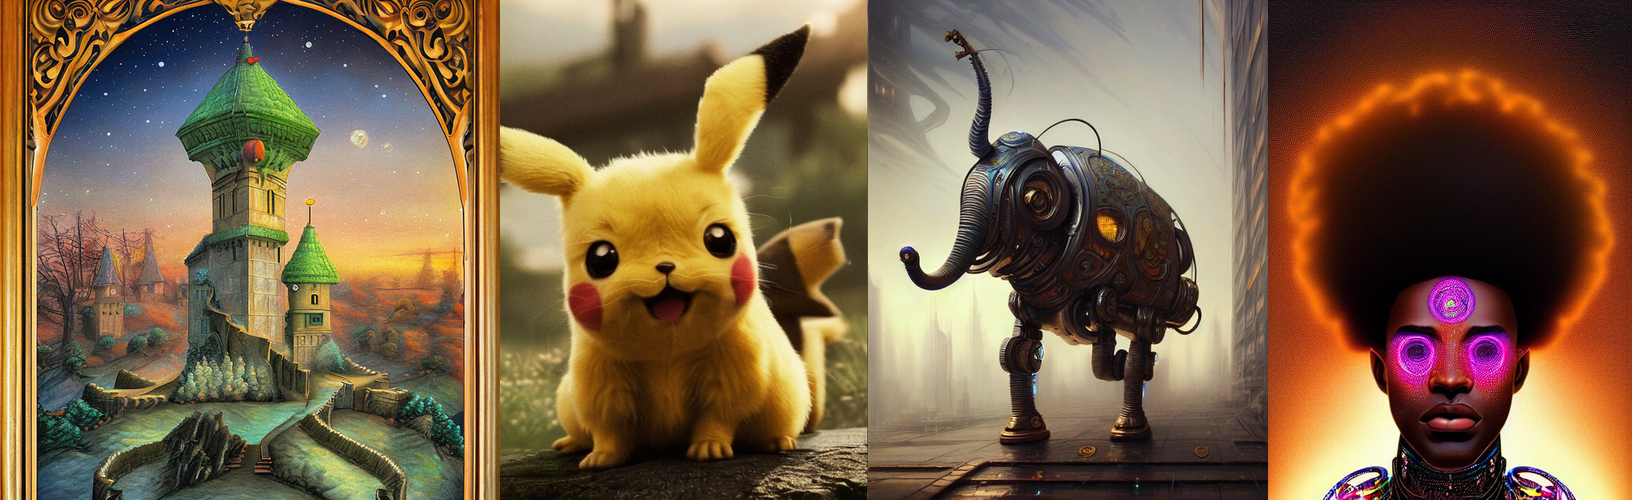
გეპატიჟებით Stable Diffusion-ის შემქმნელებთან და ხელოვნური ინტელექტის მკვლევრებთან შეხვედრაზე!
ამ გამოშვებასთან ერთად, 30 ნოემბერს ვმართავთ ცოცხალ საზოგადოებრივ ღონისძიებას, რომელზეც გეპატიჟებით! პროგრამა მოიცავს საინტერესო მოხსენებებს Stable Diffusion-ის შემქმნელებისგან, Stability AI-ისა და Meta-ს მკვლევრებისგან, ასევე სხვა ექსპერტებისგან! რეგისტრაციისთვის, გთხოვთ, შეავსოთ ეს ფორმა. სპიკერებისა და მოხსენებების შესახებ დამატებითი დეტალები მოცემულია ქვემოთ. მოხსენებები ფოკუსირებული იქნება დიფუზიური მოდელების მაღალი დონის პრეზენტაციაზე და იმ ინსტრუმენტებზე, რომელთა გამოყენებაც შეგვიძლია მათ

Stability AI-მ Stable Diffusion 3 Medium წარადგინა: ახალი 2-მილიარდპარამეტრიანი მოდელი გაუმჯობესებული არქიტექტურითა და წარმადობით
Stability AI-მ გამოუშვა Stable Diffusion 3 Medium (SD3), 2 მილიარდი პარამეტრიანი ლატენტური დიფუზიური მოდელი, რომელიც განკუთვნილია ტექსტიდან გამოსახულების სინთეზისთვის. ის მოიცავს ინოვაციურ მულტიმოდალურ დიფუზიურ ტრანსფორმატორს (MMDiT) და სამ ტექსტის ენკოდერს, მათ შორის T5-v1.1-XXL-ს. SD3 იყენებს პირობითი ნაკადის შესატყვისობის ობიექტივს სწავლებისთვის და წარმოგიდგენთ ახალ FlowMatchEulerDiscreteScheduler-ს ინფერენსისთვის. Diffusers-ის ინტეგრაცია მოიცავს მეხსიერების ოპტიმიზაციებს, რაც მოდელს უფრო ფარ

NVIDIA-მ Nemotron-Personas-Japan გამოუშვა: იაპონური კულტურის გაგების ხელოვნური ინტელექტისთვის
NVIDIA-მ წარმოადგინა Nemotron-Personas-Japan, პირველი ღია სინთეზური მონაცემთა ნაკრები, რომელიც ასახავს იაპონიის დემოგრაფიას, გეოგრაფიულ განაწილებას და კულტურულ მახასიათებლებს. CC BY 4.0 ლიცენზიით გამოშვებული ეს ნაკრები უზრუნველყოფს კონფიდენციალურობის დამცავ საფუძველს იაპონური საზოგადოების ამსახველი AI სისტემების შესაქმნელად, მგრძნობიარე პირადი მონაცემების გამოყენების გარეშე. იგი შექმნილია იაპონური სუვერენული AI სისტემების მხარდასაჭერად და ადვილად ინტეგრირდება ღია კოდის დიდ ენობრივ მოდელებთან (LL

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.
მონაცემთა ხარისხი: ხელოვნური ინტელექტის ეფექტური, ეთიკური და მდგრადი განვითარების საფუძველი
ხელოვნური ინტელექტის ეპოქაში, მონაცემთა ხარისხი გადამწყვეტ როლს თამაშობს AI სისტემების ეფექტურობაში, ეთიკურობასა და მდგრადობაში. სტატია განმარტავს, თუ რას ნიშნავს „მაღალი ხარისხის“ მონაცემები – ანუ, მონაცემები, რომლებიც მიზანშეწონილია კონკრეტული ამოცანისთვის – და ხაზს უსვამს, თუ რატომ არის კრიტიკული მისი პრიორიტეტულობა განვითარების საწყისი ეტაპიდანვე. განიხილება ჰოლისტიკური მიდგომა, რომელიც მოიცავს მონაცემთა საგულდაგულო კურაციას, მართვის მყარ ჩარჩოს, მონაცემთა მრავალფეროვან წარმოდგენას და რეგულა
Gaudi2: Habana Labs-ის AI ამაჩქარებელი, რომელიც ტრენინგის დროს 5.75-ჯერ აჩქარებას გვთავაზობს
Habana Labs-მა წარმოადგინა Gaudi2, მეორე თაობის AI აპარატურული ამაჩქარებელი, რომელიც მნიშვნელოვნად აუმჯობესებს შესრულებას ტრენინგისა და ინფერენციისას პირველ თაობის Gaudi-სა და Nvidia A100-თან შედარებით. სტატიაში დეტალურად არის განხილული მისი ტექნიკური მახასიათებლები, Intel Developer Cloud-ზე წვდომის გზები, BERT-ის წინასწარი ტრენინგის შედეგები 5.75-ჯერ შემცირებული დროით და Stable Diffusion-ის მხარდაჭერა, ასევე დაყოვნების მაჩვენებლების გაუმჯობესება.
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ

Arm PyTorch კონფერენციაზე: დეველოპერების გაძლიერება AI გადაწყვეტილებების შექმნაში
Arm-ი 22-23 ოქტომბერს PyTorch კონფერენციაზე დეველოპერებს სთავაზობს უნიკალურ შესაძლებლობებს ხელოვნური ინტელექტის (AI) აპლიკაციების შექმნისა და განთავსებისთვის PyTorch-ისა და ExecuTorch-ის გამოყენებით. კონფერენციაზე წარმოდგენილი იქნება უახლესი AI ტექნოლოგიები, ჩატარდება ინდივიდუალური ვორქშოფები პასუხისმგებლიანი AI განვითარების შესახებ და „დეველოპერის ხმის“ სესიები, სადაც დეველოპერები გაუზიარებენ საკუთარ გამოცდილებას. მონაწილეებს შესაძლებლობა ექნებათ გააფართოონ პროფესიული ქსელი, მიიღონ პრაქტიკული რ

NVIDIA-ს Nemotron-Personas-India: მონაცემთა უნიკალური ბაზა ინდოეთის მრავალენოვანი AI სისტემებისთვის
ინდოეთი, 700 მილიონზე მეტი ინტერნეტ მომხმარებლით და მრავალი ენით, ხელოვნური ინტელექტის (AI) უზარმაზარ შესაძლებლობებს გვთავაზობს. თუმცა, არსებული მონაცემთა ბაზები ხშირად დასავლურ ნორმებსა და ინგლისურენოვან კონტექსტს ასახავს, რაც ზღუდავს AI-ის ადაპტაციას ინდოეთის მრავალენოვან და მრავალ-წერილობით გარემოში. ამ პრობლემის გადასაჭრელად, NVIDIA-მ გამოუშვა Nemotron-Personas-India — პირველი ღია სინთეზური მონაცემთა ბაზა, რომელიც ინდური პერსონების დემოგრაფიულ, გეოგრაფიულ და კულტურულ მახასიათებლებს ასახავს.
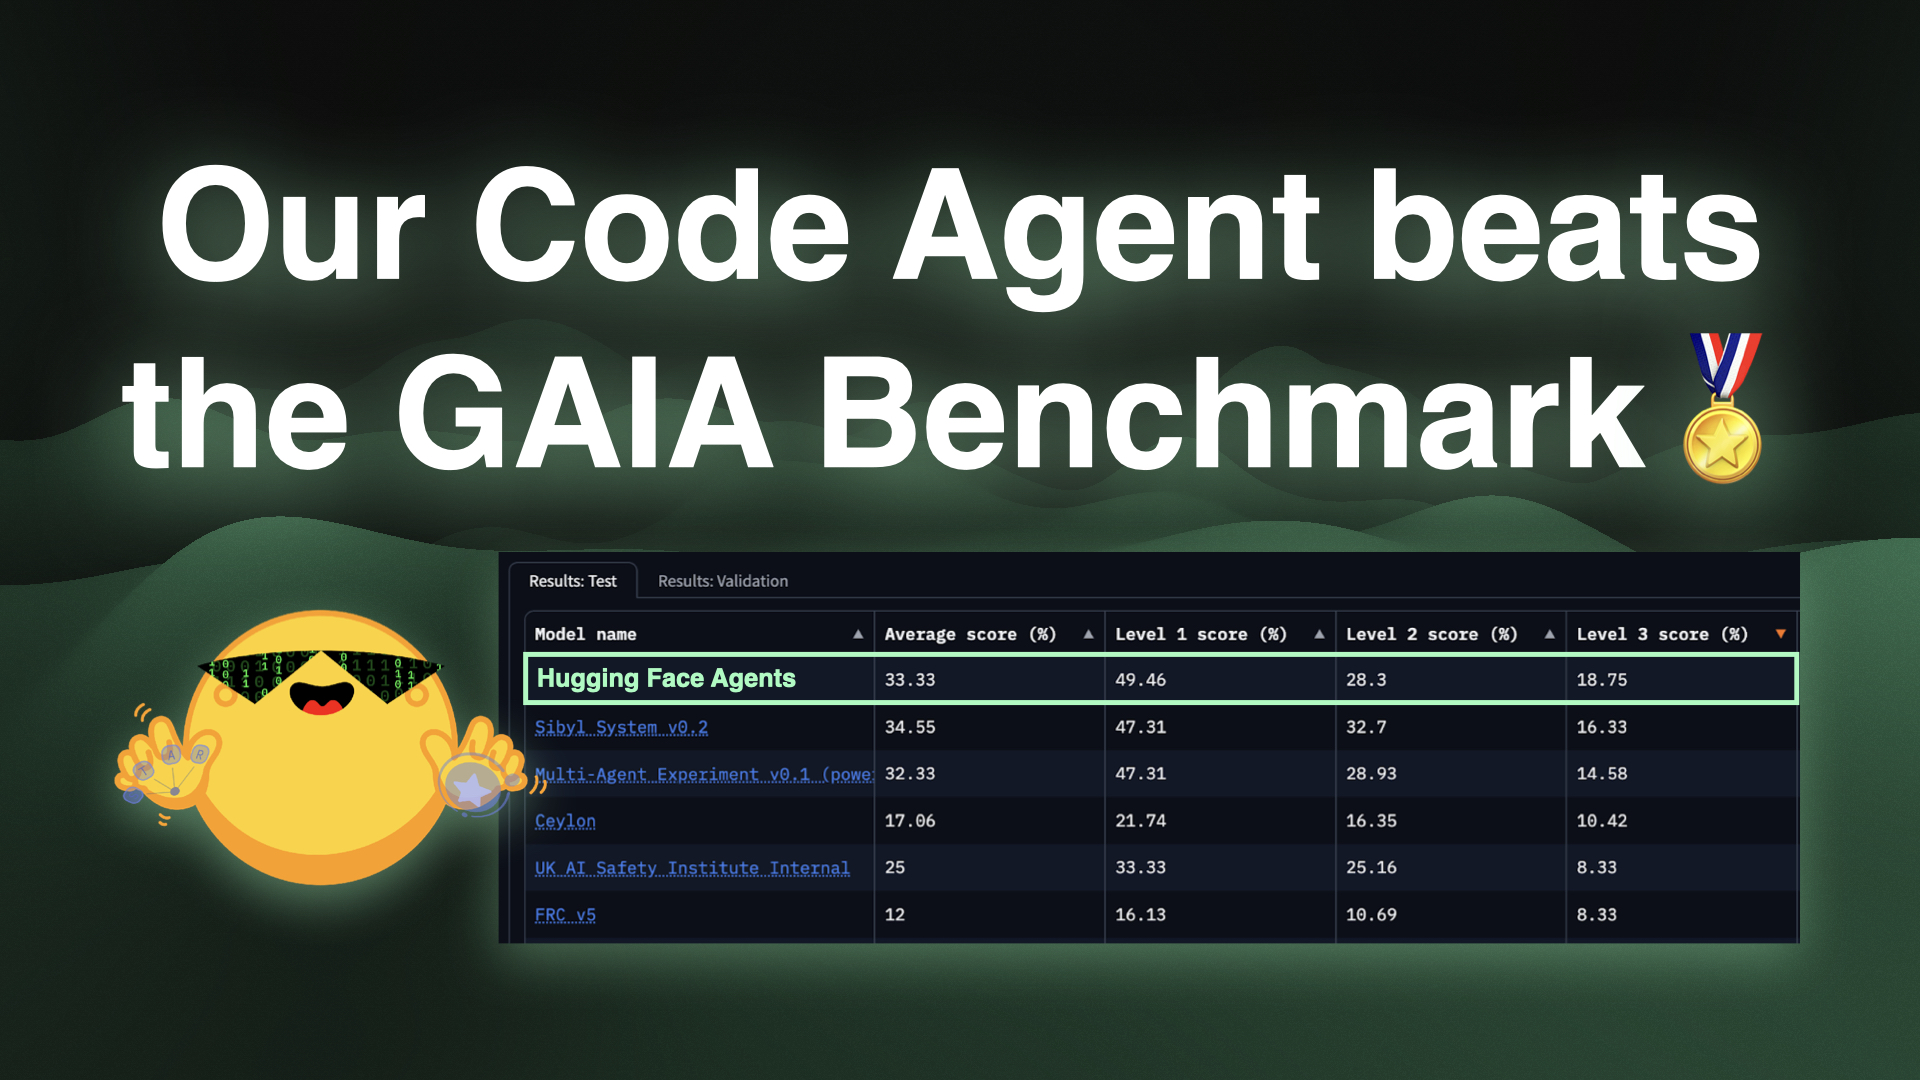
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
CLIPSeg: რევოლუციური ხელოვნური ინტელექტი, რომელიც ნებისმიერი ობიექტის სეგმენტაციას დამატებითი წვრთნის გარეშე ახდენს
სტატია განიხილავს გამოსახულების სეგმენტაციას, მის არსებულ შეზღუდვებს (ფიქსირებული კატეგორიები, წვრთნის მაღალი ღირებულება) და წარმოგიდგენთ CLIPSeg-ს. CLIPSeg არის "ნულოვანი-კადრის" (zero-shot) სეგმენტაციის მოდელი, რომელიც OpenAI-ის CLIP-ზეა დაფუძნებული და შეუძლია თითქმის ნებისმიერი ობიექტის სეგმენტაცია დამატებითი წვრთნის გარეშე. ის იყენებს CLIP-ის უნარს, შექმნას გამოსახულებებისა და ტექსტის აბსტრაქტული წარმოდგენები, ტრანსფორმატორზე დაფუძნებული დეკოდერის დახმარებით სეგმენტაციის ნიღბების შესაქმნელად

ხელოვნური ინტელექტის როლი კვებითი ალერგიების კვლევასა და მკურნალობაში
ბიოსამედიცინო კვლევებმა და ხელოვნურმა ინტელექტმა ბოლო წლებში მნიშვნელოვან პროგრესს მიაღწიეს. ეს მიღწევები განსაკუთრებით შთამბეჭდავია კვებითი ალერგიების გაგების, პროგნოზირებისა და მკურნალობის კონტექსტში. სტატია აღწერს, თუ როგორ ცვლის AI პროტეინების სტრუქტურის პროგნოზირებას (მაგ., AlphaFold), აჩქარებს წამლის აღმოჩენას, აუმჯობესებს დიაგნოსტიკურ ხელსაწყოებს და უზრუნველყოფს კვების პროდუქტების უსაფრთხოებას, ეტიკეტების ანალიზის ჩათვლით. პროექტი „AI კვებითი ალერგიებისთვის“ მიზნად ისახავს საზოგადოებაზე ო
AI და მონაცემთა სუვერენიტეტი: საფრანგეთის სკოლების ეკოლოგიური რენოვაციის ინოვაციური პროექტი
Banque des Territoires-ის, Polyconseil-ისა და Hugging Face-ის თანამშრომლობამ შექმნა გენერაციული ხელოვნური ინტელექტის გადაწყვეტა, რომელიც მხარს უჭერს საფრანგეთის EduRénov პროგრამას. ეს პროექტი მიზნად ისახავს 10,000 საჯარო სკოლის ეკოლოგიურ რენოვაციას, მონაცემთა სუვერენიტეტისა და ღია წყაროს ტექნოლოგიების გამოყენებაზე განსაკუთრებული აქცენტით. პირველი ფაზის წარმატებით დასრულების შემდეგ, ინსტრუმენტი განკუთვნილია ადგილობრივ თვითმმართველობებთან ურთიერთობის ოპტიმიზაციისა და ენერგოეფექტურობის მიზნების მის

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც
თამაშების დიზაინი AI-ის დახმარებით: Stable Diffusion და Unity
ეს სტატია გთავაზობთ სახელმძღვანელოს, თუ როგორ გამოვიყენოთ Stable Diffusion ხელოვნური ინტელექტის მოდელი, რათა შევქმნათ უნიკალური ვიზუალური სტილი ჩვენი თამაშისთვის, კერძოდ კი სოფლის მეურნეობის სიმულატორისთვის Unity-ში. განხილულია Stable Diffusion-ის ლოკალურად ან ონლაინ გაშვების მეთოდები, პრომპტინგის რჩევები და საბოლოოდ, კონცეპტუალური ხელოვნების ინტეგრაცია Unity-ში.

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ
სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ
TRL ბიბლიოთეკა DPO-ს მხარდაჭერას იწყებს ვიზუალური ენობრივი მოდელებისთვის (VLM-ები)
უპირატესობების ოპტიმიზაცია, რომელიც ფართოდ გამოიყენება ენობრივი მოდელების დასახვეწად, ახლა ვრცელდება ვიზუალურ ენობრივ მოდელებზე (VLM-ები) TRL ბიბლიოთეკის მეშვეობით. TRL-მა დაამატა პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მხარდაჭერა VLM-ებისთვის, რაც საშუალებას იძლევა მოდელების გაწვრთნას მომხმარებლის პრეფერენციების ამსახველი მონაცემებით. სტატია დეტალურად აღწერს VLM-ების DPO-ით გაწვრთნის პროცესს, მონაცემთა ნაკრების მომზადებიდან (მაგ., `openbmb/RLAIF-V-Dataset`) და მეხსიერების ოპტიმიზაციის ტექნიკე