ოფლაინ გადაწყვეტილების ტრანსფორმატორის მოდელის გაწვრთნა: ნახევრად-გეპარდის სიმულაციის მიღწევა
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა გაწვრთნათ ოფლაინ გადაწყვეტილების ტრანსფორმატორის (Decision Transformer) მოდელი ნულიდან, რათა სიმულაციურ გარემოში ნახევრად-გეპარდმა შეძლოს მოძრაობა. განხილულია მოდელის ფუნდამენტური პრინციპები, რომელიც განმტკიცებით სწავლებას მიმდევრობის მოდელირების პრობლემად აღიქვამს და წარსული მონაცემებისა და სასურველი შედეგების საფუძველზე სამომავლო მოქმედებებს აგენერირებს. პრაქტიკული გაკვეთილი, რომელიც Google Colab-ზე სრულდება, ხსნის მონაცემთა დამუშავებასა და Hugging Fac

მოდელების ეფექტური ვარჯიში: პარალელიზმის სტრატეგიების მიმოხილვა Accelerate-სა და Axolotl-ში
ეს სტატია განიხილავს მოდელების ვარჯიშის პარალელიზმის სხვადასხვა სტრატეგიას, მათ შორის მონაცემთა პარალელიზმს (DP) და სრულად დაშარდულ მონაცემთა პარალელიზმს (FSDP), აქცენტს აკეთებს მათ მუშაობის პრინციპებზე, უპირატესობებსა და გამოყენების შემთხვევებზე. განხილულია, თუ როგორ შეიძლება ამ ტექნიკების ინტეგრირება Accelerate-სა და Axolotl-ის ბიბლიოთეკებში, როგორ უნდა მოხდეს მათი კომბინირება და რა გამოწვევები არსებობს დიდ მოდელებთან მუშაობისას, განსაკუთრებით კომუნიკაციის დანახარჯების მინიმიზაციის კუთხით მრავ

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
როგორ აძლიერებს Intel-ი RAG აპლიკაციებს OPEA პლატფორმაზე: Gaudi 2 და Xeon CPU-ები
ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) კრიტიკულად მნიშვნელოვანია დიდი ენობრივი მოდელებისთვის (LLM) ახალი ცოდნის ინკორპორირებისთვის, რაც აუმჯობესებს წარმადობასა და უსაფრთხოებას. Intel, OPEA პლატფორმის ფარგლებში, დეველოპერებს სთავაზობს სრულყოფილ გადაწყვეტილებებს RAG აპლიკაციების შესაქმნელად და ოპტიმიზაციისთვის. სტატია დეტალურად აღწერს Intel Gaudi 2 AI ამაჩქარებლებისა და Xeon CPU-ების როლს საწარმოო წარმადობის მნიშვნელოვნად გაზრდაში. ასევე განხილულია LangChain ფრეიმვორკის გამოყენება RAG ა

განახლება, 2025 წლის ოქტომბერი: Claude-ის Hugging Face-თან დაკავშირება მოწინავე გამოსახულების გენერაციისთვის
სტატიაში დეტალურად არის აღწერილი, თუ როგორ დავაკავშიროთ Claude Hugging Face-ის MCP სერვერთან, რათა გამოვიყენოთ ხელოვნური ინტელექტის მოწინავე გამოსახულების გენერაციის მოდელები, როგორიცაა Krea და Qwen-Image. ეს აფართოებს Claude-ის შესაძლებლობებს რეალისტური ვიზუალის შექმნისა და ტექსტის ზუსტი რენდერინგის მიმართულებით, Anthropic-ის პოლიტიკის განახლების შემდეგ.
Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ
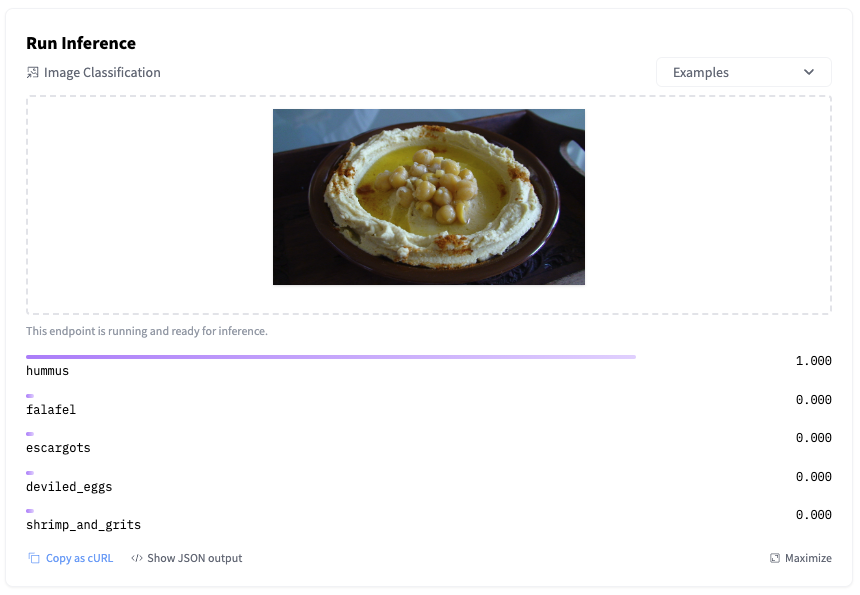
Hugging Face Inference Endpoints: ML მოდელების პროდუქციაში განთავსების გამარტივება
ეს სტატია განმარტავს, თუ როგორ ამარტივებს Hugging Face Inference Endpoints მანქანური სწავლების (ML) მოდელების პროდუქციაში განთავსების რთულ პროცესს. სერვისი საშუალებას გაძლევთ, რამდენიმე დაწკაპუნებით განათავსოთ მოდელები უშუალოდ Hugging Face Hub-იდან მართულ ინფრასტრუქტურაზე, რაც უზრუნველყოფს სიმარტივეს, უსაფრთხოებას და მასშტაბურობას. სტატია დეტალურად აღწერს, თუ როგორ ხდება დაცული და პირადი Endpoint-ების კონფიგურაცია AWS-ზე.
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
Hugging Face-ის ბიბლიოთეკაში ენის მოდელების მიკერძოების შეფასების ახალი მეტრიკები დაემატა
Hugging Face-მა თავის 🤗 Evaluate ბიბლიოთეკას დაამატა ახალი მეტრიკები და საზომები, რომლებიც მიმართულია ენის მოდელებში (როგორიცაა GPT-2 და BLOOM) არსებული მიკერძოებების შესასწავლად. ეს ხელსაწყოები საშუალებას იძლევა შეფასდეს ტოქსიკურობა, პოლარობა და მტკივნეულობა (hurtfulness), რითაც ხელს უწყობს ენის მოდელებში დაშიფრული სოციალური საკითხების უკეთ გაგებას და მათთან ბრძოლას. სტატია დეტალურად განიხილავს ამ ხელსაწყოების გამოყენებას სხვადასხვა ამოცანებში.

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის
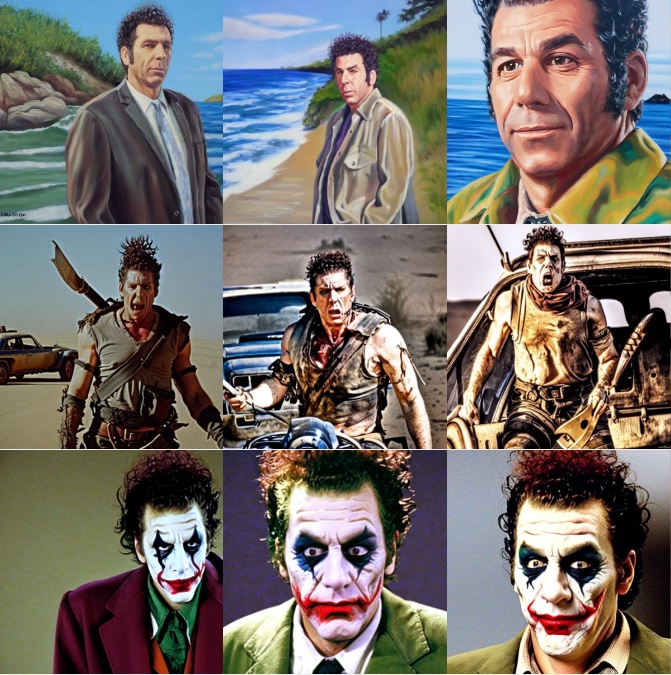
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.

Sentence Transformers-ის ოპტიმიზაცია: ძირითადი კომპონენტები და ეფექტური მოდელების შექმნა
ამ სტატიაში განხილულია Sentence Transformers-ის მოდელების ოპტიმიზაციის პროცესი, რომელიც მოიცავს მონაცემთა ნაკრებებს, დანაკარგის ფუნქციებს, ვარჯიშის არგუმენტებს, შემფასებლებსა და ახალ ტრენერს. თითოეული კომპონენტი დეტალურადაა აღწერილი მაგალითებთან ერთად, რათა დაგეხმაროთ ეფექტური მოდელების შექმნაში კონკრეტული ამოცანებისთვის, სხვადასხვა მსგავსების კონცეფციის გათვალისწინებით.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ
ჰომომორფული დაშიფვრა მოქმედებაში: სენტიმენტების ანალიზი დაშიფრულ მონაცემებზე Concrete-ML-ით
ახალი ტექნოლოგიური მიღწევა მონაცემთა კონფიდენციალურობის სფეროში: სტატია იკვლევს ჰომომორფულ დაშიფრვას (FHE), რომელიც იძლევა დაშიფრულ მონაცემებზე გამოთვლების საშუალებას მათი გაშიფვრის გარეშე. Concrete-ML ბიბლიოთეკის დახმარებით, მონაცემთა მეცნიერებს შეუძლიათ შექმნან მანქანური სწავლების მოდელები FHE გარემოში კრიპტოგრაფიის ცოდნის გარეშე. გთავაზობთ პრაქტიკულ სახელმძღვანელოს დაშიფრულ მონაცემებზე სენტიმენტების ანალიზის მოდელის შესაქმნელად, დემო ვერსიით Hugging Face Spaces-ზე.

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt

Public AI Hugging Face Hub-ის მხარდაჭერილი გამოცნობის პროვაიდერი გახდა
Hugging Face Hub-მა გამოაცხადა Public AI-ის, როგორც ახალი მხარდაჭერილი გამოცნობის პროვაიდერის, ინტეგრაცია, რაც მნიშვნელოვნად აფართოებს სერვერული გამოცნობის შესაძლებლობებს. Public AI, არაკომერციული, ღია კოდის პროექტი, ხელს უწყობს საჯარო AI მოდელებზე წვდომას განაწილებული ინფრასტრუქტურის მეშვეობით. სტატია დეტალურად განმარტავს პლატფორმის გამოყენების პირობებს, მათ შორის უფასო წვდომასთან დაკავშირებულ შეზღუდვებს, ფასწარმოქმნას და Hugging Face-ის საკრედიტო სისტემას სხვადასხვა მომხმარებლისთვის.
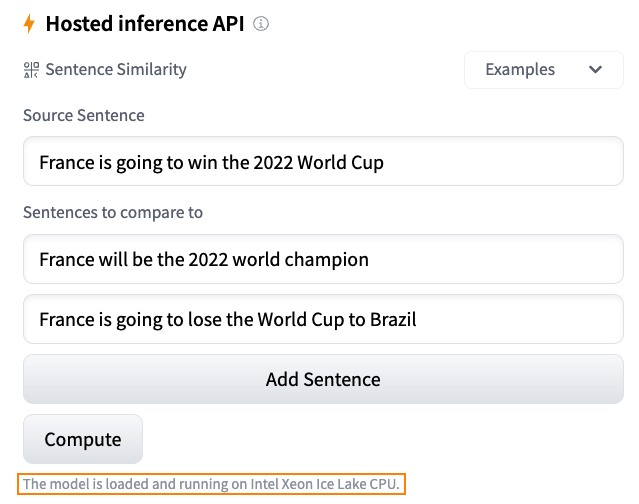
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.