მანქანური სწავლების დირექტორების შეხედულებები: სერიის მეოთხე ნაწილი
მანქანური სწავლების დირექტორების შეხედულებების სერიის მეოთხე ნაწილში, ინდუსტრიის ოთხი წამყვანი ექსპერტი – ხავიერ მანსილია, შონ გიტენსი, სემუელ ფრანკლინი და ევან კასლი – განიხილავენ მანქანური სწავლების ტრანსფორმაციულ გავლენას მათ სფეროებზე. სტატია მოიცავს დეტალურ ინფორმაციას Mercado Libre-სა და MasterPeace Solutions-ის მაგალითებზე, სადაც ML ქმნის შეუძლებელს, აუმჯობესებს მომხმარებლის გამოცდილებას და უმკლავდება რთულ გამოწვევებს, დაწყებული თაღლითობის პრევენციიდან და ოპტიმიზებული პროცესებიდან, დამთავ
მანქანური სწავლების გავლენა ინდუსტრიებზე: წამყვანი დირექტორების ხედვები
ეს სტატია წარმოგიდგენთ მანქანური სწავლების (ML) ლიდერთა შეხედულებების სერიის მეოთხე ნაწილს. მასში განხილულია, თუ რა გავლენას ახდენს ML სხვადასხვა ინდუსტრიაზე, ისეთი წამყვანი სპეციალისტების პერსპექტივიდან, როგორებიც არიან ხავიერ მანილა (Mercado Libre) და შონ გიტენსი (MasterPeace Solutions). ისინი საუბრობენ ML-ის გამოყენების მაგალითებზე ელექტრონულ კომერციაში, ფინტექში, მოწინავე ტექნოლოგიებსა და კიბერსერვისებში, ასევე გამოწვევებზე, ხშირ შეცდომებსა და სამომავლო ტენდენციებზე.
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.
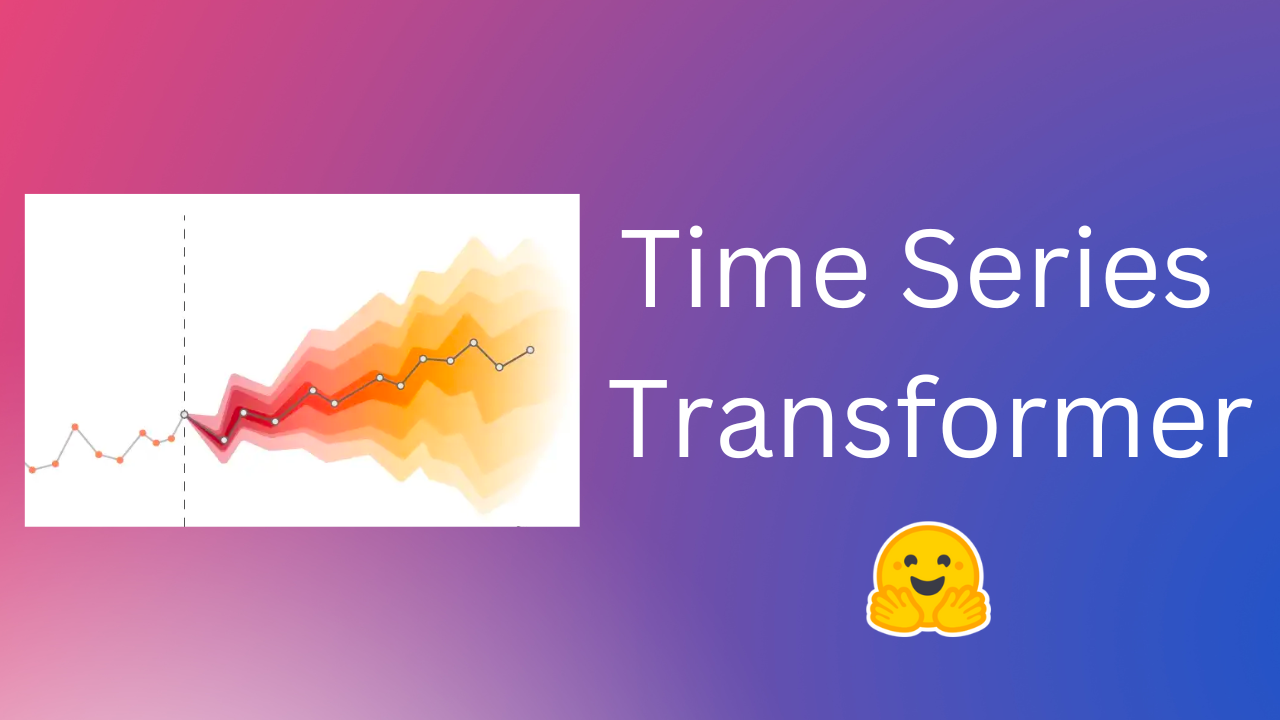
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი

Vibe Coding თამაშების შექმნა: პრობლემები და ავტორის ინოვაციური გადაწყვეტა
სტატია იკვლევს „vibe coding“-ის კონცეფციას თამაშების შექმნისას, სადაც ხელოვნური ინტელექტი გამოიყენება მაღალი დონის პროგრამირების ენად. განხილულია პროექტების ზრდასთან დაკავშირებული გამოწვევები, განსაკუთრებით ხელოვნური ინტელექტის მოდელების კონტექსტური ფანჯრის შეზღუდვების გამო. წარმოდგენილია „Shallot“ – კონტექსტის მართვის სისტემა და „VibeGame“ – ახალი, მაღალი დონის დეკლარაციული სათამაშო ძრავი, რომელიც სპეციალურად ხელოვნური ინტელექტის დახმარებით თამაშების შესაქმნელად შეიქმნა ამ პრობლემების დასაძლევა
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.
მონაცემთა ხარისხი: ხელოვნური ინტელექტის ეფექტური, ეთიკური და მდგრადი განვითარების საფუძველი
ხელოვნური ინტელექტის ეპოქაში, მონაცემთა ხარისხი გადამწყვეტ როლს თამაშობს AI სისტემების ეფექტურობაში, ეთიკურობასა და მდგრადობაში. სტატია განმარტავს, თუ რას ნიშნავს „მაღალი ხარისხის“ მონაცემები – ანუ, მონაცემები, რომლებიც მიზანშეწონილია კონკრეტული ამოცანისთვის – და ხაზს უსვამს, თუ რატომ არის კრიტიკული მისი პრიორიტეტულობა განვითარების საწყისი ეტაპიდანვე. განიხილება ჰოლისტიკური მიდგომა, რომელიც მოიცავს მონაცემთა საგულდაგულო კურაციას, მართვის მყარ ჩარჩოს, მონაცემთა მრავალფეროვან წარმოდგენას და რეგულა

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად
ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ
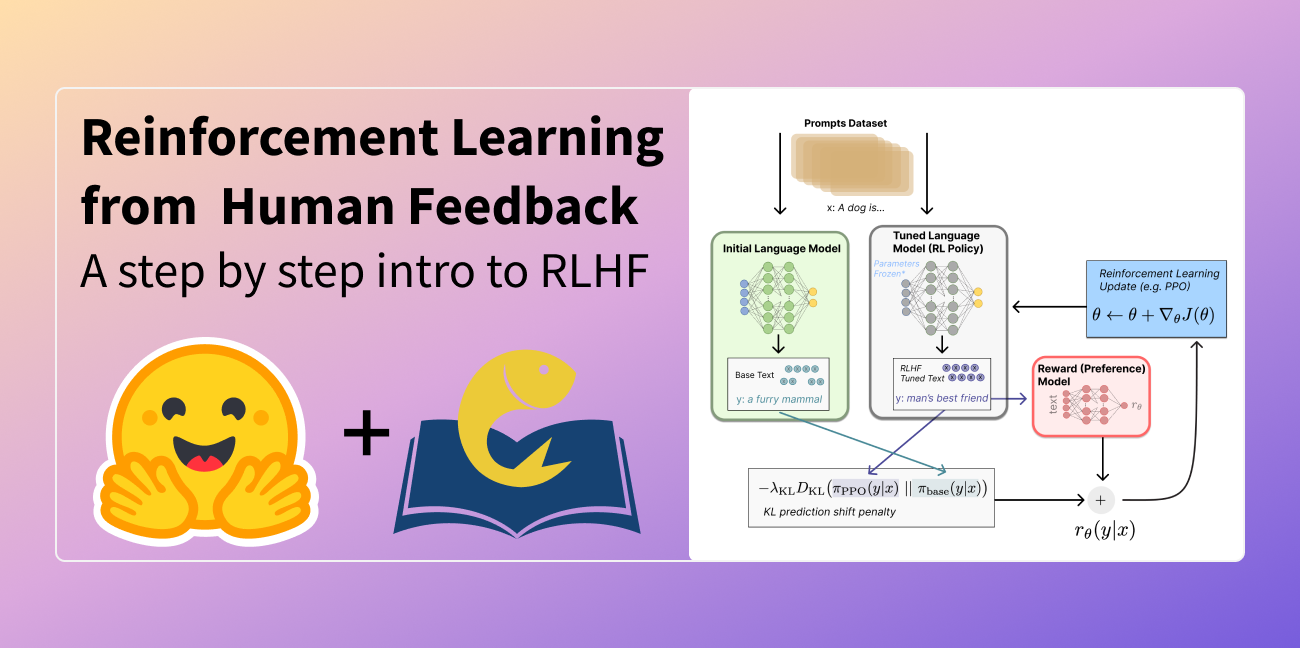
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან
Gaudi2: Habana Labs-ის AI ამაჩქარებელი, რომელიც ტრენინგის დროს 5.75-ჯერ აჩქარებას გვთავაზობს
Habana Labs-მა წარმოადგინა Gaudi2, მეორე თაობის AI აპარატურული ამაჩქარებელი, რომელიც მნიშვნელოვნად აუმჯობესებს შესრულებას ტრენინგისა და ინფერენციისას პირველ თაობის Gaudi-სა და Nvidia A100-თან შედარებით. სტატიაში დეტალურად არის განხილული მისი ტექნიკური მახასიათებლები, Intel Developer Cloud-ზე წვდომის გზები, BERT-ის წინასწარი ტრენინგის შედეგები 5.75-ჯერ შემცირებული დროით და Stable Diffusion-ის მხარდაჭერა, ასევე დაყოვნების მაჩვენებლების გაუმჯობესება.
მანქანური სწავლების სისტემებში მიკერძოების დაძლევა: Hugging Face-ის ინსტრუმენტები და გაკვეთილები
Hugging Face-ის ეთიკისა და საზოგადოების გუნდის ბლოგ-პოსტი ყურადღებას ამახვილებს მანქანური სწავლების (ML) სისტემებში მიკერძოების დაძლევის მნიშვნელობაზე. სტატია გთავაზობთ გაკვეთილებს და წარმოადგენს ინსტრუმენტებს ალგორითმული მიკერძოების ანალიზისა და შესამცირებლად ML განვითარების ყველა დონეზე. იგი ხაზს უსვამს კონტექსტის როლს, აფრთხილებს დისკრიმინაციის გამწვავების პოტენციალის შესახებ და მოუწოდებს ეთიკურ მიდგომას ამ სფეროში.
მანქანურ სწავლებაში მიკერძოების დაძლევა: Hugging Face-ის მიდგომები და ინსტრუმენტები
Hugging Face-ის „ეთიკა და საზოგადოება“ გუნდი წარმოგიდგენთ გაკვეთილებსა და ინსტრუმენტებს, რომლებიც შემუშავებულია მანქანურ სწავლებაში (ML) მიკერძოების წინააღმდეგ საბრძოლველად. სტატია ხაზს უსვამს ML სისტემების პოტენციურ უარყოფით გავლენას, მათ შორის დისკრიმინაციული ქცევების გამეორებას, და აჩვენებს Hugging Face-ის პიროვნულ მოტივაციას ამ რისკების გაგებისა და შემცირების მიმართ. იგი მოუწოდებს გულისხმიერ განვითარებას, კონტექსტის გათვალისწინებას და ინსტრუმენტების გამოყენებას მიკერძოების ყველა ეტაპზე გამოს
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
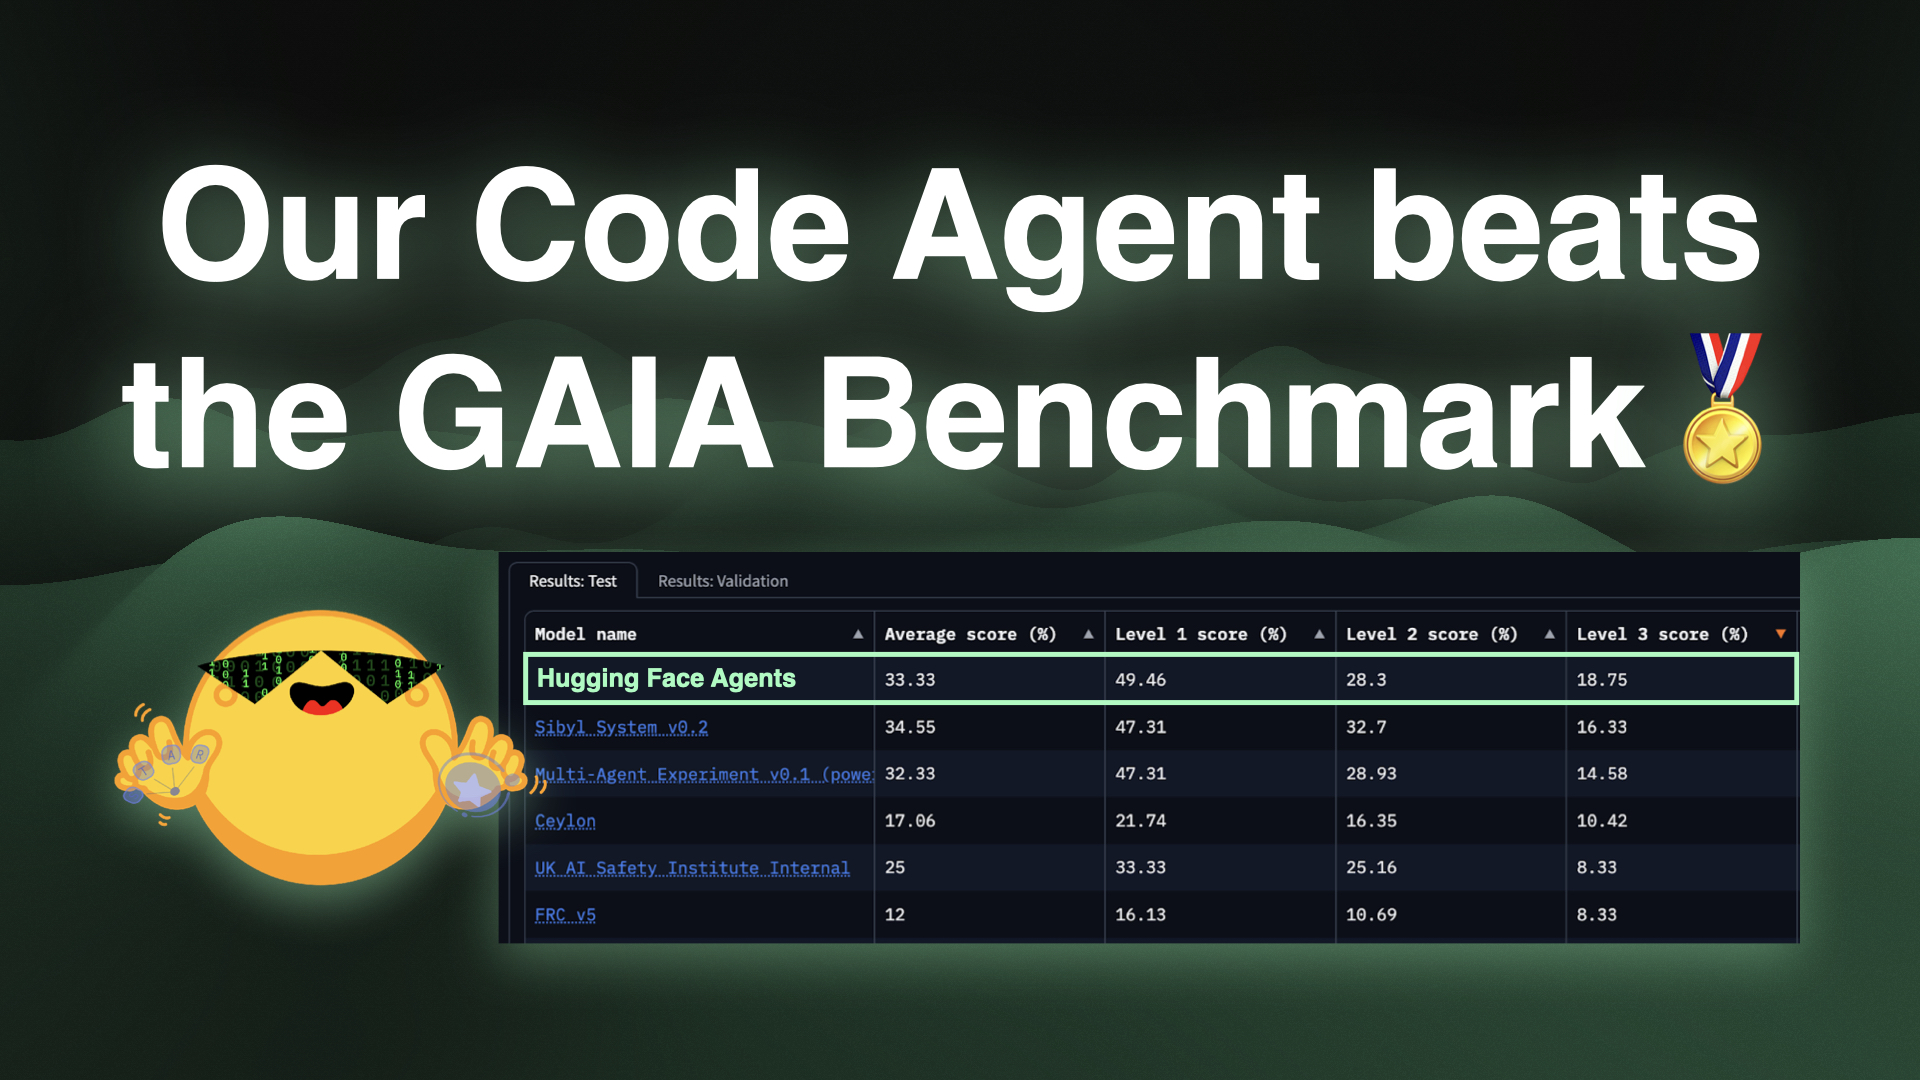
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ

AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ
CLIPSeg: რევოლუციური ხელოვნური ინტელექტი, რომელიც ნებისმიერი ობიექტის სეგმენტაციას დამატებითი წვრთნის გარეშე ახდენს
სტატია განიხილავს გამოსახულების სეგმენტაციას, მის არსებულ შეზღუდვებს (ფიქსირებული კატეგორიები, წვრთნის მაღალი ღირებულება) და წარმოგიდგენთ CLIPSeg-ს. CLIPSeg არის "ნულოვანი-კადრის" (zero-shot) სეგმენტაციის მოდელი, რომელიც OpenAI-ის CLIP-ზეა დაფუძნებული და შეუძლია თითქმის ნებისმიერი ობიექტის სეგმენტაცია დამატებითი წვრთნის გარეშე. ის იყენებს CLIP-ის უნარს, შექმნას გამოსახულებებისა და ტექსტის აბსტრაქტული წარმოდგენები, ტრანსფორმატორზე დაფუძნებული დეკოდერის დახმარებით სეგმენტაციის ნიღბების შესაქმნელად

ხელოვნური ინტელექტის როლი კვებითი ალერგიების კვლევასა და მკურნალობაში
ბიოსამედიცინო კვლევებმა და ხელოვნურმა ინტელექტმა ბოლო წლებში მნიშვნელოვან პროგრესს მიაღწიეს. ეს მიღწევები განსაკუთრებით შთამბეჭდავია კვებითი ალერგიების გაგების, პროგნოზირებისა და მკურნალობის კონტექსტში. სტატია აღწერს, თუ როგორ ცვლის AI პროტეინების სტრუქტურის პროგნოზირებას (მაგ., AlphaFold), აჩქარებს წამლის აღმოჩენას, აუმჯობესებს დიაგნოსტიკურ ხელსაწყოებს და უზრუნველყოფს კვების პროდუქტების უსაფრთხოებას, ეტიკეტების ანალიზის ჩათვლით. პროექტი „AI კვებითი ალერგიებისთვის“ მიზნად ისახავს საზოგადოებაზე ო
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
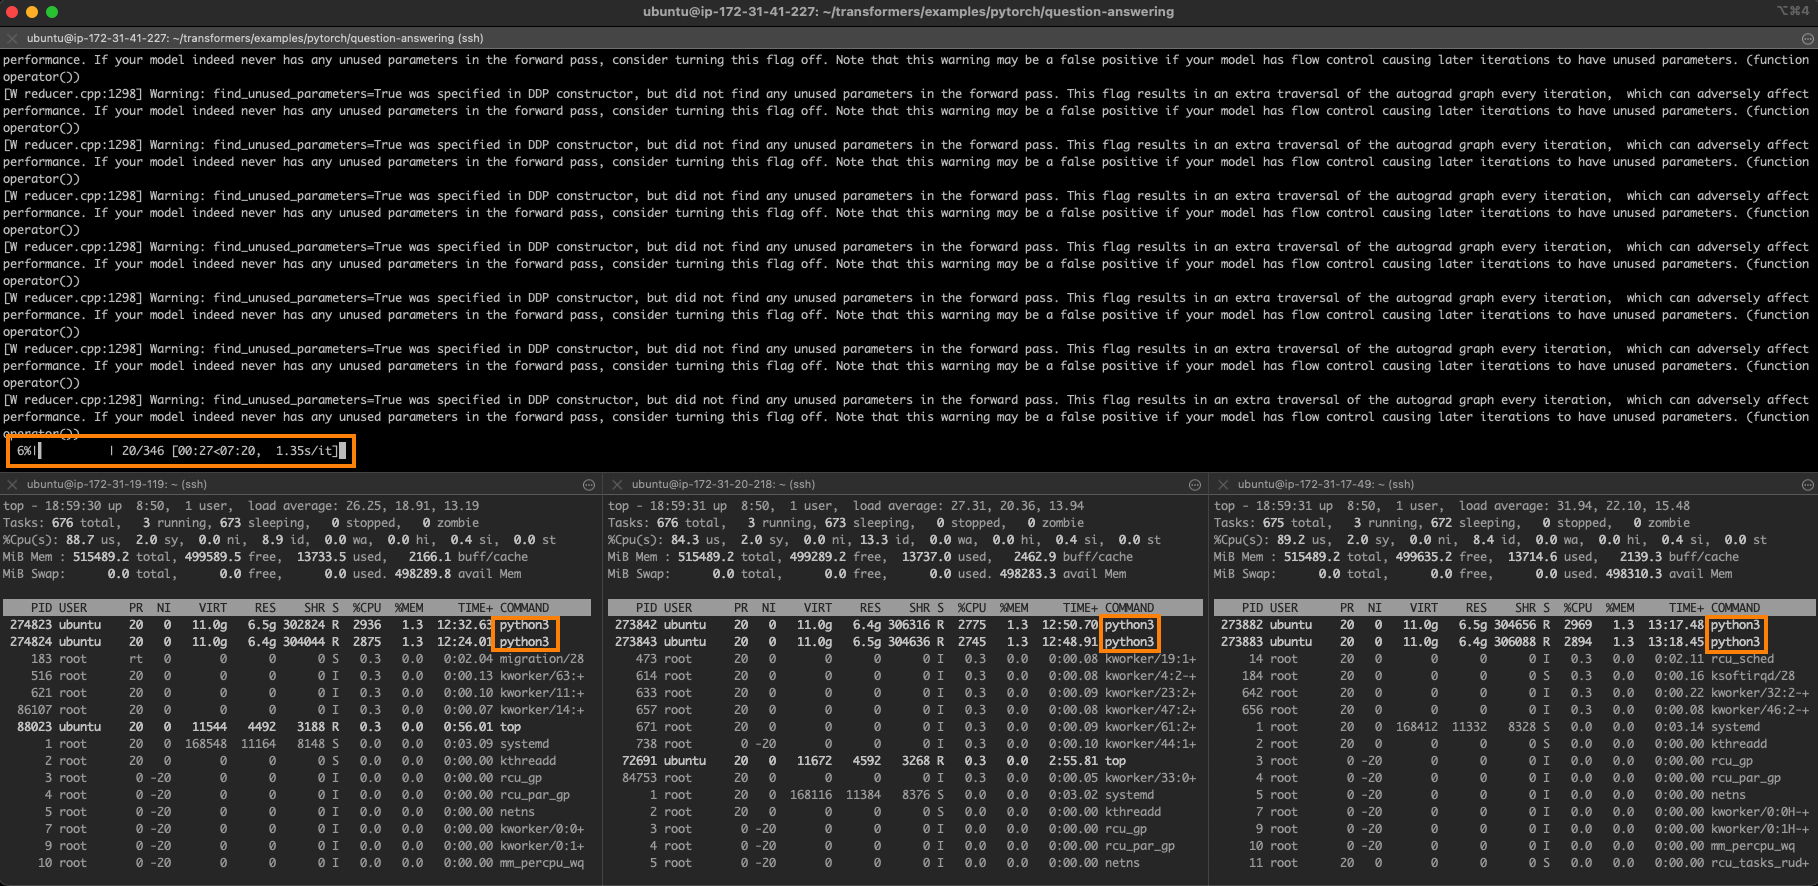
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო