
TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ
DuckDB-NSQL-7B: ხელოვნური ინტელექტით SQL შეკითხვების გენერირება მონაცემთა ანალიზისთვის
დეველოპერები და ანალიტიკოსები სულ უფრო მეტად აფასებენ ხელოვნური ინტელექტის (AI) პოტენციალს მონაცემთა ანალიზის გასამარტივებლად. ტრადიციული SQL შეკითხვების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, თუმცა AI-ზე დაფუძნებული გადაწყვეტილებები, როგორიცაა MotherDuck-ისა და Numbers Station-ის DuckDB-NSQL-7B მოდელი, ამ პროცესს არა-დეველოპერებისთვისაც ხელმისაწვდომს ხდის. სტატია დეტალურად აღწერს, თუ როგორ შეუძლია ამ LLM-ს ბუნებრივი ენის გამოყენებით SQL ოპერატორების გენერირება, Hugging Face მონაცემთა ნაკრებებთა
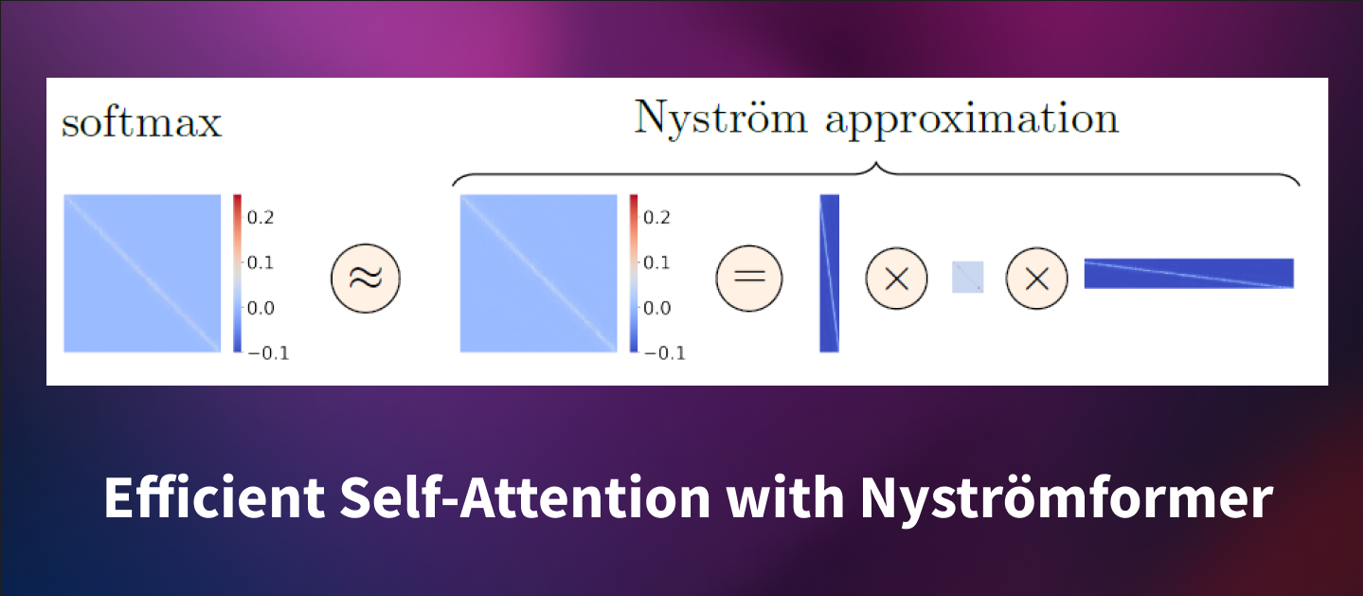
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ

Wiz-ისა და Hugging Face-ის ერთობლივი ძალისხმევა AI პლატფორმის უსაფრთხოების გასაუმჯობესებლად
Hugging Face-მა, Wiz-თან თანამშრომლობით, მნიშვნელოვნად გააუმჯობესა თავისი ხელოვნური ინტელექტის პლატფორმის უსაფრთხოება. Wiz-ის მკვლევრების მიერ გამოვლენილი დაუცველობების საფუძველზე, Hugging Face-მა დანერგა Wiz-ის გადაწყვეტილებები დაუცველობის მართვისა და ღრუბლოვანი უსაფრთხოების მდგომარეობის მართვისთვის (CSPM). სტატია დეტალურად განიხილავს ამ ინტეგრაციის სარგებელს, განსაკუთრებით pickle ფაილებთან დაკავშირებულ რისკებსა და Hugging Face-ის ვალდებულებას, დაიცვას მომხმარებლები და ხელი შეუწყოს AI/ML-ის დემ
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
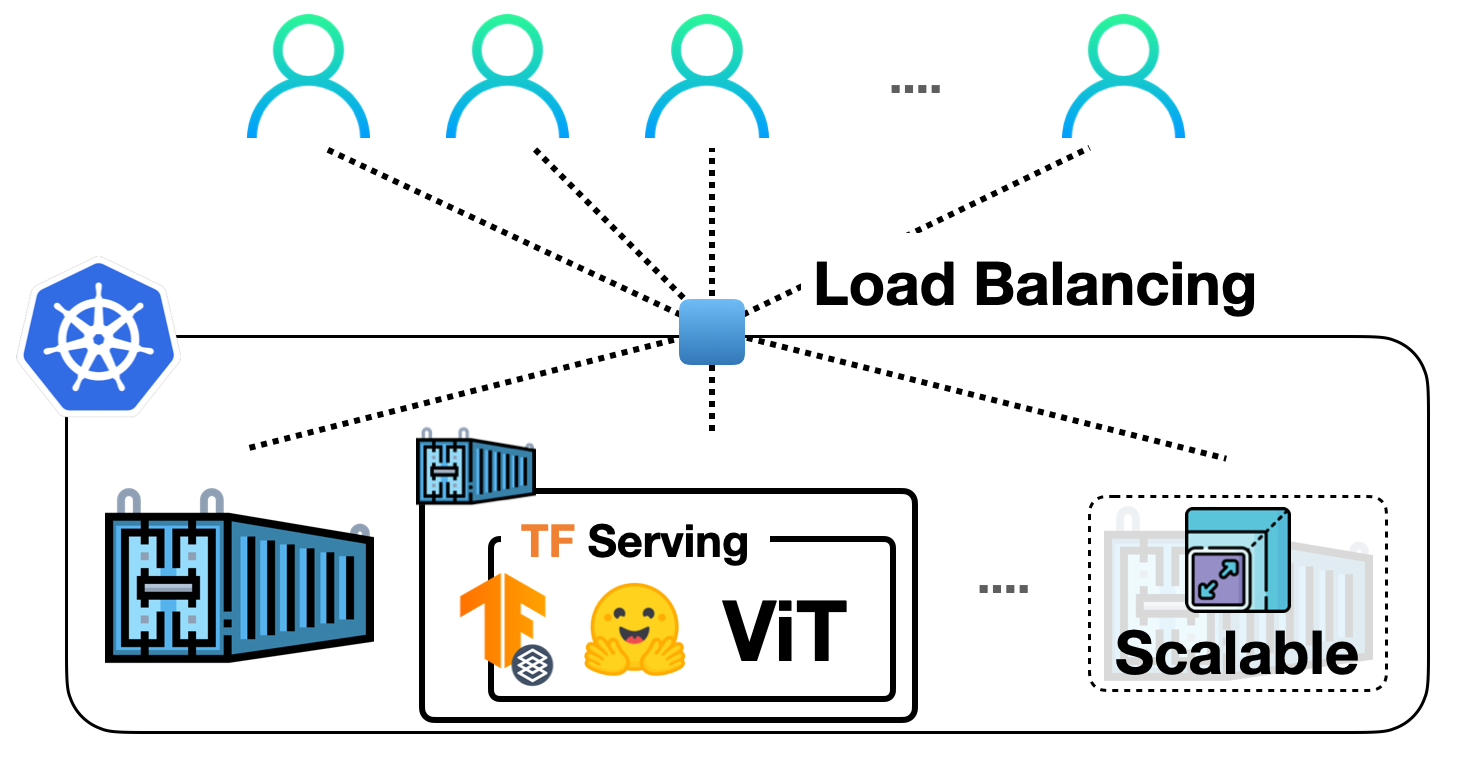
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr

AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ

Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.
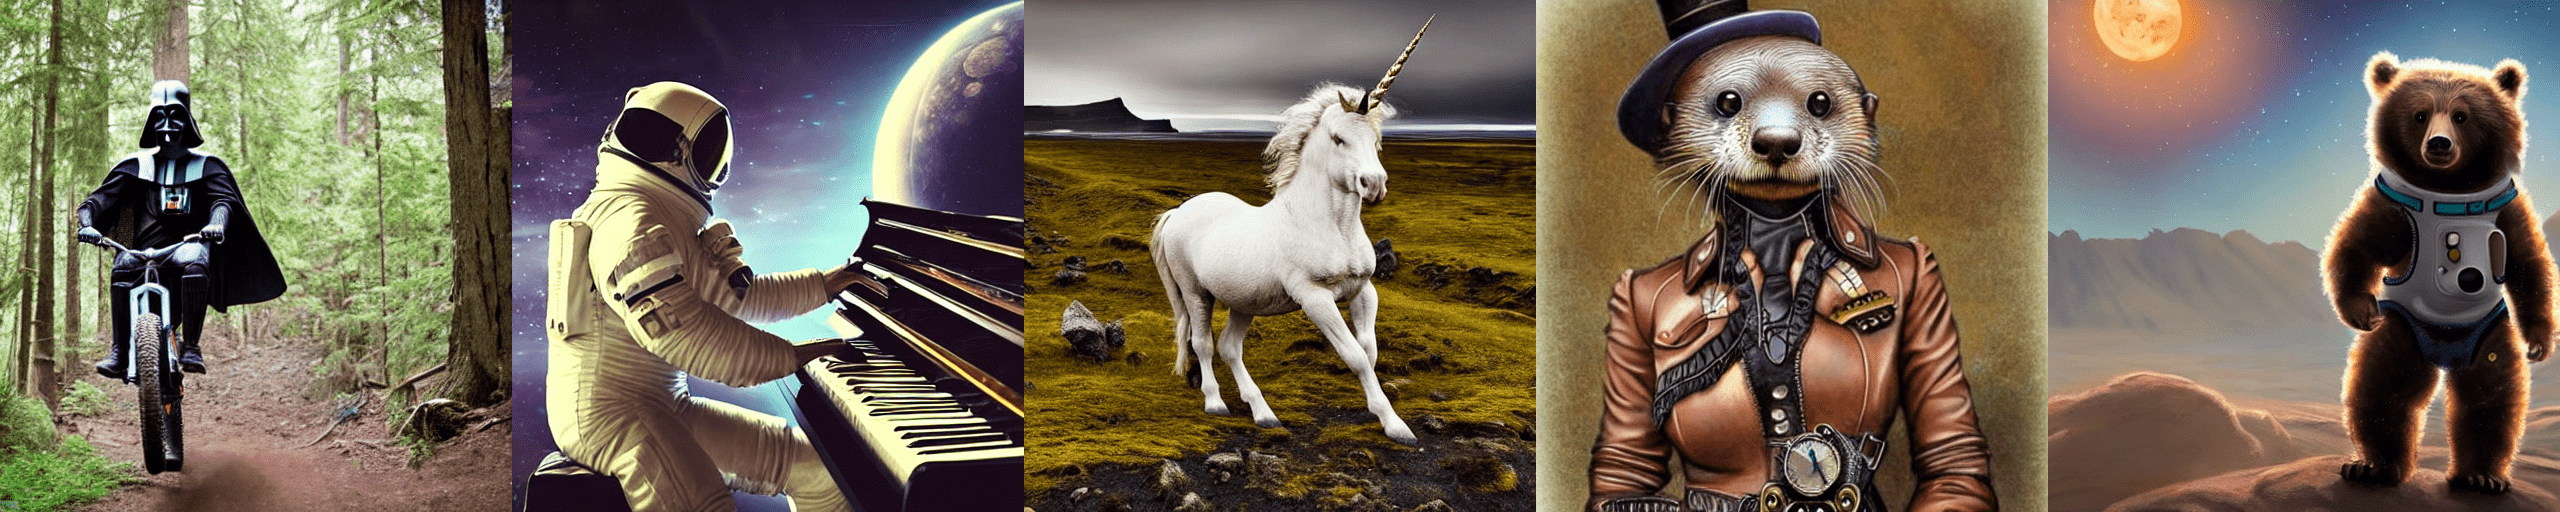
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g
როგორ მოვახდინოთ ცილების სტრუქტურის ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js-ის გამოყენებით
ამ სტატიაში აღწერილია, თუ როგორ შეიძლება ცილის სტრუქტურების ინტერაქტიული ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js ბიბლიოთეკისა და Gradio-ს გამოყენებით. ცილები სასიცოცხლოდ მნიშვნელოვანია, ხოლო მანქანური სწავლა გვეხმარება ახალი ცილების შექმნაში. სტრუქტურის გაგება გადამწყვეტია მათი ფუნქციისთვის. სტატია დეტალურად განიხილავს დემო აპლიკაციის შექმნას PDB კოდის ან ფაილის გამოყენებით, ტექნიკურ ასპექტებს iframe-ებით და ბრაუზერის უსაფრთხოების წესებს. მოცემულია ინტეგრაციის მეთოდები ML მოდელებთან და მოწი
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები
ავარჯიშეთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი: როგორ აამუშავოთ Half-Cheetah
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს, თუ როგორ უნდა ავარჯიშოთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი ნულიდან. ის განმარტავს Decision Transformer-ის ძირითად კონცეფციას, რომელიც აძლიერებს სწავლის პრობლემას პირობით-თანმიმდევრობის მოდელირების ამოცანად გარდაქმნის გზით, რათა წარმოქმნას მომავალი ქმედებები სასურველი შედეგების, წარსული მდგომარეობებისა და ქმედებების საფუძველზე. გაკვეთილი ფოკუსირებულია ოფლაინ მიდგომაზე, Google Colab-ის, 🤗 Trainer-ის და სპეციალური მონაცემთა კოლატორის გამოყ