მანქანური სწავლება ფინანსებში: გამოწვევები, ნდობა და ექსპერტების შეხედულებები
ფინანსური სექტორის მანქანური სწავლების დირექტორები უნიკალური გამოწვევების წინაშე დგანან, მათ შორის მოძველებული სისტემების მართვა, ინტერპრეტირებადი მოდელების დანერგვა და მომხმარებლის ნდობის შენარჩუნება მკაცრი რეგულაციების პირობებში. ეს სტატია წარმოადგენს წამყვანი ექსპერტების შეხედულებებს U.S. Bank-დან, კანადის სამეფო ბანკიდან, Moody's Analytics-დან და Bloomberg AI-დან. ისინი განიხილავენ მანქანური სწავლების ტრანსფორმაციულ ძალას, ფინანსურ გადაწყვეტილებებში ნდობის შესახებ მიმდინარე დისკუსიას და იმ ს
ტექსტის გენერაციის პაიპლაინი Intel® Gaudi® 2-ზე: მოქნილობა და Llama 2-ის ინტეგრაცია
წარმოდგენილია პერსონალური პაიპლაინის კლასი, რომელიც შექმნილია Intel® Gaudi® 2 AI აქსელერატორისთვის, რაც უზრუნველყოფს ტექსტის გენერაციის მოქნილობას, სიმარტივეს და აბსტრაქციის მაღალ დონეს. ის მხარს უჭერს Llama 2 მოდელებს და ინტეგრირდება LangChain-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შექმნან ტექსტი, როგორც სტანდარტული სკრიპტებით, ასევე საკუთარ პროექტებში. სტატია დეტალურად აღწერს წვდომის მიღების, ინსტალაციისა და გამოყენების ნაბიჯებს, ასევე Llama 2-ის ლიცენზირების მნიშვნელოვან დეტალებს.
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ
ხელოვნური ინტელექტი ვებ-დიზაინს HTML კოდში აქცევს: WebSight და Sightseer
ვებ-დიზაინის HTML კოდში გადაქცევა ხშირად გამოცდილ დეველოპერს მოითხოვს. ეს სტატია იკვლევს, თუ როგორ შეუძლიათ ვიზუალური ენის მოდელებს (VLMs) ამ პროცესის გამარტივება. წარმოდგენილია WebSight მონაცემთა ბაზა და Sightseer მოდელი, რომლებიც ხელოვნურ ინტელექტს საშუალებას აძლევენ ვიზუალური დიზაინი ფუნქციურ HTML კოდში გადაიყვანოს, რაც ვებ-დეველოპმენტს უფრო ეფექტურსა და ხელმისაწვდომს ხდის.

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო
Sentence Transformers-ის შესწავლა: ნულიდან პროექტამდე
ეს პოსტი წარმოგიდგენთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის (ST) გამოყენებით ახალი ბიბლიოთეკის დაუფლებისთვის ნულიდან. განვიხილავთ ST-ის ძირითად ფუნქციონალს, მათ შორის წინადადების ვექტორების (embeddings), სემანტიკური ძიებისა და კოსინუსური მსგავსების კონცეფციებს. ხაზგასმულია, თუ რატომ არის ST ღირებული ინსტრუმენტი ხელმისაწვდომობის, სწავლის ეფექტურობისა და მრეწველობაში გამოყენების თვალსაზრისით. სტატია ასევე გვთავაზობს გამოცდილ სტრატეგიას პირველი დამოუკიდებელი პროექტის განსახორციელებლად და
ღრმა გაძლიერებითი სწავლება: პოლიტიკაზე დაფუძნებული მეთოდები და Reinforce
სტატია მიმოიხილავს პოლიტიკაზე დაფუძნებულ მეთოდებს ღრმა გაძლიერებით სწავლებაში, უპირისპირებს რა მათ ღირებულებაზე დაფუძნებულ მიდგომებს. განმარტებულია, რომ პოლიტიკაზე დაფუძნებული მეთოდები უშუალოდ ოპტიმიზაციას უკეთებენ პოლიტიკას შუალედური ღირებულების ფუნქციის გარეშე, კონკრეტულად კი ალგორითმ Reinforce-ის მაგალითზე. ხაზგასმულია ძირითადი უპირატესობები, როგორიცაა ინტეგრაციის სიმარტივე, სტოქასტური პოლიტიკის სწავლის უნარი და ისეთი პრობლემების გადაჭრა, როგორიცაა აღქმითი ალიასინგი, ასევე უწყვეტი მოქმედებები

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti
BLOOM: 176 მილიარდი პარამეტრის მოდელის შექმნის საინჟინრო მიღწევები და ტექნოლოგიები
პროექტი, რომელიც Hugging Face-ის თანადამფუძნებელმა თომას ვოლფმა წამოიწყო, მიზნად ისახავდა ერთ-ერთი უდიდესი მრავალენოვანი მოდელის შექმნას და მის ხელმისაწვდომობას ყველასთვის. ეს სტატია ფოკუსირებულია 176 მილიარდი პარამეტრის BLOOM მოდელის წვრთნის საინჟინრო ასპექტებზე, ხაზს უსვამს ექსპერტებისა და კომპანიების ერთობლივ ძალისხმევას. განხილულია ფრანგული სუპერკომპიუტერის Jean Zay გამოყენება და მოწინავე Megatron-DeepSpeed ფრეიმვორკი, რომელიც 3D პარალელიზმს იყენებს ეფექტური წვრთნისთვის.
როგორ გავხადოთ ხელოვნური ინტელექტის მოდელები უფრო სანდო: დინამიური მოწინააღმდეგე მონაცემთა შეგროვება MNIST-ის მაგალითზე
სტატიკური ბენჩმარკები ხელოვნური ინტელექტის მოდელების შეფასებისას მრავალ პრობლემას ქმნის. სტატია განიხილავს დინამიურ მოწინააღმდეგე მონაცემთა შეგროვების (DADC) მეთოდს, რომელიც ამცირებს ამ ნაკლოვანებებს და ხელს უწყობს სანდო მოდელების შექმნას. MNIST-ის მაგალითზე ნაჩვენებია, თუ როგორ შეუძლიათ ადამიანებს მოდელების „მოტყუება“ და მათი გაწვრთნა უფრო გამძლე სისტემების მისაღებად.
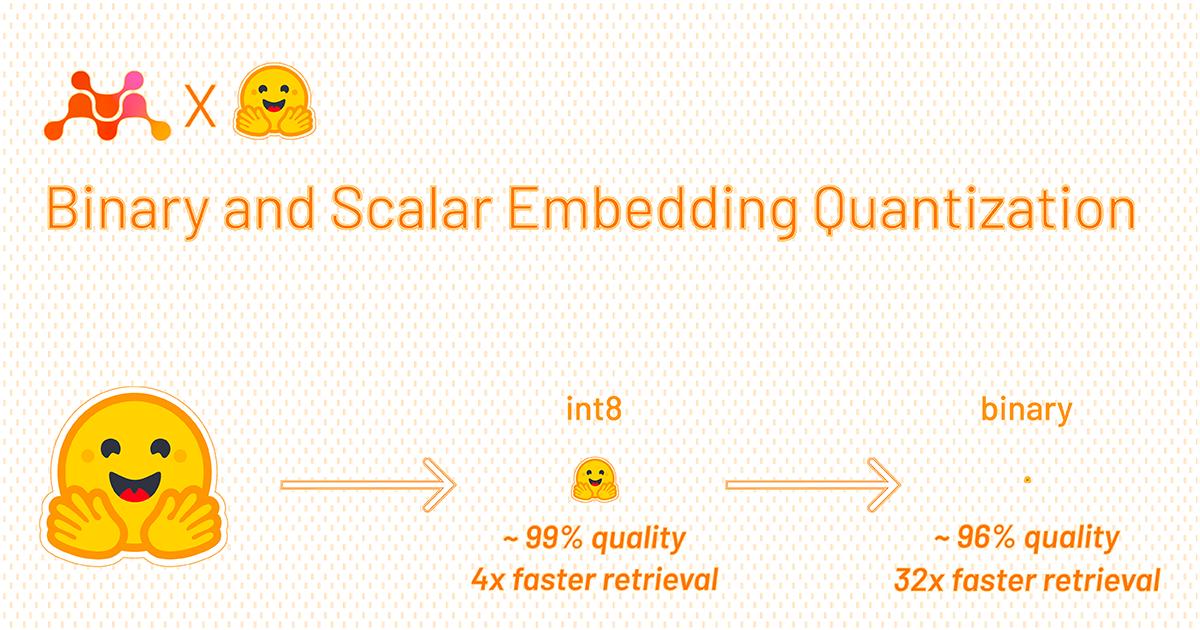
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების