ღრმა განმტკიცებითი სწავლება: ხელოვნური ინტელექტის მომავალი (სრული კურსის პირველი ნაწილი)
ეს სტატია ღრმა განმტკიცებითი სწავლების კურსის შესავალი ნაწილია, რომელიც ხელოვნური ინტელექტის ერთ-ერთ ყველაზე მომხიბვლელ სფეროს ეხება. აქ განმარტებულია, თუ როგორ სწავლობს აგენტი გარემოში ქცევას მოქმედებების შესრულებითა და შედეგების დანახვით. განიხილება დარგის მნიშვნელოვანი მიღწევები და მოწოდებულია დეტალური ინფორმაცია უფასო კურსის შესახებ, სადაც შეისწავლით თეორიასა და პრაქტიკას ცნობილი ბიბლიოთეკების გამოყენებით.

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M

კვანტიზაციის ბეკენდები Hugging Face Diffusers-ში: მეხსიერების ოპტიმიზაცია და ხელმისაწვდომობა
ეს სტატია იკვლევს კვანტიზაციის სხვადასხვა ბეკენდს (მაგ., bitsandbytes, GGUF, torchao, Quanto, FP8) Hugging Face Diffusers-ში, რომლებიც დიდ ხელოვნური ინტელექტის მოდელებს უფრო ხელმისაწვდომს ხდის მეხსიერების მოხმარების მნიშვნელოვანი შემცირებით. ის წარმოადგენს აღქმის ტესტს, სადაც მომხმარებლებს შეუძლიათ შეადარონ ორიგინალური და კვანტიზებული მოდელების გამომუშავება განსხვავებების იდენტიფიცირებისთვის, რომლებიც ხშირად უმნიშვნელოა, განსაკუთრებით 8-ბიტიანი კვანტიზაციის დროს. სტატია ასევე დეტალურად აღწერს მე
Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G
PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-

მანქანური სწავლების (ML) დირექტორების ხედვები: SaaS, გამოწვევები და მომავალი
გაეცანით მანქანური სწავლების (ML) დირექტორების უნიკალურ პერსპექტივებს ხელოვნური ინტელექტის განვითარებაზე. ჩვენი სერიის მეორე ნაწილში, რომელიც SaaS სექტორზეა ორიენტირებული, წამყვანი სპეციალისტები გვიზიარებენ თავიანთ შეხედულებებს ML-ის მიმდინარე მდგომარეობაზე, ყველაზე დიდ გამოწვევებსა და სამომავლო პერსპექტივებზე. სტატიაში წარმოდგენილია Salesforce-ის კიბერუსაფრთხოების გუნდის ლიდერის, ომარის, და Amplitude-ის მონაცემთა მეცნიერებისა და ML-ის ხელმძღვანელის, ცაო (დანიკა) სიაოს ბიოგრაფიები და მათი მოსაზრ
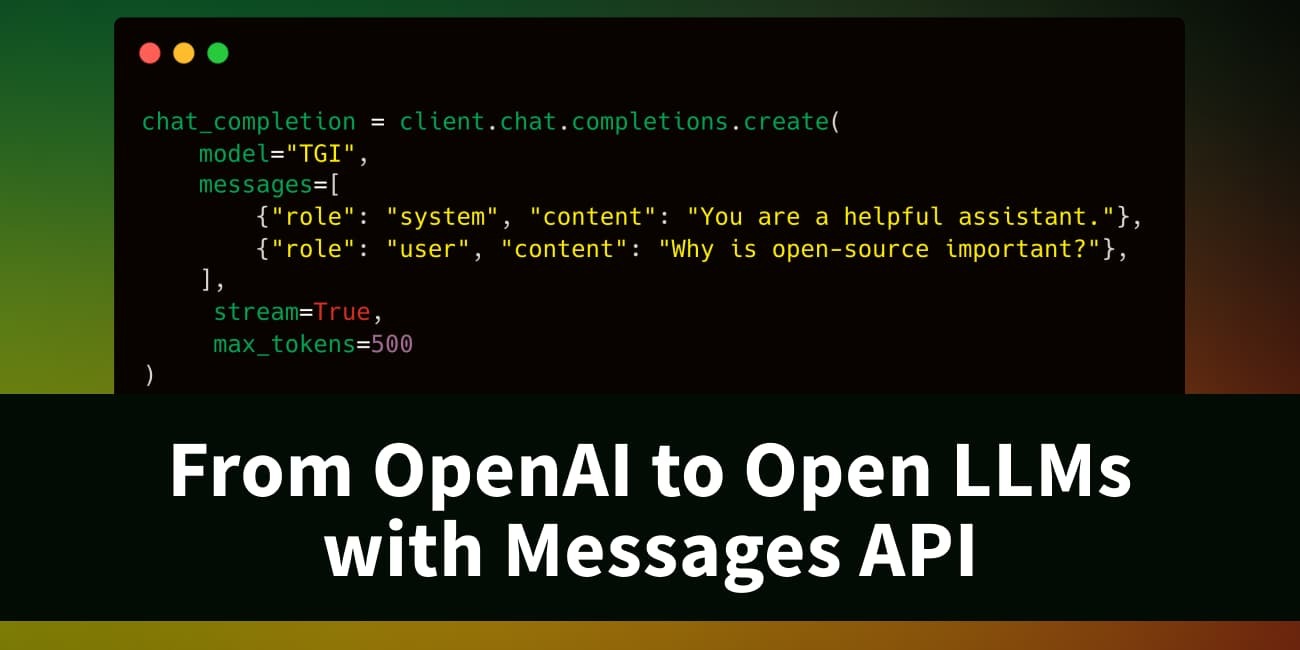
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ
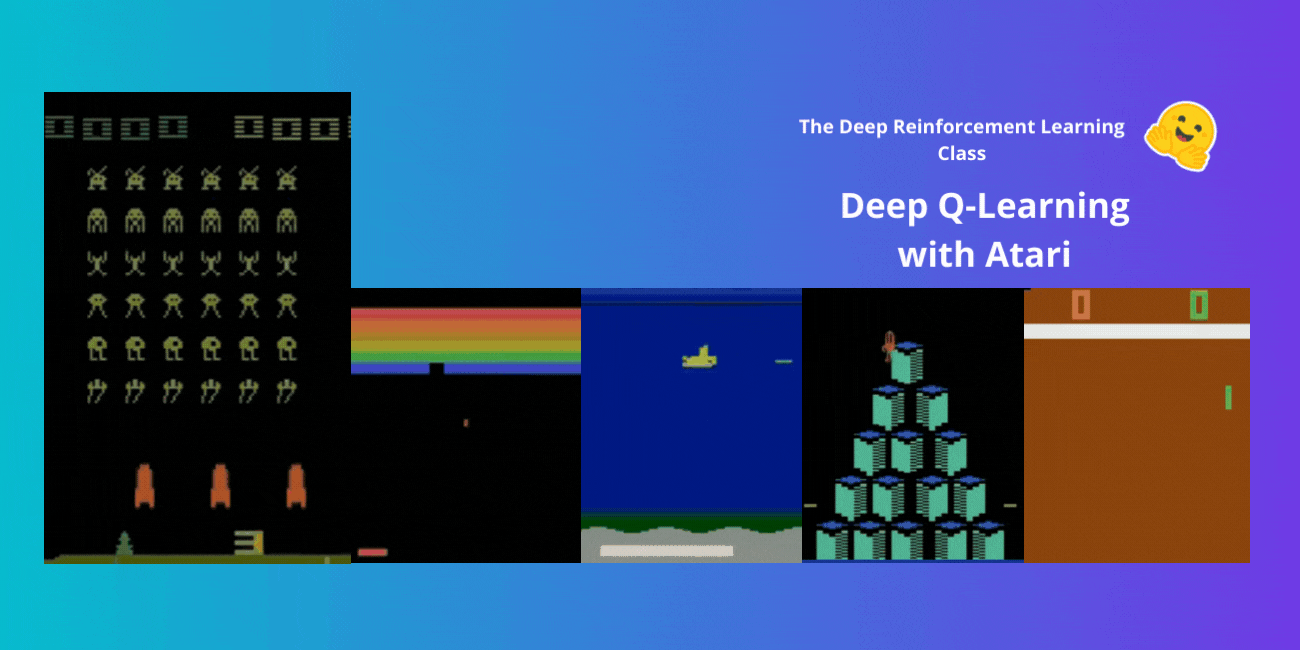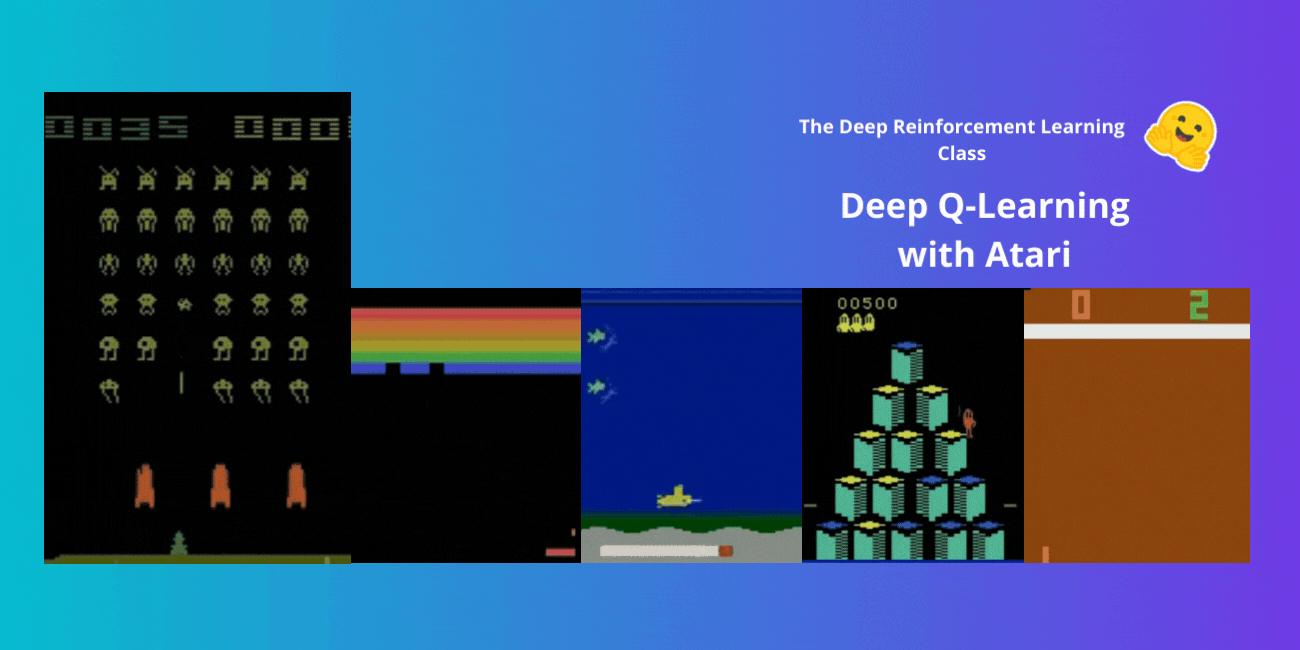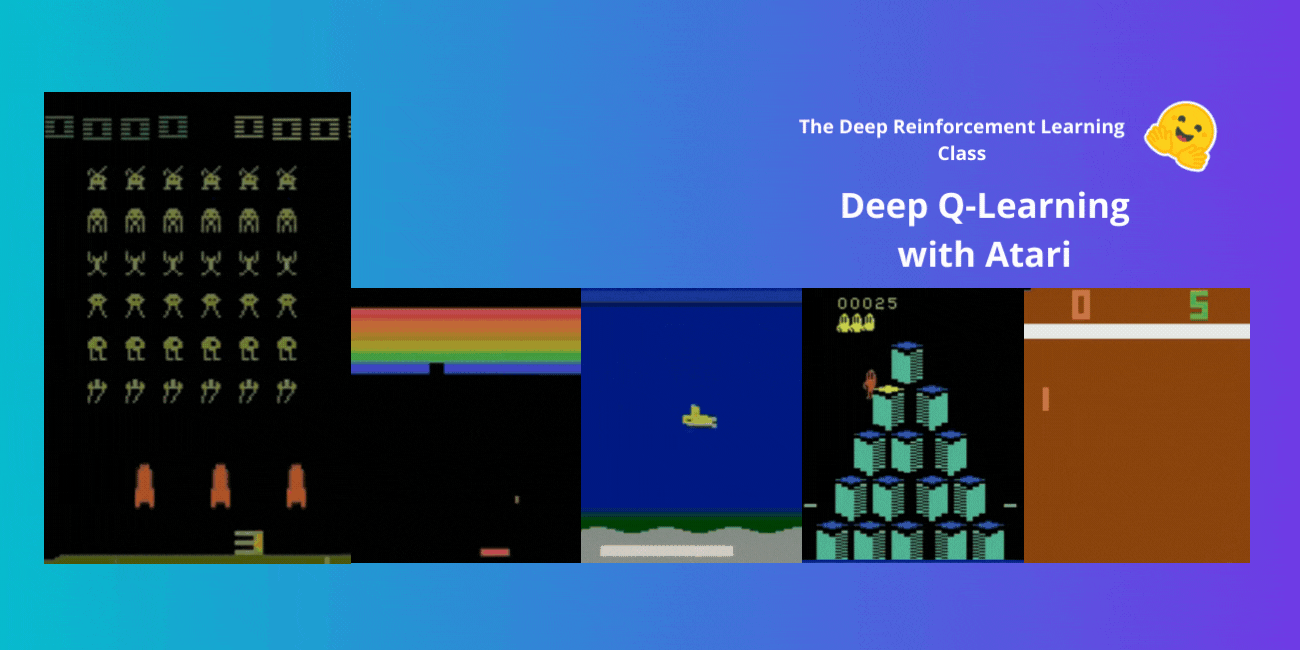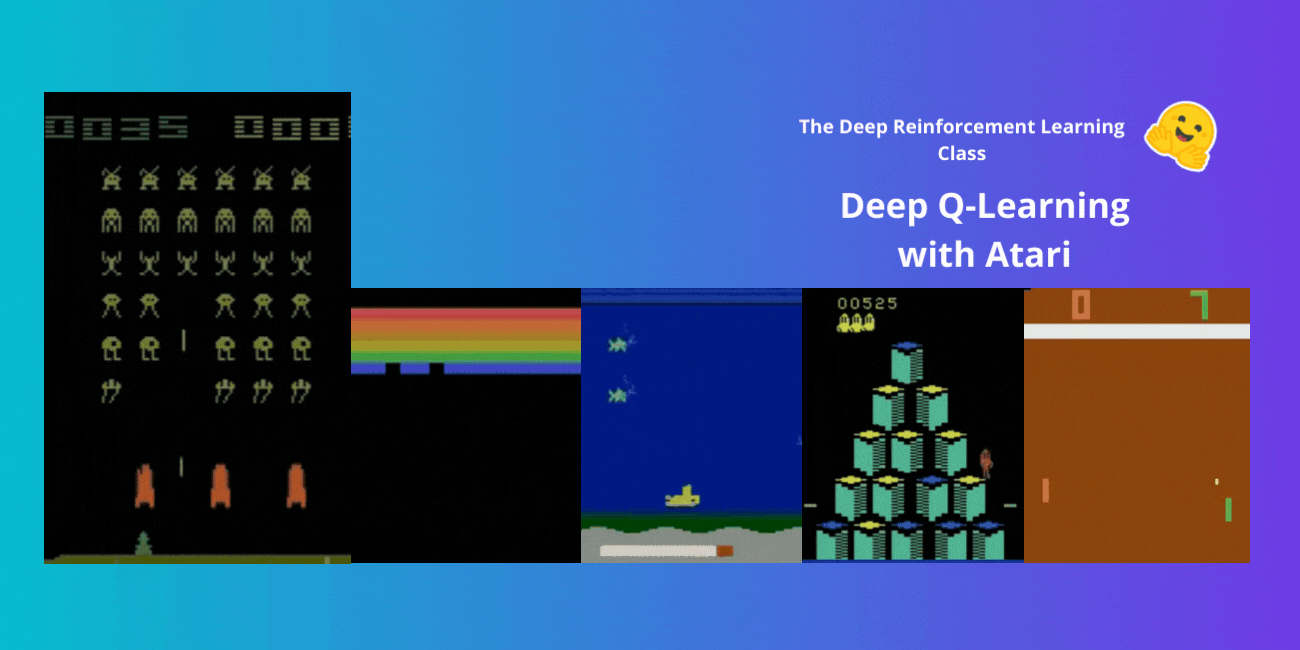
ღრმა Q-სწავლება: როგორ ვავარჯიშოთ აგენტები Atari-ს თამაშებში
ეს სტატია ღრმა გაძლიერებული სწავლების კურსის ნაწილია. განვიხილავთ, თუ როგორ გადადის ტრადიციული Q-სწავლება, რომელსაც შეზღუდვები აქვს დიდი მდგომარეობათა სივრცეების შემთხვევაში, ღრმა Q-სწავლებაში. ეს უკანასკნელი იყენებს ნერვულ ქსელებს Q-მნიშვნელობების აპროქსიმაციისთვის, რაც საშუალებას გვაძლევს მოვამზადოთ აგენტები რთული გარემოებისთვის, როგორიცაა Atari-ს თამაშები. სტატია დეტალურად აღწერს Deep Q-Network-ის არქიტექტურას, მონაცემთა წინასწარ დამუშავებას და ჩარჩოების დაწყობის მნიშვნელობას დროითი შეზღუდვებ

ხელოვნური ინტელექტის მიერ გენერირებული კონტენტის წყლის ნიშნები და მისი ავთენტურობის დაცვა
ამ ბლოგპოსტში განვიხილავთ ხელოვნური ინტელექტის (AI) მიერ გენერირებული კონტენტის წყლის ნიშნების დამატების მეთოდებს, მათ უპირატესობებსა და ნაკლოვანებებს, ასევე Hugging Face Hub-ზე არსებულ ინსტრუმენტებს. სტატია ასევე აანალიზებს კონტენტის ავთენტურობის დაცვის სხვა ტექნიკებს, როგორიცაა გამოსახულების ცვლილება და „მოწამვლა“, და მიმოიხილავს ღია და დახურული სისტემების გამოწვევებს სხვადასხვა მოდიფიკაციისთვის.
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
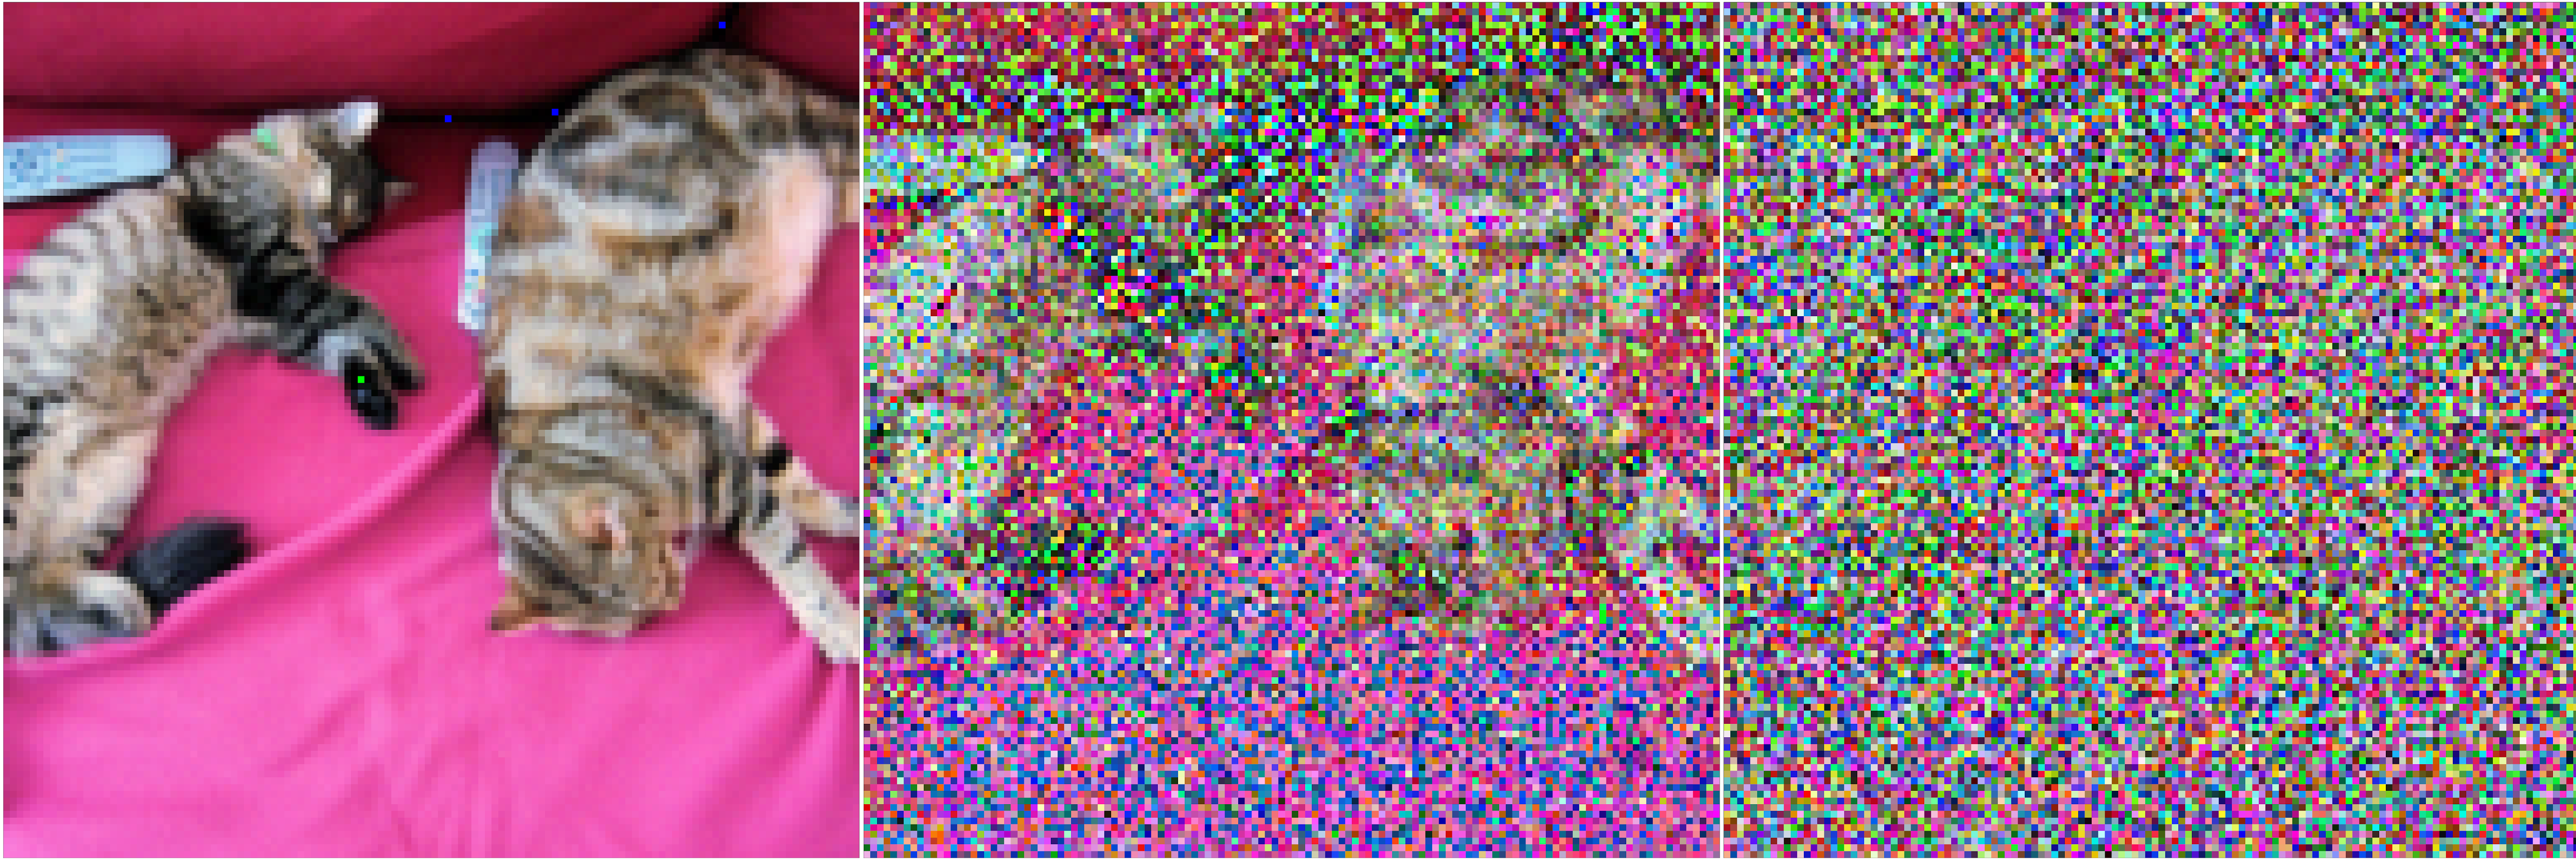
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.

vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო
მანქანური სწავლება ფინანსურ სექტორში: გამოწვევები, ნდობა და ინოვაციების როლი
სტატია განიხილავს მანქანური სწავლების (ML) დირექტორების უნიკალურ გამოწვევებს ფინანსურ სექტორში, მათ შორის მოძველებული სისტემების მართვას, მოდელების ინტერპრეტაციას და მომხმარებელთა ნდობის შენარჩუნებას მკაცრი რეგულაციების პირობებში. ხაზგასმულია, თუ როგორ გამოიწვია ML-მა დისკუსიები ფინანსურ გადაწყვეტილებებში ნდობის შესახებ და გახდა გარდამტეხი ძალა, რამაც ახალი ბიზნეს შესაძლებლობები შექმნა. წამყვანი ფინანსური ინსტიტუტების ექსპერტები იზიარებენ თავიანთ შეხედულებებს ამ გამოწვევებზე, განსაკუთრებით მოძვე