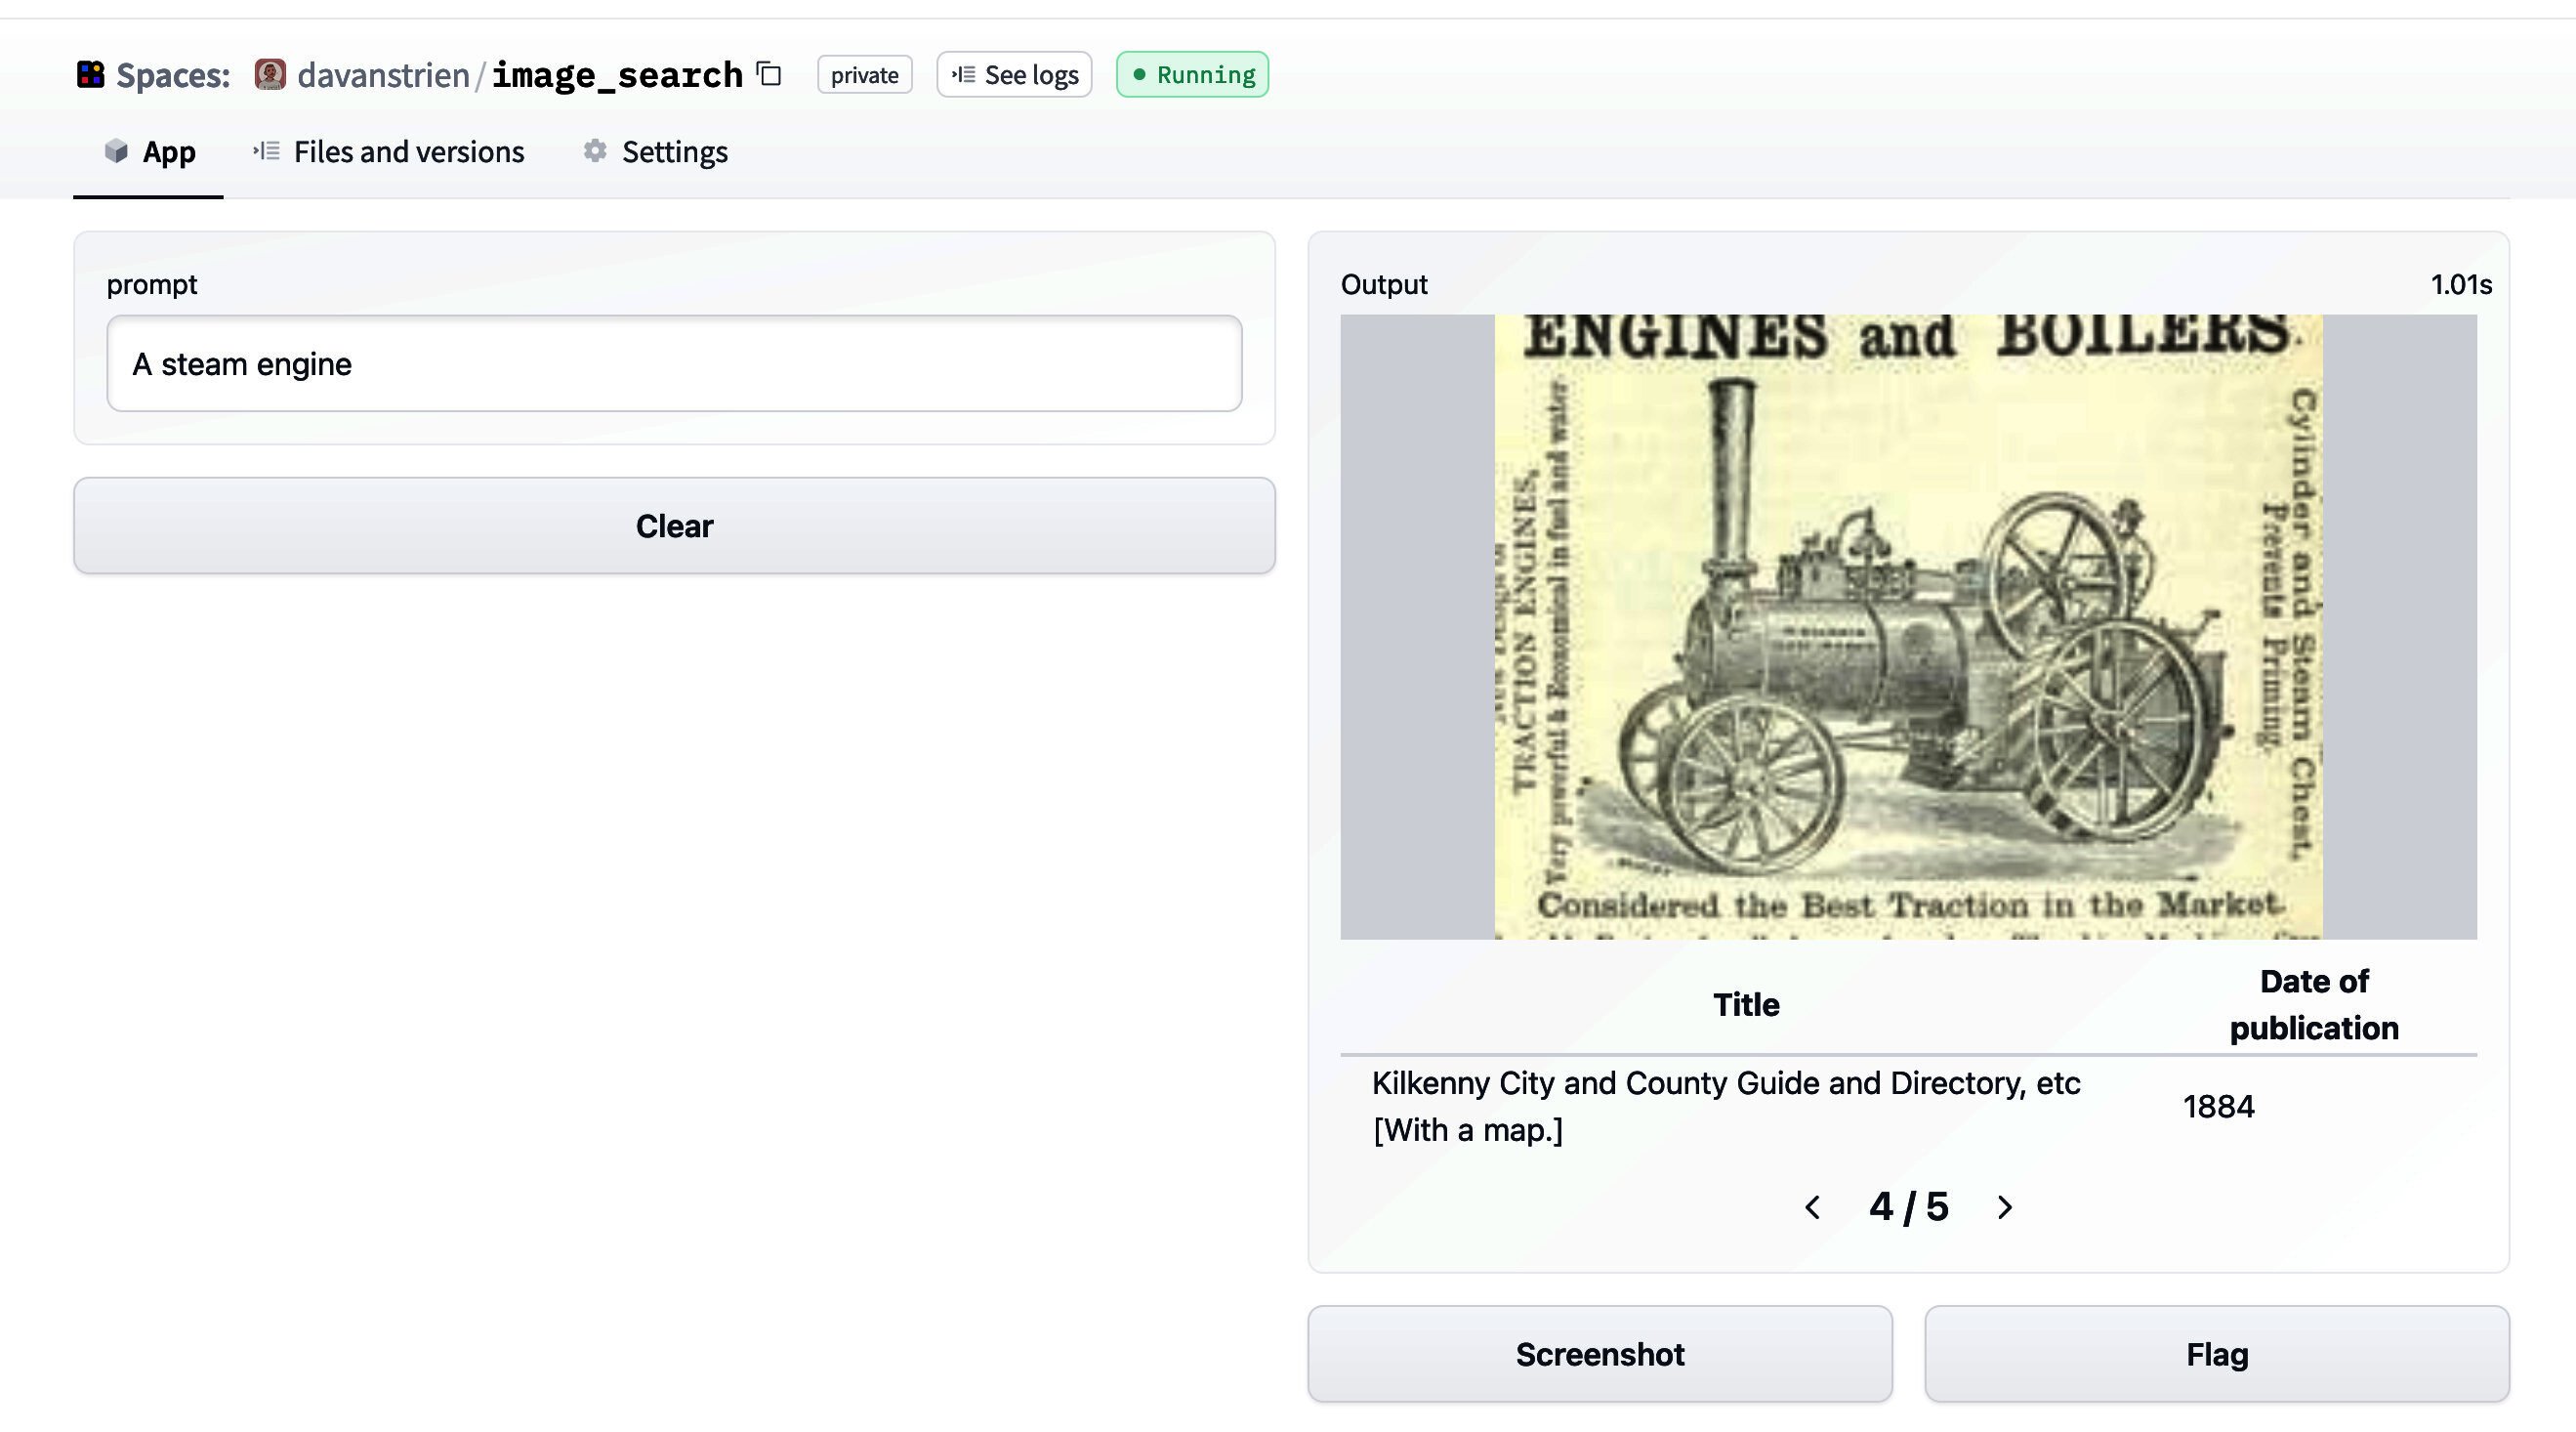
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad
Gradio: მეტი ვიდრე უბრალოდ UI ბიბლიოთეკა – ხელოვნური ინტელექტის აპლიკაციების მძლავრი ჩარჩო
Gradio, რომელიც ხშირად მხოლოდ UI ბიბლიოთეკად აღიქმება, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ინტერფეისებისა და API-ების მეშვეობით ურთიერთობისთვის, რაც უზრუნველყოფს მაღალ წარმადობას, უსაფრთხოებასა და რეაგირებას. ეს სტატია წარმოგიდგენთ მის უნიკალურ მახასიათებლებს, რომლებიც გადამწყვეტია თანამედროვე AI აპლიკაციების შესაქმნელად.

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
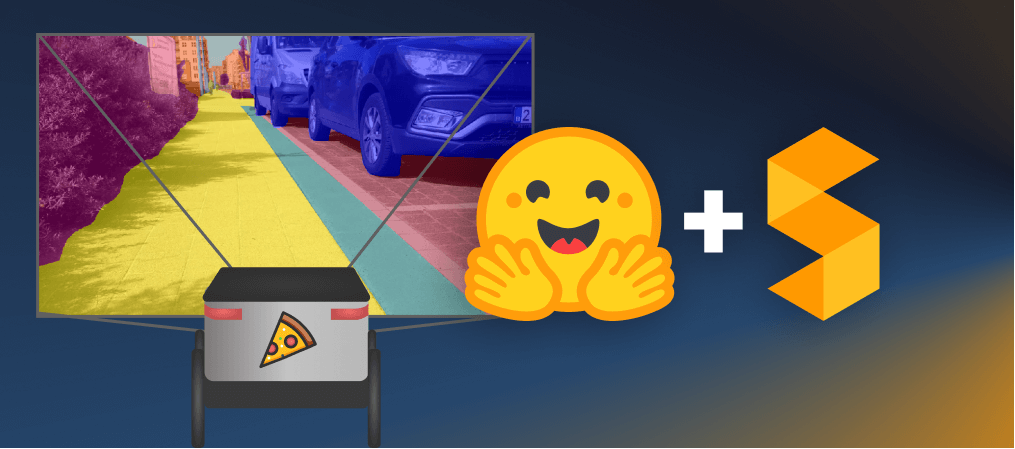
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
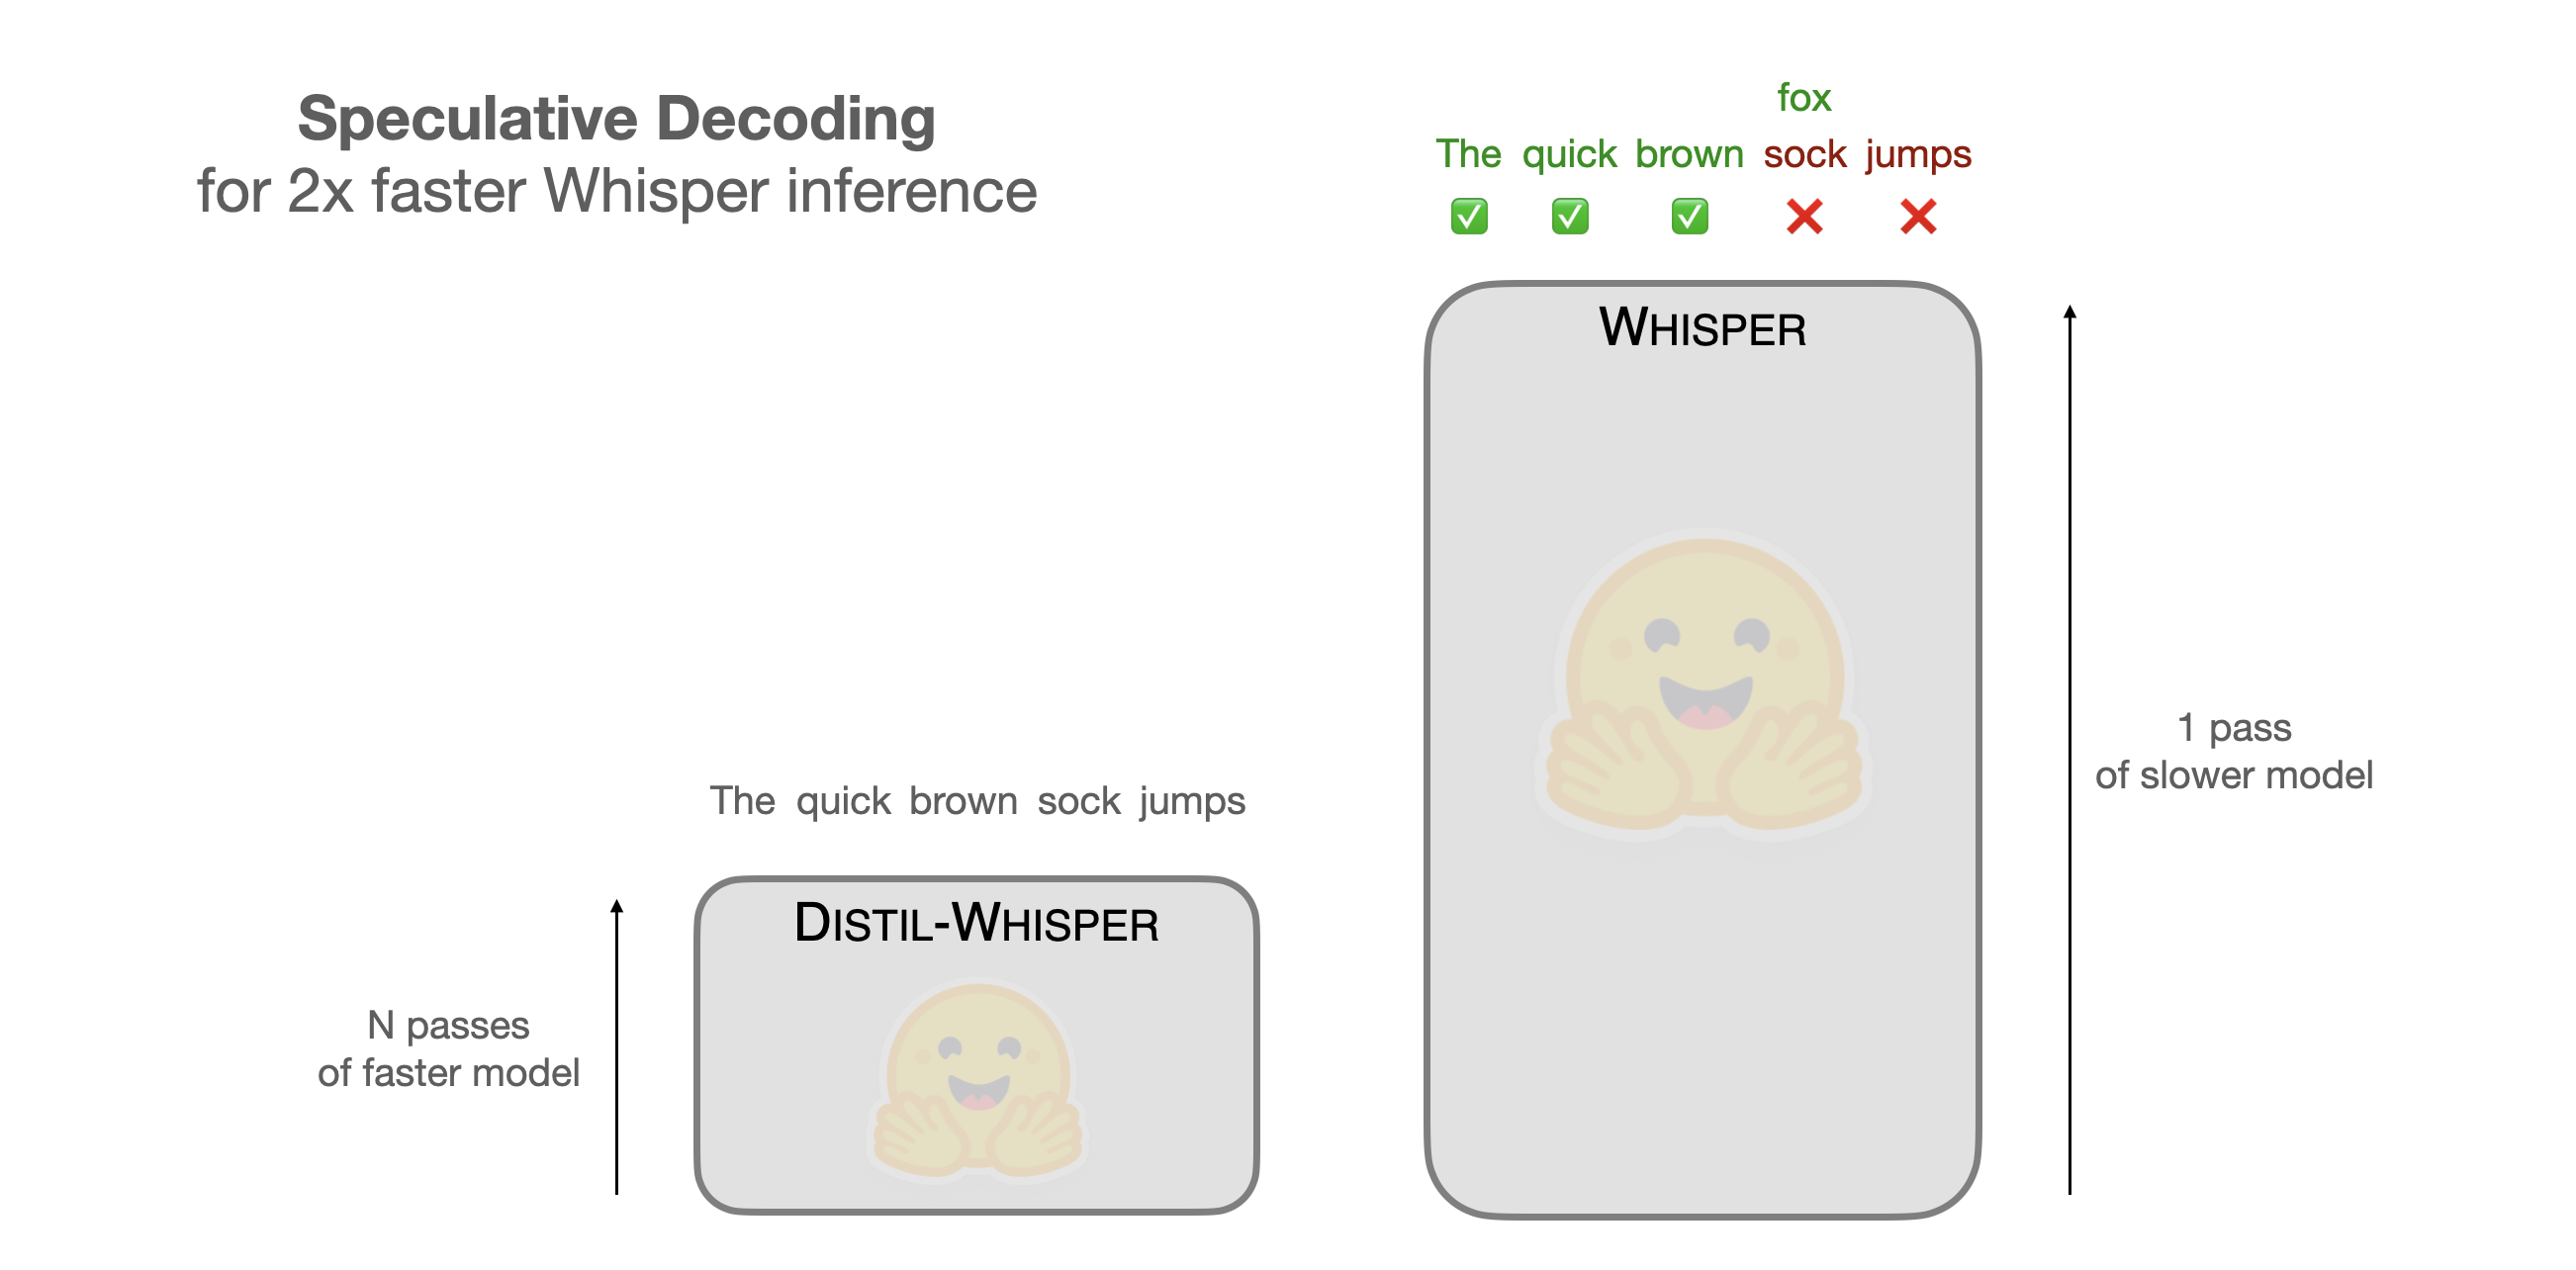
Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი

რობოტიკის განზოგადების გამოწვევა: მონაცემების მნიშვნელობა და LeRobot-ის წვლილი
ვიზუალურ-ენობრივ-მოქმედებითი (VLA) მოდელების მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, თუმცა ჭეშმარიტი განზოგადება ახალ გარემოში კვლავ უდიდეს გამოწვევად რჩება. ეს სტატია ხაზს უსვამს, რომ განზოგადება ძირითადად მონაცემების ფენომენია და არა მხოლოდ მოდელის თვისება. განხილულია არსებული, ხშირად აკადემიური, მონაცემთა ნაკრებების შეზღუდვები და ხაზგასმულია მრავალფეროვანი, რეალური სამყაროს მონაცემების საჭიროება. LeRobot აქტიურად მუშაობს მონაცემთა შეგროვების დემოკრატიზაციაზე, რათა ხელი
რობოტების გენერალიზაცია: მონაცემებზე ორიენტირებული მიდგომა და LeRobot-ის როლი
Vision-Language-Action (VLA) მოდელებში მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, მაგრამ გამოწვევად რჩება გენერალიზაცია ახალ გარემოში და უცნობ ობიექტებთან. ეს მოითხოვს არა მხოლოდ მტკიცე უნარებს, არამედ სამყაროს საღი აზრისეულ გაგებას, რაც ხშირად შეფერხებულია მრავალფეროვანი მონაცემების ნაკლებობით. სტატია ხაზს უსვამს, რომ გენერალიზაცია მონაცემთა ფენომენია და არა მხოლოდ მოდელის თვისება. LeRobot-ის ინიციატივა მიზნად ისახავს რობოტიკის მონაცემთა შეგროვების დემოკრატიზაციას, რათა შეიქ
მანქანური სწავლების მოდელების ნახშირბადის კვალის თვალყურის დევნება და შემცირება
ეს სტატია განიხილავს მანქანური სწავლების მოდელების ვარჯიშისა და განთავსების ეკოლოგიურ ზემოქმედებას, კერძოდ, მათ ნახშირბადის ემისიებს. წარმოდგენილია ისეთი ხელსაწყოები, როგორიცაა huggingface_hub ბიბლიოთეკა და codecarbon ინტეგრაცია, რომლებიც ხელს უწყობენ ამ ემისიების თვალყურის დევნას, ანგარიშგებას და მართვას, რითაც ხდება ეკო-მეგობრული AI-ის განვითარების ხელშეწყობა.

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.
როგორ გავიგოთ მომხმარებლის საჭიროებები HuggingFace AutoTrain-ისა და Kili-ის დახმარებით: აქტიური სწავლების დანერგვა
ეს სტატია იკვლევს ავტომატური მანქანური სწავლების (Auto ML) და აქტიური სწავლების გამოყენებას მომხმარებლის საჭიროებების გასაგებად, ტექსტის კლასიფიკაციისა და სენტიმენტების ანალიზზე ფოკუსირებით. ის დეტალურად აღწერს, თუ როგორ უნდა შეიქმნას აქტიური სწავლების მილსადენი HuggingFace AutoTrain-ისა და Kili-ის, მონაცემებზე ორიენტირებული AI ვარჯიშის პლატფორმის გამოყენებით. პროცესი მოიცავს მომხმარებლის მიმოხილვების ანოტირებას, კლასიფიკაციის მოდელების შექმნას (როგორც AutoTrain-ით, ისე მის გარეშე) და სენტიმენტე

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში