
Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.
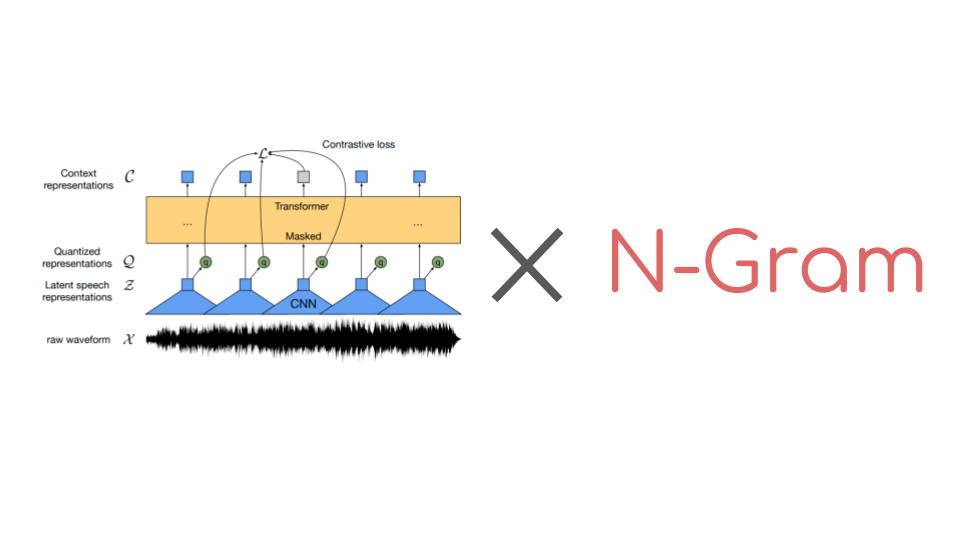
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე

HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა
რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
Unsloth: დააჩქარეთ LLM მოდელების დახვეწა Hugging Face-ის ეკოსისტემაში
Unsloth არის მსუბუქი ბიბლიოთეკა, რომელიც შექმნილია დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესის დასაჩქარებლად. ის სრულად თავსებადია Hugging Face-ის ეკოსისტემასთან და აქტიურად ვითარდება Unsloth-ის გუნდისა და ღია წყაროს საზოგადოების მიერ. ბიბლიოთეკა მხარს უჭერს NVIDIA GPU-ებს, Llama-სა და Mistral-ის არქიტექტურებს, რაც უზრუნველყოფს მნიშვნელოვნად უფრო სწრაფ დახვეწას და მეხსიერების ნაკლებ გამოყენებას სტანდარტულ QLoRA-სთან შედარებით, სიზუსტის დაკარგვის გარეშე.
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
ხედვა-ენობრივი მოდელების ევოლუცია: სიახლეები, ტენდენციები და მომავალი
ხედვა-ენობრივი მოდელები (VLMs) დღესდღეობით ერთ-ერთი ყველაზე განხილვადი თემაა. 2024 წლის აპრილის ბლოგ პოსტში ვრცლად ვისაუბრეთ VLMs-ზე, მათ შორის LLaVA-ზე, პირველ წარმატებულ ღია წყაროს ხედვა-ენობრივ მოდელზე. მას შემდეგ მრავალი რამ შეიცვალა: მოდელები უფრო მცირე, მაგრამ ძლიერი გახდა, გაჩნდა ახალი არქიტექტურები და შესაძლებლობები (არგუმენტაცია, მოქმედება, გრძელი ვიდეოების გაგება). პარალელურად, განვითარდა ახალი პარადიგმები, როგორიცაა მულტიმოდალური ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) და მუ
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ
DecodingTrust: LLM-ების სანდოობის შეფასების პლატფორმა და ახალი უსაფრთხოების ლიდერბორდი
2023 წელს Secure Learning Lab-მა წარმოადგინა DecodingTrust, პირველი ყოვლისმომცველი პლატფორმა დიდი ენობრივი მოდელების (LLM) სანდოობის შესაფასებლად. პლატფორმა მოიცავს რვა პერსპექტივას, მათ შორის ტოქსიკურობას, სტერეოტიპულ მიკერძოებას, კონფიდენციალურობასა და ეთიკას, და იყენებს ინოვაციურ „წითელი გუნდის“ (red-teaming) მეთოდოლოგიებს. ცოტა ხნის წინ, გამოქვეყნდა ახალი LLM უსაფრთხოების ლიდერბორდი, რომელიც LLM-ების უსაფრთხოების შეფასებაზეა ორიენტირებული.
დიდი ენობრივი მოდელების „ჰალუცინაციების“ საზომი ლიდერბორდი
„ჰალუცინაციების ლიდერბორდი“ წარმოადგენს ყოვლისმომცველ ღია პლატფორმას, რომელიც კონტექსტური სწავლების მეშვეობით აფასებს დიდი ენობრივი მოდელების (LLMs) მიერ გენერირებულ კონტენტში არსებულ „ჰალუცინაციებს“. ეს პროექტი, რომელზეც უკვე გამოქვეყნებულია სამეცნიერო ნაშრომი, მიზნად ისახავს ხელოვნური ინტელექტის სანდოობის გაუმჯობესებას. „ჰალუცინაციები“ იყოფა ფაქტობრივ (როცა მოდელი რეალურ ფაქტებს ეწინააღმდეგება) და ერთგულების (როცა კონტენტი არ ემთხვევა მომხმარებლის ინსტრუქციებს ან კონტექსტს) ტიპებად. ლიდერბორდი

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.