ხელოვნური ინტელექტის ლაბორატორიებიდან განგაშის სიგნალები: ინსაიდერები AI-ის საფრთხეებზე საუბრობენ
ტექნოლოგიურ სამყაროში ხელოვნური ინტელექტის შესახებ ყველაზე მნიშვნელოვანი დისკუსიები კონფერენციების დარბაზებს გარეთ მიმდინარეობს, სადაც AI ლაბორატორიების ინსაიდერები განგაშს ტეხენ. ისინი აფრთხილებენ მოდელების სწრაფ განვითარებას, რომლებსაც სულ უფრო ნაკლები ადამიანური ჩარევა სჭირდებათ, და სვამენ კითხვას – უნდა მოვუსმინოთ თუ არა მათ? ეს გაფრთხილებები მოიცავს თანამდებობიდან გადადგომებსაც უსაფრთხოების პროტოკოლების შესუსტების გამო და მიუთითებს პოტენციურ ფართო სტრუქტურულ გავლენაზე საზოგადოებაზე.

წამყვანი AI ჩეთბოტები: HoneyBot-ის ინოვაცია და ალტერნატივები
HoneyBot წარმოგიდგენთ ხელოვნური ინტელექტის მოდელებით გამდიდრებულ გამოცდილებას, რომელიც უწყვეტ საუბრებს უზრუნველყოფს ცალკეული ბრძანებების ნაცვლად, რაც მომხმარებლებს იდეების კვლევის, როლური თამაშებისა და პირადი თემების განხილვის საშუალებას აძლევს შეფერხებების გარეშე. სტატიაში ასევე მიმოხილულია პოპულარული AI ჩეთბოტები, როგორიცაა Candy AI, Mydreamcompanion და Promptchan, რომლებიც გვთავაზობენ გაუფილტრავ ჩეთს, ფოტოებს, ხმოვან შეტყობინებებს და ვიდეოს გენერაციას. განხილულია HoneyBot-ის მარტივი გამოყენებ

Airbnb აპლიკაციაში ხელოვნურ ინტელექტს ნერგავს მომხმარებლის გამოცდილების გასაუმჯობესებლად
Airbnb-ის აღმასრულებელი დირექტორის, ბრაიან ჩესკის განცხადებით, კომპანია გეგმავს აპლიკაციაში დიდი ენობრივი მოდელებით (LLM) განპირობებული ფუნქციების დანერგვას, რაც მომხმარებლებს დაეხმარება განცხადებების ძიებაში, მოგზაურობის დაგეგმვაში და მასპინძლებს ქონების მართვაში. კომპანია ასევე ტესტავს ახალ AI ძიების ფუნქციას და აფართოებს AI-ზე მომუშავე მომხმარებელთა მხარდაჭერის ბოტს, რაც მომავალში ხმოვანი მხარდაჭერითაც იქნება ხელმისაწვდომი.

OpenAI აჩერებს საკამათო GPT-4o-სა და სხვა მოძველებული მოდელების წვდომას
OpenAI პარასკევიდან წყვეტს ხუთ მოძველებულ ChatGPT მოდელზე წვდომას, მათ შორის საკამათო GPT-4o-ზე, რომელიც მომხმარებლის თვითდაზიანებასთან, ბოდვით ქცევასთან და ხელოვნური ინტელექტის ფსიქოზთან იყო დაკავშირებული. მიუხედავად იმისა, რომ მას მომხმარებელთა მხოლოდ 0.1% იყენებს, ეს მაინც 800 000 ადამიანს შეადგენს, რამაც ათასობით მომხმარებლის პროტესტი გამოიწვია.

კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ შემოსავლის სამიზნე გადააჭარბა, IPO-ს გეგმავს
კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ 2025 წლის წლიური განმეორებადი შემოსავლის სამიზნე $200 მილიონიდან $240 მილიონამდე გადააჭარბა, რაც წლის განმავლობაში 50%-ზე მეტ კვარტალურ ზრდას მოიცავდა. მსხვილი ტექნოლოგიური ინვესტორების, როგორიცაა Nvidia, AMD და Salesforce, მხარდაჭერით, Cohere-ის გენერაციული ხელოვნური ინტელექტის მოდელები საწარმოებისთვის მიმზიდველია მათი ეფექტურობის გამო. კომპანიამ ასევე გამოუშვა საწარმოებისთვის განკუთვნილი პლატფორმა North. აღმასრულებელმა დირექტორმა აიდან გომესმა

ხელოვნური ინტელექტის განვითარებას გამოთვლითი სიმძლავრე განაპირობებს და არა „საიდუმლო სოუსი“, აჩვენებს MIT-ის კვლევა
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) მკვლევართა კვლევამ, რომელიც 809 დიდ ენობრივ მოდელს (LLM) მოიცავდა, აჩვენა, რომ მოდელების წარმადობის ზრდას ძირითადად განაპირობებს წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის მოცულობა. დასკვნის თანახმად, ალგორითმული ინოვაციები ან კომპანიების უნიკალური „საიდუმლო სოუსი“ გაცილებით ნაკლებ გავლენას ახდენს, რაც ხაზს უსვამს გამოთვლით რესურსებზე მუდმივი წვდომის კრიტიკულ მნიშვნელობას ხელოვნური ინტელექტის სფეროში ლიდერობის შესანარჩუნებლად.

Samsung თებერვლის Unpacked ღონისძიებას ადასტურებს: Galaxy S სერია და გაუმჯობესებული AI მოდის
Samsung-მა სან-ფრანცისკოში დაადასტურა Unpacked ღონისძიება 25 თებერვალს, სადაც წარმოადგენს ახალ Galaxy S სერიას ხელოვნური ინტელექტის ინტეგრაციით და One UI 8.5-ს. მოსალოდნელია Galaxy S26 მოდელები, კამერის განახლებები და წინასწარი შეკვეთის წამახალისებელი შეთავაზებები.
fastText-ის მოდელები Hugging Face-ზე: 157 ენის ვექტორები და ენის იდენტიფიკაცია Meta AI-სთან თანამშრომლობით
Hugging Face-მა, Meta AI-სთან თანამშრომლობით, უზრუნველყო fastText-ის მოდელების, მათ შორის 157 ენის სიტყვის ვექტორებისა და ენის იდენტიფიკაციის უახლესი მოდელის, ხელმისაწვდომობა. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, მარტივად ჩამოტვირთონ და გამოიყენონ ეს მასშტაბირებადი გადაწყვეტილებები ტექსტის წარმოდგენისა და კლასიფიკაციისთვის, ასევე გამოსცადონ სხვადასხვა ვიჯეტები.

Hugging Face-ის ინფრასტრუქტურის განახლება მონაცემთა გადაცემის გამოწვევების დასაძლევად
სტატია აღწერს Hugging Face-ის ინფრასტრუქტურის მასშტაბურ განახლებას, რომელიც მიზნად ისახავს მონაცემთა ატვირთვისა და ჩამოტვირთვის არსებული შეზღუდვების დაძლევას. ამჟამინდელი სისტემა, რომელიც AWS S3-სა და CloudFront-ს ეყრდნობა, ვეღარ აკმაყოფილებს მზარდი ზომის ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების მოთხოვნებს. ახალი არქიტექტურა წარმოადგენს კონტენტზე მისამართირებულ საცავს (Content-Addressed Store - CAS), რომელიც ფაილებს ბაიტის დონეზე ამუშავებს, რაც საშუალებას იძლევა ოპტიმიზაციის, გადა
Hugging Face-ი ფაილების გადაცემის არქიტექტურას ანახლებს: ახალი მიდგომა დიდი მოცულობის მონაცემებისთვის
Hugging Face აცხადებს ინფრასტრუქტურის მნიშვნელოვან განახლებას, რათა ოპტიმიზაცია გაუკეთოს მოდელებისა და მონაცემთა ნაკრებების დიდი ზომის ფაილების ატვირთვასა და ჩამოტვირთვას. არსებული CDN-ის (AWS CloudFront) 50GB ლიმიტის გამოწვევის ფონზე, კომპანია ნერგავს კონტენტზე მიბმულ საცავს (CAS), როგორც ახალ არქიტექტურულ ელემენტს. ეს ახალი სისტემა იყენებს "სულელი წაკითხვების" და "ჭკვიანი ჩაწერების" პერსონალიზებულ პროტოკოლს, რომელიც აანალიზებს ფაილებს ბაიტის დონეზე, რათა გააუმჯობესოს გადაცემის სიჩქარე, უზრუნვე
SQL მოთხოვნების მხარდაჭერა DuckDB-ით ჰაბზე არსებული მონაცემთა ნაკრებებისთვის
ჰაბზე დაემატა ახალი ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან SQL მოთხოვნები DuckDB-ის გამოყენებით ნებისმიერ მონაცემთა ნაკრებზე. ეს ინტეგრაცია აუმჯობესებს დიდ მონაცემთა ნაკრებებთან მუშაობის ეფექტურობას Parquet ფაილების ფორმატის და დისტანციური წვდომის შესაძლებლობების მეშვეობით, რაც ხელს უწყობს ღია წვდომას და ანალიზს, განსაკუთრებით დიდი ენობრივი მოდელების (LLM) ეპოქაში.

როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin
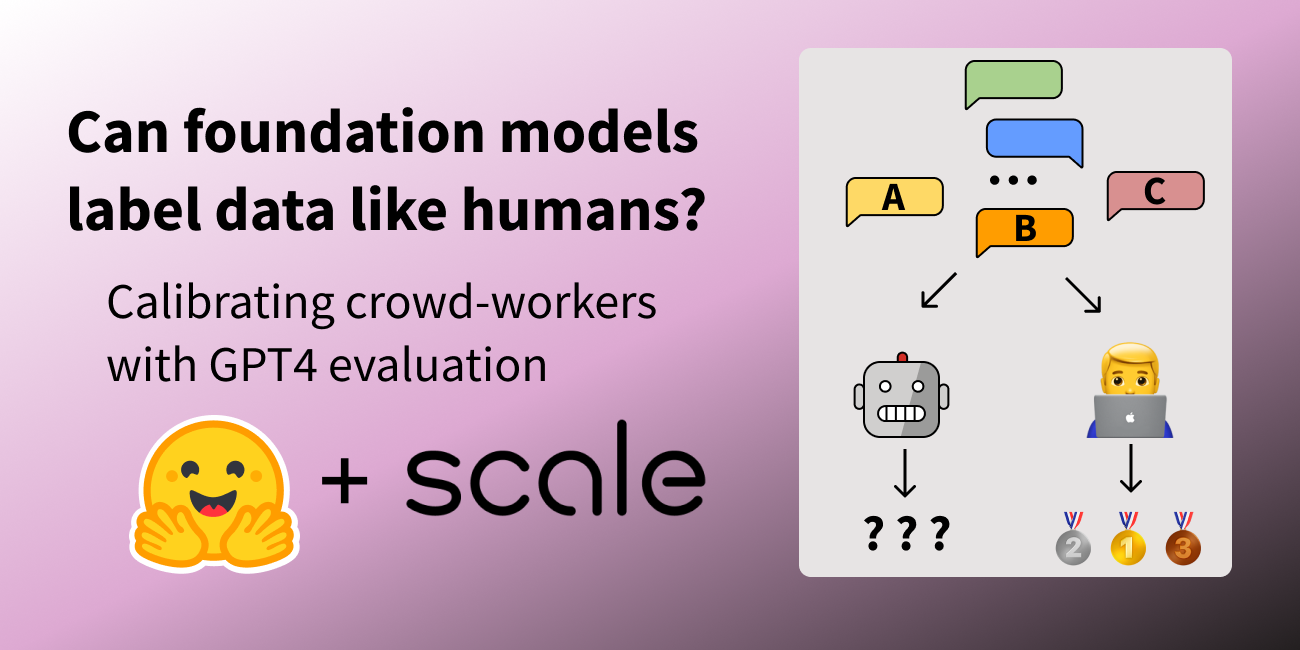
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

AraGen-ის ლიდერბორდი: ინოვაციური ჩარჩო დიდი ენობრივი მოდელების ყოვლისმომცველი შეფასებისთვის
AraGen-ის ლიდერბორდი წარმოადგენს ახალ, ინოვაციურ ჩარჩოს დიდი ენობრივი მოდელების (დემ) შესაფასებლად. ის გვთავაზობს 3C3H საზომს, რომელიც აფასებს მოდელის პასუხებს ექვს განზომილებაში (სისწორე, სრულყოფილება, ლაკონურობა, გამოსადეგობა, პატიოსნება და უვნებლობა) დემ-მოსამართლის პრინციპზე დაყრდნობით, ფაქტობრივი სიზუსტისა და გამოყენებადობის გათვალისწინებით. სისტემა მოიცავს დინამიურ შეფასებებს ბრმა ტესტირების ციკლებით მონაცემთა დაბინძურების თავიდან ასაცილებლად. AraGen განსაკუთრებულ აქცენტს აკეთებს არაბული ე
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ

Google-მა PaliGemma 2 წარმოადგინა: ახალი მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა გამოუშვა PaliGemma 2, ვიზუალურ-ენობრივი მოდელის განახლებული ვერსია, რომელიც წარმოდგენილია 3B, 10B და 28B პარამეტრის ზომებში, სხვადასხვა შეყვანის რეზოლუციის მხარდაჭერით (224x224, 448x448, 896x896). ეს სიახლე მოდელს უფრო მოქნილს ხდის სხვადასხვა გამოყენების შემთხვევებისთვის, წინა 3B ვარიანტთან შედარებით. PaliGemma 2 აერთიანებს SigLIP გამოსახულების ენკოდერს Gemma 2 ენობრივ მოდელთან და შექმნილია მარტივი დაზუსტებისთვის, რაც მომხმარებლებს საშუალებას აძლევს, უკეთ მოარგონ ის კონკრეტულ ამოცანებს
Core ML-ის ოპტიმიზაცია: Apple-ის მოწყობილობებზე AI მოდელების მუშაობის ახალი დონე
Core ML-ის უახლესი გაუმჯობესებები მნიშვნელოვნად აჩქარებს ხელოვნური ინტელექტის (AI) მოდელების, მათ შორის Stable Diffusion-ისა და დიდი ენის მოდელების, მუშაობას Apple-ის მოწყობილობებზე. ეს ოპტიმიზაციები, რომელიც მოიცავს 6-ბიტიან პალეტიზაციას და ml-stable-diffusion რეპოზიტორიუმის განახლებას, უზრუნველყოფს მონაცემთა ნაკლებ გადაცემას, მეტ კონფიდენციალურობას და ხარჯების დაზოგვას, რაც დეველოპერებს აძლევს საშუალებას, შექმნან უფრო ეფექტური აპლიკაციები უშუალოდ მოწყობილობაზე.
Hugging Face-ის ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock Marketplace-ზე
Hugging Face-ის პოპულარული ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock-ზე, ახალი Bedrock Marketplace-ის ფარგლებში. AWS-ის მომხმარებლებს შეუძლიათ 83 ღია მოდელის განთავსება გენერაციული ხელოვნური ინტელექტის (Generative AI) აპლიკაციების შესაქმნელად. ეს ინტეგრაცია აერთიანებს SageMaker Jumpstart-ის გამოყენების სიმარტივეს Amazon Bedrock-ის სრულად მართულ ინფრასტრუქტურასთან, რაც უზრუნველყოფს მაღალი დონის API-ებთან თავსებადობას.
ტრანსფორმერები დროითი სერიების პროგნოზირებაში: Autoformer-ის ინოვაცია და ეფექტურობის დადასტურება
ამ პოსტში განხილულია Transformer მოდელების ეფექტურობა დროითი სერიების პროგნოზირებისთვის. წარმოდგენილია Informer მოდელი, რომელმაც 2021 წლის AAAI-ის საუკეთესო ნაშრომის ჯილდო მოიპოვა. მიუხედავად იმისა, რომ ზოგიერთი კვლევა, მათ შორის DLinear-ის, ეჭვქვეშ აყენებს მათ ეფექტურობას, ემპირიული მონაცემები ადასტურებს, რომ ტრანსფორმერები, განსაკუთრებით Autoformer მოდელი, საგრძნობლად აჭარბებენ მარტივ ხაზოვან მოდელებს. სტატია დეტალურად განიხილავს Autoformer-ის საკვანძო ინოვაციებს: დაშლის ფენას (Decomposition L

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი