
ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ
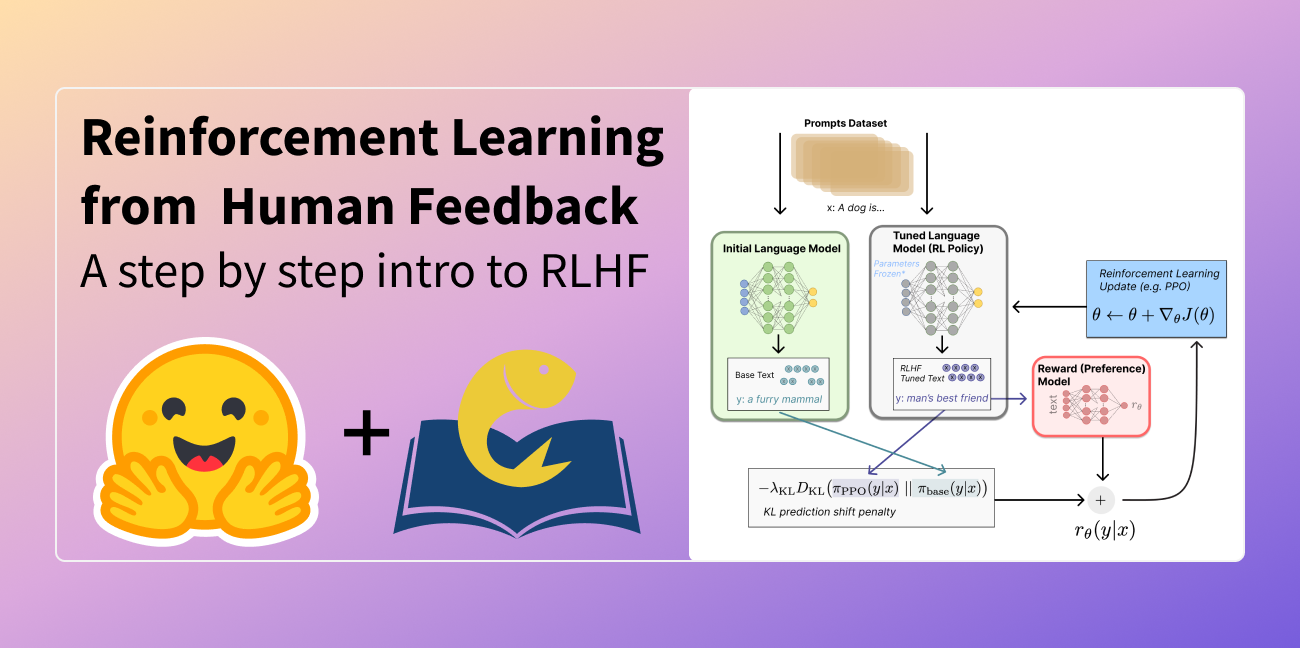
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები

BigCodeArena: კოდის გენერაციის ხელოვნური ინტელექტის მოდელების შეფასების ახალი სტანდარტი რეალური გაშვებით
BigCodeArena არის ინოვაციური პლატფორმა, რომელიც საშუალებას აძლევს მომხმარებლებს, შეადარონ ხელოვნური ინტელექტის კოდის გენერაციის მოდელები არა მხოლოდ კოდის წაკითხვით, არამედ მისი რეალური გაშვებით და შედეგების დანახვით. ის აგვარებს ტრადიციული შეფასების მეთოდების პრობლემებს, გვთავაზობს სანდბოქს გარემოებს კოდის ავტომატური გაშვებისთვის, მრავალსვლიან ინტერაქციებს და მომხმარებლის შეფასებებზე დაფუძნებულ ლიდერბორდს. პლატფორმა უკვე ლიდერბორდში აერთიანებს მოწინავე LLM-ების რეიტინგებს, აჩვენებს რა გამოკვეთილ
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ

Google-ის Gemma 2: ღია LLM-ების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
Google-მა წარმოადგინა Gemma 2, მისი ღია დიდი ენობრივი მოდელების (LLM) უახლესი ვერსია, ხელმისაწვდომი 9 და 27 მილიარდი პარამეტრის ზომებში. Gemma DeepMind Gemini-ზეა დაფუძნებული და გამოირჩევა მნიშვნელოვანი გაუმჯობესებებით, მათ შორის გაორმაგებული საწვრთნელი მონაცემებით (13 ტრილიონი ტოკენი 27B ვერსიისთვის), ოპტიმიზებული დიალოგური აპლიკაციებისთვის და ახალი არქიტექტურული ინოვაციებით, როგორიცაა ჰიბრიდული მოძრავი ფანჯრის ყურადღება (sliding window attention) და რბილი ზღვრის დადგენა (soft capping). მოდელი

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული
Hugging Face-ი მანქანური სწავლების მოდელების დოკუმენტაციის გასაუმჯობესებლად ახალ ხელსაწყოებსა და სახელმძღვანელოს უშვებს
Hugging Face-ი აქვეყნებს მოდელის ბარათის შექმნის ხელსაწყოსა და სახელმძღვანელოს, რაც მიზნად ისახავს მანქანური სწავლების (ML) მოდელების დოკუმენტაციის გამარტივებას, სტანდარტიზაციასა და გაუმჯობესებას. ეს ინიციატივა ხელს შეუწყობს სხვადასხვა წარმომავლობისა და როლის მქონე მომხმარებლების ჩართულობას, მათ შორის დეველოპერების, სტუდენტების, პოლიტიკოსების, ეთიკოსების და მათ, ვისზეც ML მოდელები გავლენას ახდენენ. პროექტი მოიცავს პროგრამირების გარეშე ბარათების შექმნის საშუალებას, განახლებულ შაბლონს და დეტალურ ი
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
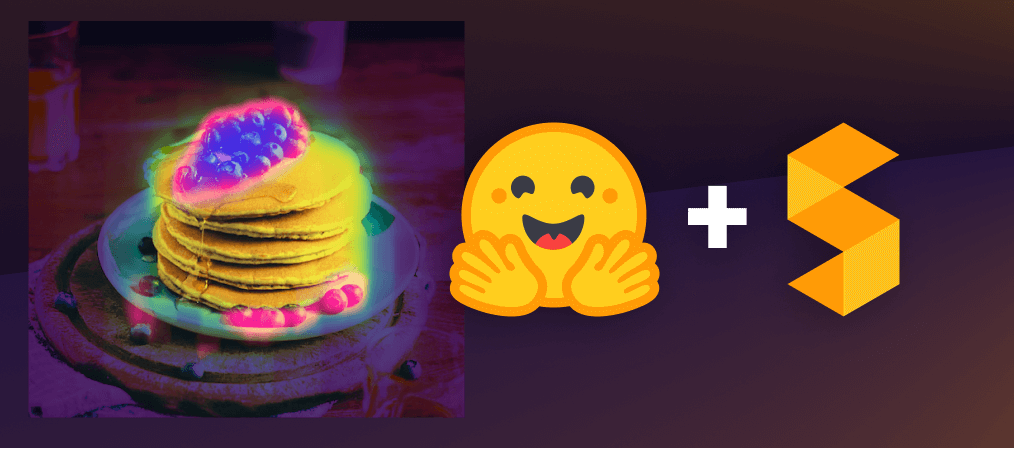
CLIPSeg: რევოლუციური „ნულოვანი კადრის“ სეგმენტაცია, რომელიც ცვლის კომპიუტერულ ხედვას
გამოსახულების სეგმენტაცია კომპიუტერული ხედვის მნიშვნელოვანი ამოცანაა, რომელიც ობიექტების კონტურების ამოცნობას უზრუნველყოფს. ტრადიციული მოდელების შეზღუდვა ისაა, რომ ისინი მხოლოდ ფიქსირებულ კატეგორიებთან მუშაობენ და ახალი ობიექტების დასამატებლად ხელახალ ვარჯიშს საჭიროებენ. CLIPSeg, „ნულოვანი კადრის“ სეგმენტაციის ინოვაციური მოდელი, ამ პრობლემას წყვეტს. ის CLIP-ის მძლავრი შესაძლებლობების გამოყენებით საშუალებას იძლევა თითქმის ნებისმიერი ობიექტის სეგმენტაცია მოხდეს დამატებითი ვარჯიშის გარეშე, რაც დროს
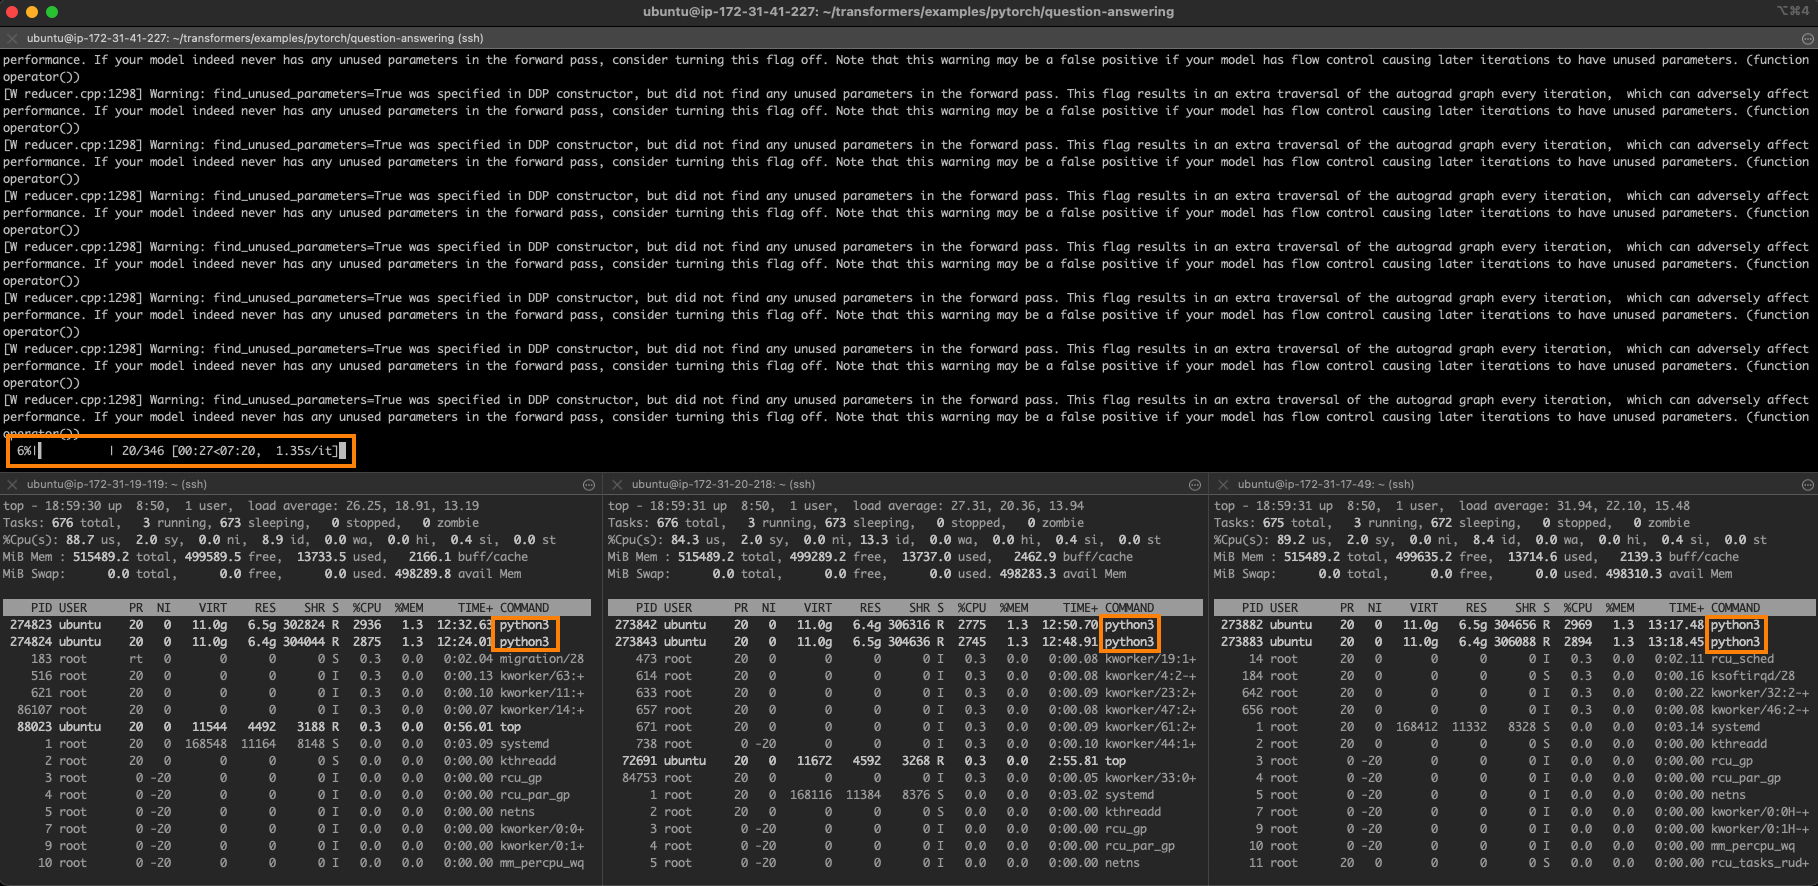
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ
სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ
TRL ბიბლიოთეკა DPO-ს მხარდაჭერას იწყებს ვიზუალური ენობრივი მოდელებისთვის (VLM-ები)
უპირატესობების ოპტიმიზაცია, რომელიც ფართოდ გამოიყენება ენობრივი მოდელების დასახვეწად, ახლა ვრცელდება ვიზუალურ ენობრივ მოდელებზე (VLM-ები) TRL ბიბლიოთეკის მეშვეობით. TRL-მა დაამატა პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მხარდაჭერა VLM-ებისთვის, რაც საშუალებას იძლევა მოდელების გაწვრთნას მომხმარებლის პრეფერენციების ამსახველი მონაცემებით. სტატია დეტალურად აღწერს VLM-ების DPO-ით გაწვრთნის პროცესს, მონაცემთა ნაკრების მომზადებიდან (მაგ., `openbmb/RLAIF-V-Dataset`) და მეხსიერების ოპტიმიზაციის ტექნიკე
როგორ ვავარჯიშოთ ვიზუალურ-ენობრივი მოდელები (VLMs) TRL-ისა და DPO-ს გამოყენებით
უპირატესობის ოპტიმიზაცია ფართოდ გამოიყენება ენობრივი მოდელების დაზუსტებისთვის, თუმცა მისი გამოყენება შესაძლებელია ვიზუალურ-ენობრივი მოდელებისთვისაც (VLM). TRL ბიბლიოთეკა ახლა უკვე პირდაპირი უპირატესობის ოპტიმიზაციას (DPO) უჭერს მხარს VLMs-ისთვის. ეს სტატია დაწვრილებით განგიმარტავთ VLMs-ის წვრთნის პროცესს TRL-ისა და DPO-ს გამოყენებით, მონაცემთა მომზადებიდან დაწყებული მეხსიერების ოპტიმიზაციის ტექნიკების ჩათვლით.
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა
Hugging Face-ი ხელოვნურ ინტელექტში პერსონალური მონაცემების დაცვას აძლიერებს: Presidio-ს ინტეგრაცია Dataset Hub-ში
Hugging Face-მა Dataset Hub-ზე ახალი ფუნქცია დანერგა, რომელიც Presidio-ს, ღია კოდის PII (პერსონალური საიდენტიფიკაციო ინფორმაციის) გამოვლენის ინსტრუმენტს იყენებს. ეს ფუნქცია მომხმარებლებს საშუალებას აძლევს, შეაფასონ PII-ის არსებობა მონაცემთა ნაკრებებში, რაც ეხმარება მათ მიიღონ ინფორმირებული გადაწყვეტილებები, თავიდან აიცილონ მიკერძოებული პროგნოზები და შექმნან უფრო ეთიკური ML მოდელები. ინიციატივა მიზნად ისახავს PII-ის გამოწვევების მოგვარებას მანქანურ სწავლებაში.

Hugging Face Hub-ი 2.2 მილიონ მოდელსა და მონაცემთა ნაკრებს VirusTotal-ის სკანერით დაიცავს
ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების უმსხვილესმა ღია პლატფორმამ, Hugging Face Hub-მა, დაიწყო 2.2 მილიონზე მეტი საჯარო რეპოზიტორიის უწყვეტი სკანირება VirusTotal-ის მეშვეობით. ეს ნაბიჯი მიზნად ისახავს AI მოდელებში არსებული ფარული რისკების, როგორიცაა მავნე ბინარული ფაილები და დამოკიდებულებები, გამოვლენასა და პრევენციას, რითაც უზრუნველყოფილია მომხმარებლებისთვის უსაფრთხო გარემო. ინტეგრაცია დამატებით დაცვასა და ხილვადობას უზრუნველყოფს მსოფლიოს ერთ-ერთი უმსხვილესი მავნე პროგრამების ს

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal

Raspberry Pi-მ AI HAT+ 2 გამოუშვა: თქვენი Pi 5 გენერაციულ AI მანქანად იქცევა
Raspberry Pi Foundation-მა წარმოადგინა AI HAT+ 2, 130 დოლარიანი აქსესუარი, რომელიც Raspberry Pi 5-ს ლოკალური გენერაციული ხელოვნური ინტელექტის პლატფორმად აქცევს. ეს არის მნიშვნელოვანი განახლება, რომელიც საშუალებას გაძლევთ გაუშვათ ჩატბოტები, სურათების გენერაცია და ხმოვანი ასისტენტები ინტერნეტის გარეშე, მხედველობაზე დაფუძნებული და გენერაციული AI მოდელების მხარდაჭერით.

ახალი კვლევა AI-ს მტკიცებებს ძირს უთხრის: მოდელები საავტორო უფლებებით დაცულ კონტენტს ინახავენ და იმეორებენ
სტენფორდისა და იელის უნივერსიტეტების ახალმა კვლევამ აჩვენა, რომ წამყვანი AI კომპანიების ენობრივი მოდელები, როგორიცაა OpenAI, Anthropic და Google, საავტორო უფლებებით დაცული სავარჯიშო მონაცემების ასლებს ინახავენ და არა მხოლოდ „შაბლონებს სწავლობენ“. ეს აღმოჩენა ფუნდამენტურად ეჭვქვეშ აყენებს კომპანიების იურიდიულ არგუმენტებს „კეთილსინდისიერი გამოყენების“ (fair use) შესახებ, ვინაიდან მოდელებს მარტივი მოთხოვნებით შეუძლიათ ცნობილი ნაწარმოებებიდან ათასობით სიტყვის სიტყვასიტყვით რეპროდუცირება.

Nvidia-ს ბრალი ედება ხელოვნური ინტელექტის მოდელების გასაწვრთნელად პირატული წიგნების გამოყენებაში
განახლებული სარჩელის მიხედვით, Nvidia-ს ბრალი ედება მილიონობით პირატული წიგნის შეგნებულად გამოყენებაში თავისი ხელოვნური ინტელექტის მოდელების გასაწვრთნელად, მას შემდეგ, რაც კომპანია დაუკავშირდა საკამათო „ჩრდილოვან ბიბლიოთეკას“ Anna’s Archive. ავტორები საავტორო უფლებების დარღვევისთვის კომპენსაციას ითხოვენ. ეს ფაქტი კითხვებს აჩენს ტექნოლოგიური კომპანიების ეთიკისა და მონაცემების მიმართ სასოწარკვეთილების შესახებ, მიუხედავად იმისა, რომ მათ გაფრთხილება ჰქონდათ მიღებული შინაარსის უკანონობის შესახებ.