ჰომომორფული დაშიფვრა მოქმედებაში: სენტიმენტების ანალიზი დაშიფრულ მონაცემებზე Concrete-ML-ით
ახალი ტექნოლოგიური მიღწევა მონაცემთა კონფიდენციალურობის სფეროში: სტატია იკვლევს ჰომომორფულ დაშიფრვას (FHE), რომელიც იძლევა დაშიფრულ მონაცემებზე გამოთვლების საშუალებას მათი გაშიფვრის გარეშე. Concrete-ML ბიბლიოთეკის დახმარებით, მონაცემთა მეცნიერებს შეუძლიათ შექმნან მანქანური სწავლების მოდელები FHE გარემოში კრიპტოგრაფიის ცოდნის გარეშე. გთავაზობთ პრაქტიკულ სახელმძღვანელოს დაშიფრულ მონაცემებზე სენტიმენტების ანალიზის მოდელის შესაქმნელად, დემო ვერსიით Hugging Face Spaces-ზე.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
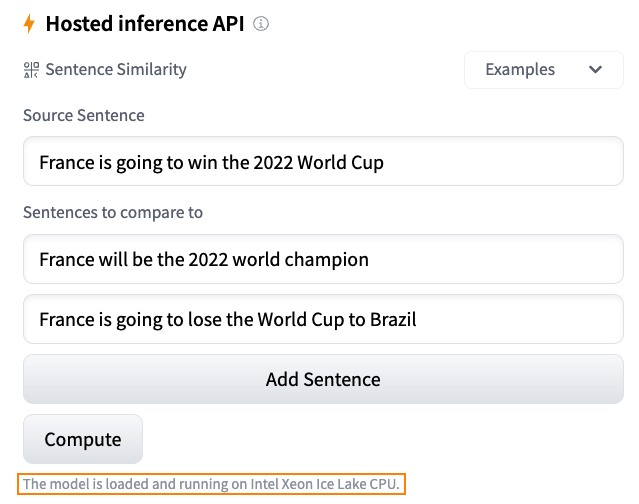
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
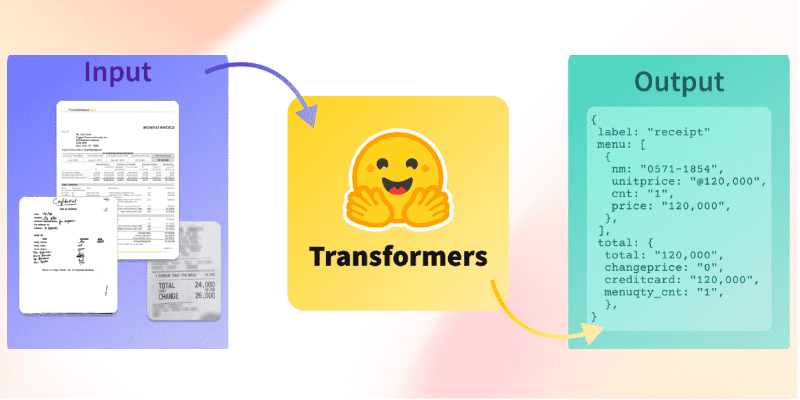
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.

SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.
გეპატიჟებით Stable Diffusion-ის შემქმნელებთან და ხელოვნური ინტელექტის მკვლევრებთან შეხვედრაზე!
ამ გამოშვებასთან ერთად, 30 ნოემბერს ვმართავთ ცოცხალ საზოგადოებრივ ღონისძიებას, რომელზეც გეპატიჟებით! პროგრამა მოიცავს საინტერესო მოხსენებებს Stable Diffusion-ის შემქმნელებისგან, Stability AI-ისა და Meta-ს მკვლევრებისგან, ასევე სხვა ექსპერტებისგან! რეგისტრაციისთვის, გთხოვთ, შეავსოთ ეს ფორმა. სპიკერებისა და მოხსენებების შესახებ დამატებითი დეტალები მოცემულია ქვემოთ. მოხსენებები ფოკუსირებული იქნება დიფუზიური მოდელების მაღალი დონის პრეზენტაციაზე და იმ ინსტრუმენტებზე, რომელთა გამოყენებაც შეგვიძლია მათ
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.

ციფრული ინტერაქციის მომავალი: GUI ავტომატიზაცია ხედვა-ენის მოდელებით
ეს ბლოგ-პოსტი წარმოგიდგენთ მრავალფაზიან სტრატეგიას ხედვა-ენის მოდელების გასაწვრთნელად, რათა მიღწეულ იქნას გრაფიკული ინტერფეისის (GUI) ავტომატიზაცია. განხილულია, თუ როგორ შეიძლება მოდელების ტრანსფორმაცია, საწყისი დამიწების შესაძლებლობების გარეშე, აგენტურ კოდერებად, რომლებსაც შეუძლიათ ინტერფეისების გაგება და მათთან ურთიერთობა. ხაზგასმულია მონაცემთა დამუშავებიდან მოდელის ტრენინგამდე მიმავალი ყოვლისმომცველი პროცესი. მიდგომა ეფუძნება SmolVLM2-2.2B-Instruct მოდელს და მოიცავს მონაცემთა გაერთიანების პაი

swift-transformers 1.0: ლოკალური ხელოვნური ინტელექტის ახალი ერა Apple Silicon-ზე
`swift-transformers` ბიბლიოთეკამ გამოუშვა ვერსია 1.0, რაც მის სტაბილურობასა და Apple Silicon პლატფორმებზე, iPhone-ების ჩათვლით, ლოკალური მანქანური სწავლების მოდელების უწყვეტი ინფერენციის მხარდაჭერის მზადყოფნას ადასტურებს. განახლება მიზნად ისახავს საზოგადოებისთვის მაქსიმალური სარგებლის მოტანას, მომავალი განვითარების საფუძვლების ჩაყრას და განსაკუთრებულ ყურადღებას უთმობს MLX-სა და აგენტურ გამოყენების შემთხვევებს.
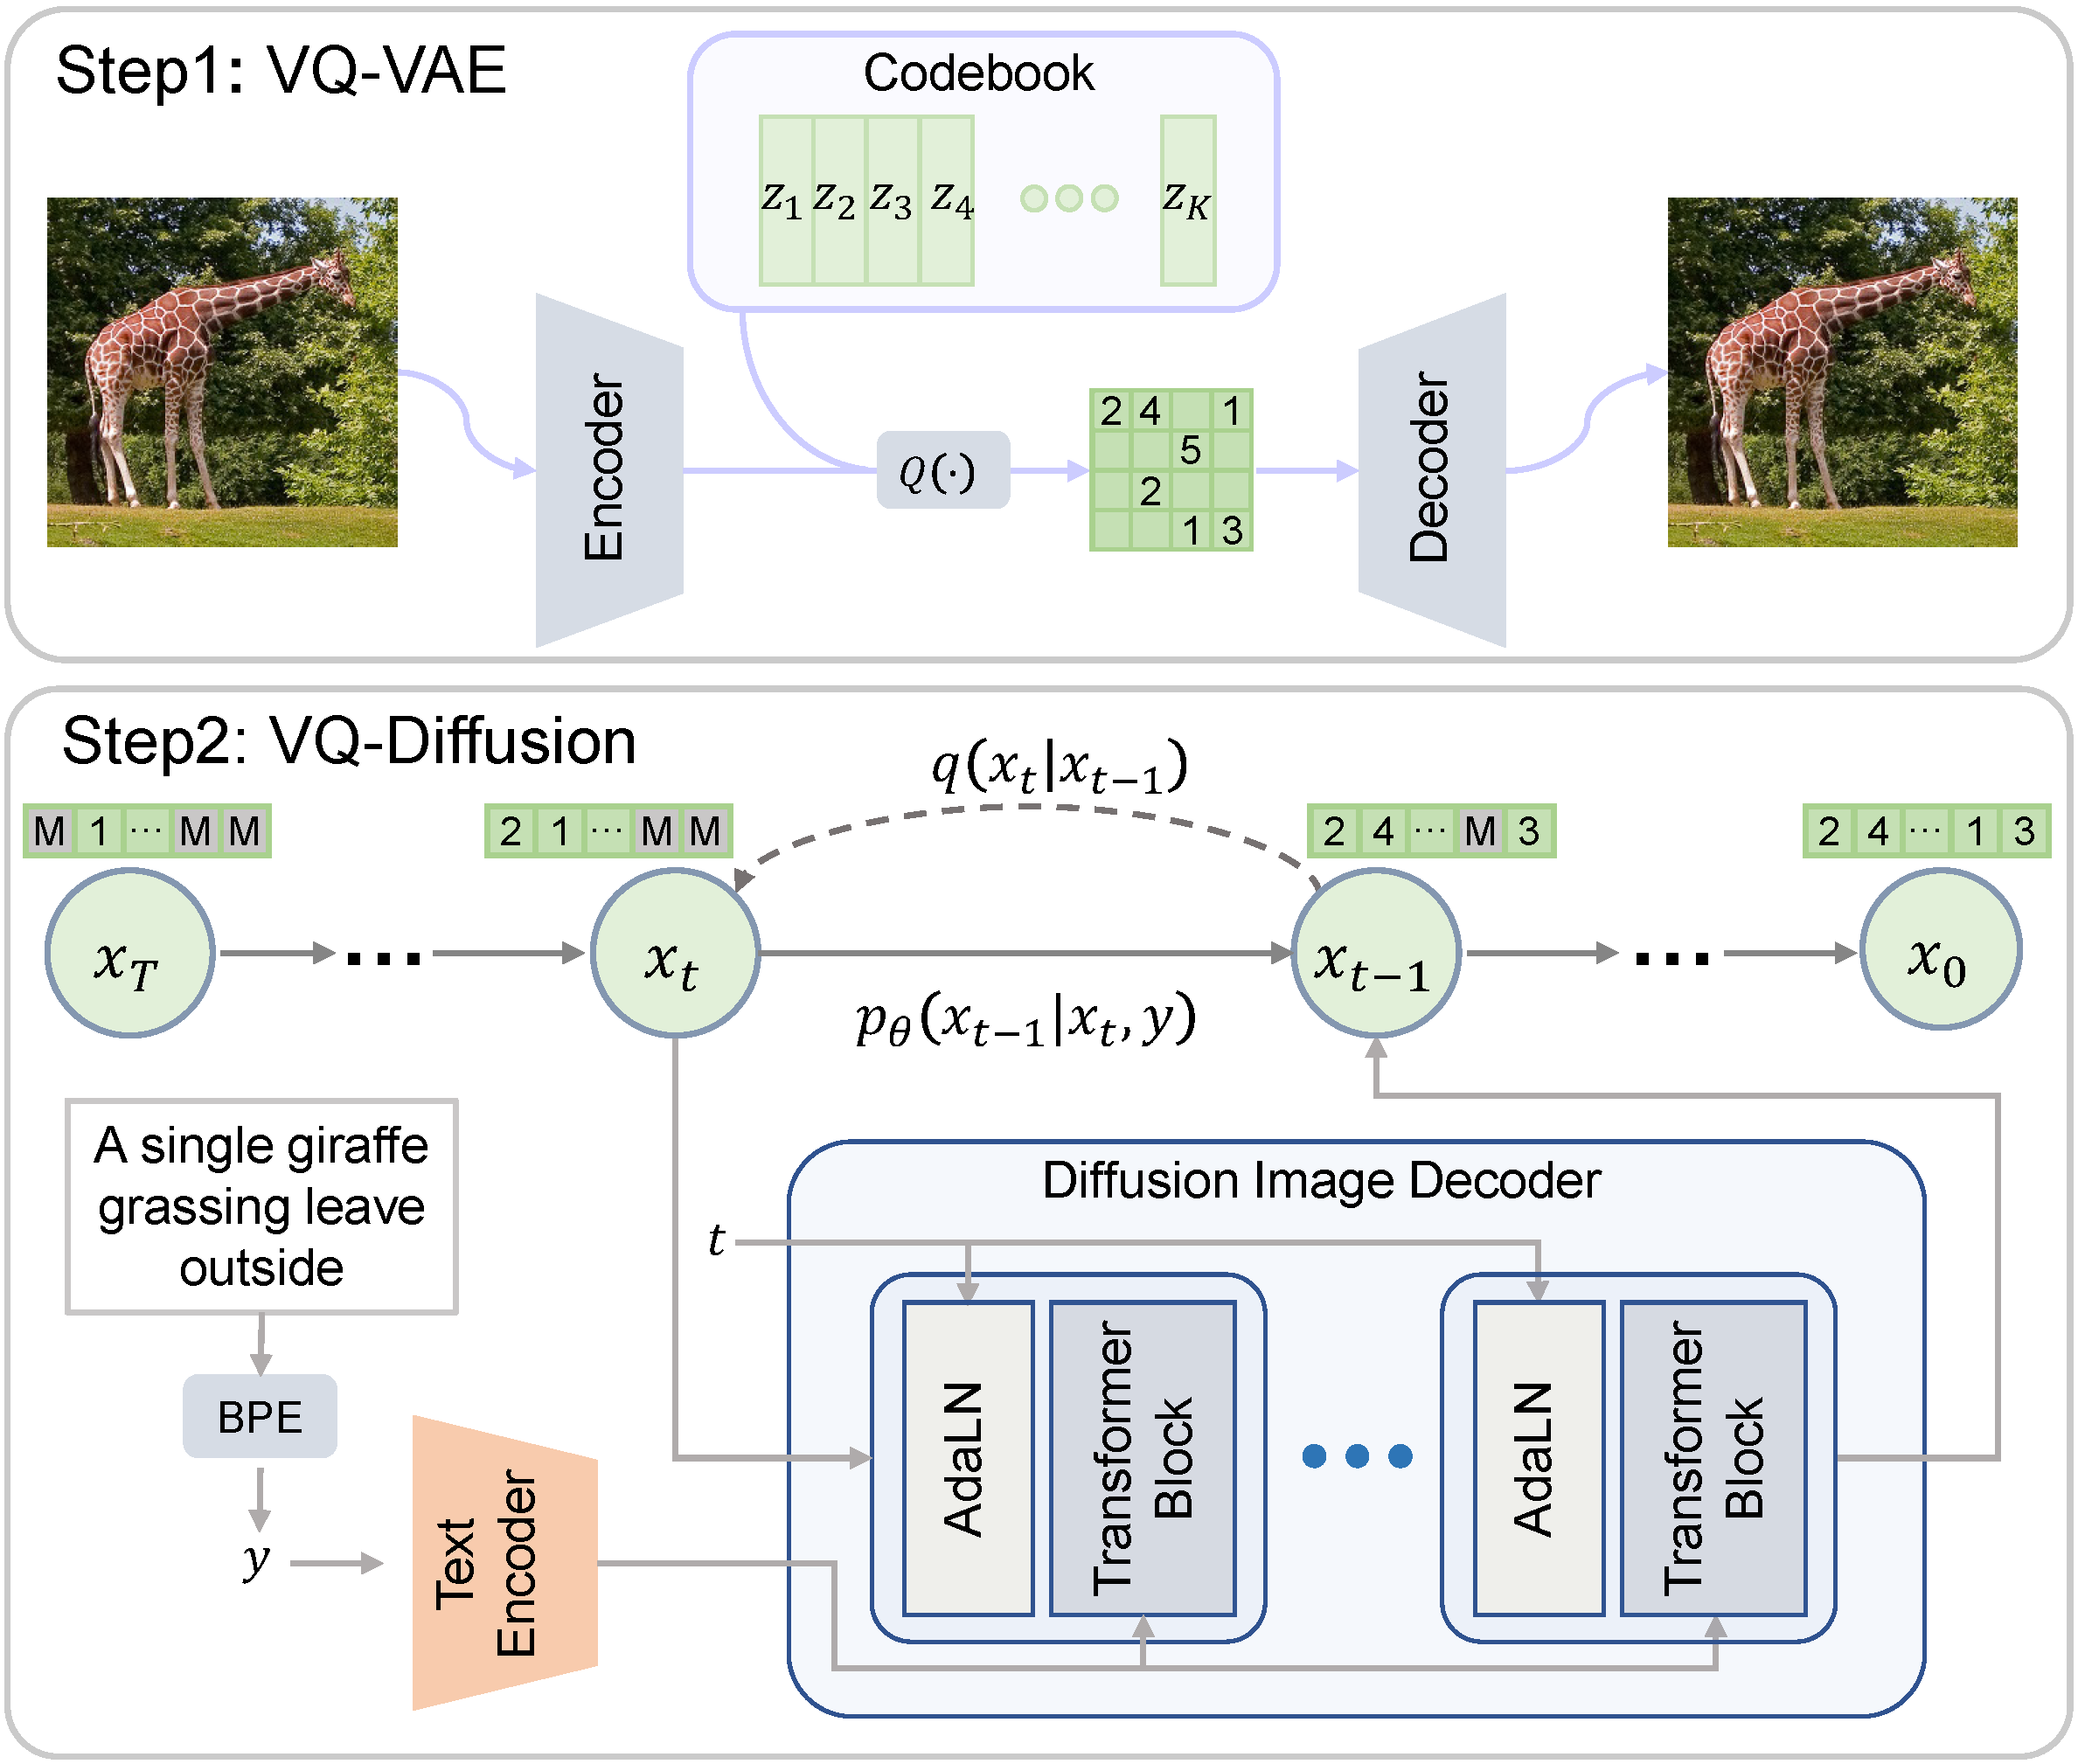
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
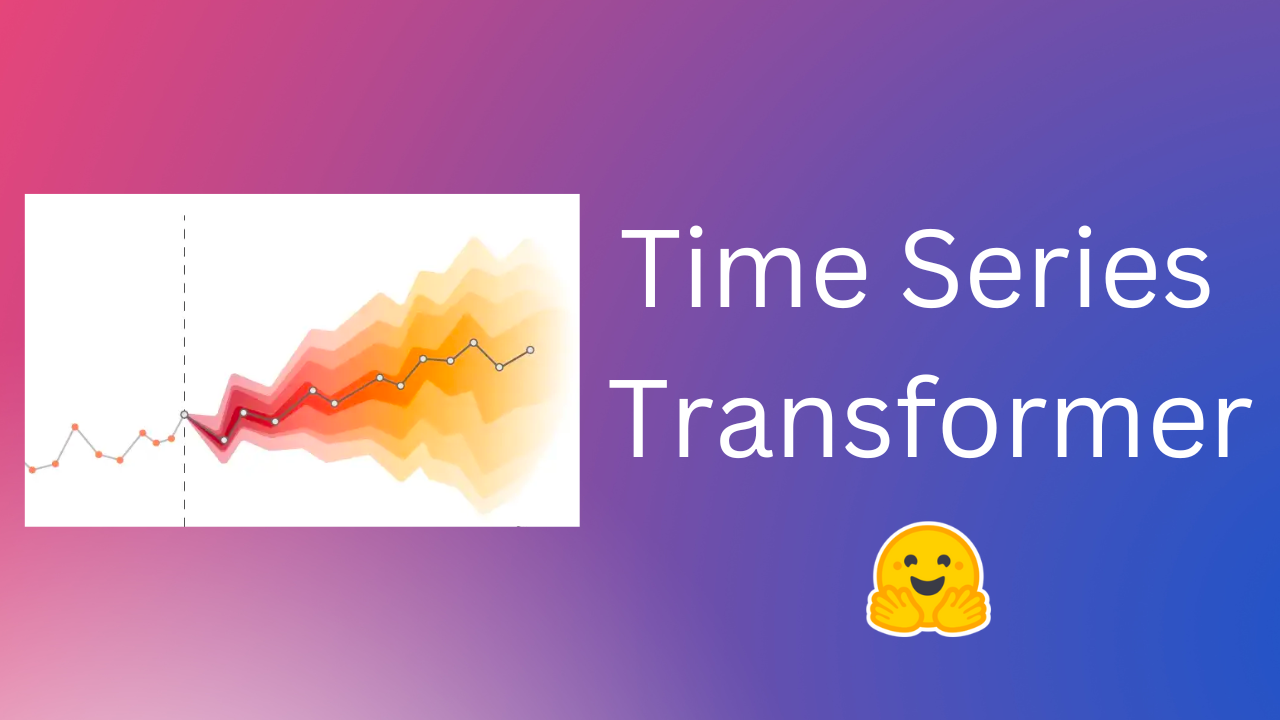
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი
BigCodeBench: ახალი ეტალონი LLM-ების პროგრამირების შეფასებისთვის
კვლევითი გუნდი წარმოგიდგენთ BigCodeBench-ს, ახალ, ყოვლისმომცველ ეტალონს, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების შეფასებას. ეს ინსტრუმენტი, არსებული ალტერნატივების შეზღუდვების საპასუხოდ შეიქმნა და მოიცავს 1,140 ფუნქციურ დავალებას, რომლებიც მოითხოვს პრაქტიკული და რთული პროგრამირების ამოცანების გადაჭრას მკაცრი ტესტირების პირობებში, დაბინძურების გარეშე. BigCodeBench-ი ეხმარება დეველოპერებს, უკეთ შეაფასონ LLM-ების უნარი, მიჰყვნენ ინსტრუქციებს და მოახდინონ ფ
BigCodeBench: ახალი ბენჩმარკი ხელოვნური ინტელექტის პროგრამირების შესაძლებლობების შესაფასებლად
საზოგადოებას კვლავ აკლია მარტივი გამოსაყენებელი ბენჩმარკი, რომელსაც შეუძლია დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების ფართოდ შეფასება. ამ გამოწვევის საპასუხოდ, წარდგენილია BigCodeBench – ახალი, ყოვლისმომცველი შეფასების პლატფორმა, რომელიც 1,140 ფუნქციის დონის ამოცანის საშუალებით ამოწმებს LLM-ებს პრაქტიკული და რთული პროგრამირების ამოცანების გადაწყვეტაში, მათ შორის ინსტრუქციების შესრულებასა და მრავალი ფუნქციის გამოძახებაში 139 ბიბლიოთეკიდან. BigCodeBench მკაცრად აფასებს მოდელებს მ

Vibe Coding თამაშების შექმნა: პრობლემები და ავტორის ინოვაციური გადაწყვეტა
სტატია იკვლევს „vibe coding“-ის კონცეფციას თამაშების შექმნისას, სადაც ხელოვნური ინტელექტი გამოიყენება მაღალი დონის პროგრამირების ენად. განხილულია პროექტების ზრდასთან დაკავშირებული გამოწვევები, განსაკუთრებით ხელოვნური ინტელექტის მოდელების კონტექსტური ფანჯრის შეზღუდვების გამო. წარმოდგენილია „Shallot“ – კონტექსტის მართვის სისტემა და „VibeGame“ – ახალი, მაღალი დონის დეკლარაციული სათამაშო ძრავი, რომელიც სპეციალურად ხელოვნური ინტელექტის დახმარებით თამაშების შესაქმნელად შეიქმნა ამ პრობლემების დასაძლევა
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ
Prezi Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას უერთდება: ML პოტენციალის სრული გამოყენება
პრეზენტაციების ონლაინ ხელსაწყო Prezi, Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას შეუერთდა, რათა მაქსიმალურად აითვისოს თანამედროვე მანქანური სწავლების (ML) შესაძლებლობები. ამ თანამშრომლობის ფარგლებში, Hugging Face ეხმარება Prezi-ს უფრო მცირე და ეფექტური ღია კოდის მოდელების ინტეგრირებაში, რაც განსაკუთრებით მნიშვნელოვანია მულტიმოდალური მოდელების მზარდი შესაძლებლობების ფონზე. Prezi-ის ბექენდ ინჟინერი, მატე ბორჩოკი, იზიარებს თავის გამოცდილებას პროგრამაში მონაწილეობის შესახებ, ხაზს უსვამს ექსპერტ
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა

RTEB: ახალი ბენჩმარკი ხელოვნური ინტელექტის მოდელების მოძიების ხარისხის საიმედო შეფასებისთვის
ხელოვნური ინტელექტის აპლიკაციების მუშაობა, როგორიცაა RAG და რეკომენდაციის სისტემები, მნიშვნელოვნად შეზღუდულია ძიებისა და მოძიების ხარისხით. დეველოპერებისთვის პრობლემას წარმოადგენს ემბედინგის მოდელების მოძიების ხარისხის ზუსტი გაზომვა, რადგან არსებული ბენჩმარკები ხშირად აჩვენებენ „განზოგადების ხარვეზს“ და არ შეესაბამებიან რეალურ საწარმოო გამოყენების შემთხვევებს. ამ გამოწვევების გადასაჭრელად შეიქმნა RTEB – ახალი, საიმედო ბენჩმარკი, რომელიც ზომავს მოძიების სიზუსტეს. ის იყენებს ჰიბრიდულ სტრატეგიას (ღ

მანქანური სწავლება Elixir-ში: ახალი შესაძლებლობები Bumblebee-სთან ერთად
Elixir-ის ეკოსისტემაში მანქანური სწავლების მხარდაჭერა მნიშვნელოვნად გაუმჯობესდა ისეთი პროექტების წყალობით, როგორებიცაა Nx, Axon, Explorer და, განსაკუთრებით, Bumblebee. Livebook პლატფორმაში ინტეგრირებული „Smart cells“-ის მეშვეობით, დეველოპერებს შეუძლიათ ნერვული ქსელების ამოცანების სწრაფად ინტეგრირება. Erlang ვირტუალური მანქანის კონკურენტულობისა და დისტრიბუციის წყალობით, ეს მოდელები ადვილად ინტეგრირდება არსებულ Elixir აპლიკაციებში, როგორიცაა Phoenix, Broadway და Nerves, და კომპილირდება როგორც CPU-

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად