
vLLM-ის ოპტიმიზაცია: პრეფილის სტრატეგიები და გრძელი მოთხოვნების მართვა
სტანდარტულად, vLLM-ში პრეფილის ფაზა თანმიმდევრულად ამუშავებს მოთხოვნებს, რაც პრობლემური ხდება გრძელი "პრომპტების" შემთხვევაში, რადგან მათ შეუძლიათ შეაფერხონ შემდგომი მოთხოვნები და გაზარდონ შეყოვნება. მიუხედავად იმისა, რომ პარალელური პრეფილის მცდელობები არსებობდა, ისინი რესურსების ოპტიმიზაციის პრობლემებს აწყდებოდნენ. vLLM-ის უახლესმა განახლებამ წარმოადგინა გაუმჯობესებული სტრატეგია, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას გრძელი მოთხოვნების შეფერხების გარეშე, რაც მნიშვნელოვ
vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
ღრმა გაძლიერებითი სწავლება: პოლიტიკაზე დაფუძნებული მეთოდები და Reinforce
სტატია მიმოიხილავს პოლიტიკაზე დაფუძნებულ მეთოდებს ღრმა გაძლიერებით სწავლებაში, უპირისპირებს რა მათ ღირებულებაზე დაფუძნებულ მიდგომებს. განმარტებულია, რომ პოლიტიკაზე დაფუძნებული მეთოდები უშუალოდ ოპტიმიზაციას უკეთებენ პოლიტიკას შუალედური ღირებულების ფუნქციის გარეშე, კონკრეტულად კი ალგორითმ Reinforce-ის მაგალითზე. ხაზგასმულია ძირითადი უპირატესობები, როგორიცაა ინტეგრაციის სიმარტივე, სტოქასტური პოლიტიკის სწავლის უნარი და ისეთი პრობლემების გადაჭრა, როგორიცაა აღქმითი ალიასინგი, ასევე უწყვეტი მოქმედებები

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ

როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti

AI-ის ეფექტურობის რევოლუცია: Hugging Face და AMD Llama 3.1-ს MI300X-ზე აუმჯობესებენ
ყოველდღიურად მილიარდობით AI მოთხოვნის დამუშავება, როგორიცაა ChatGPT-ის მიერ, მოდელის ოპტიმიზაციას გადამწყვეტ მნიშვნელობას ანიჭებს. განსაკუთრებით კრიტიკულია ბირთვის (kernel) დონის ოპტიმიზაცია, რაც ხშირად უგულებელყოფილია მრავალი მოწყობილობისთვის, განსაკუთრებით AMD GPU-ებისთვის. Hugging Face-მა AMD-სთან ითანამშრომლა, რათა შეემუშავებინა ღია წყაროს ოპტიმიზებული ბირთვები Llama 3.1 405B მოდელის მუშაობის გასაუმჯობესებლად FP8 ფორმატში, 8 MI300X GPU-ით აღჭურვილ კვანძზე, VLLM-ის გამოყენებით. ეს პარტნიორობა
Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
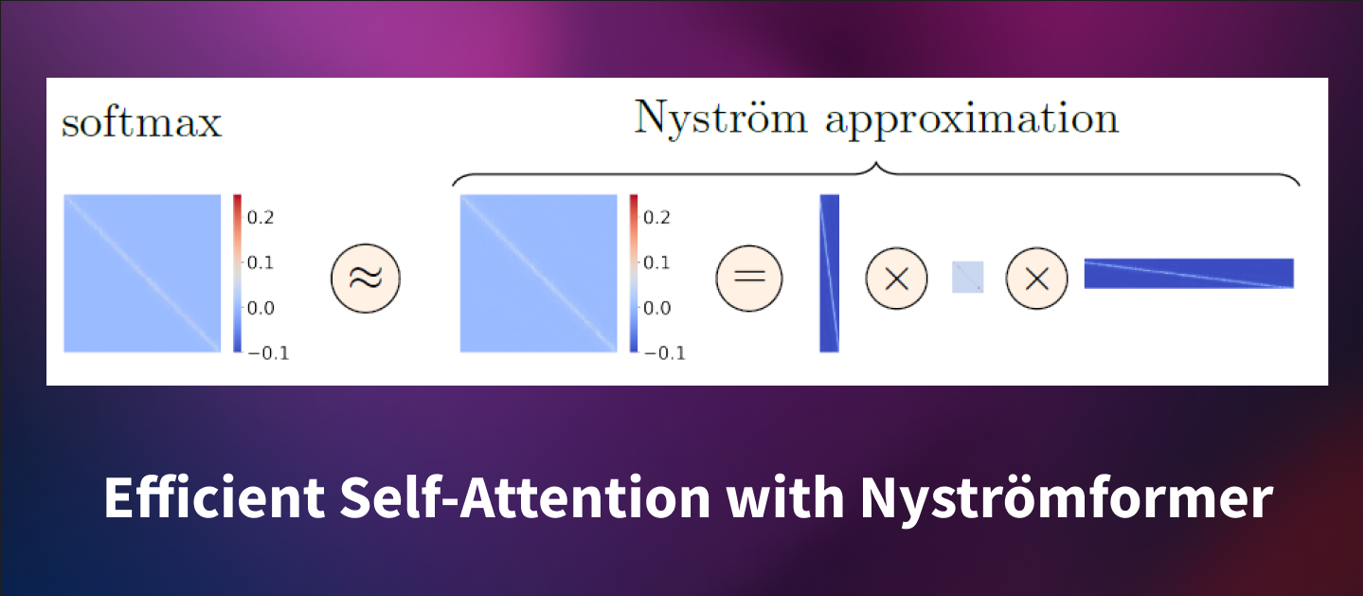
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu

NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.

ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.

TRL წარმოგიდგენთ ახალ ალგორითმებს Vision Language მოდელების გასაუმჯობესებლად: MPO, GRPO და GSPO
Vision Language მოდელების (VLM) მუშაობის გაუმჯობესებაზე ფოკუსირებით, TRL-მა წარმოადგინა ინოვაციური ალგორითმები - შერეული პრეფერენციის ოპტიმიზაცია (MPO), ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO) და ჯგუფური თანმიმდევრობის პოლიტიკის ოპტიმიზაცია (GSPO). ეს მეთოდები სცილდება ტრადიციული DPO-ს ფარგლებს, რაც უზრუნველყოფს უფრო მდიდარი სიგნალების ამოღებას მონაცემებიდან, სტაბილურ წვრთნას და მნიშვნელოვან გაუმჯობესებას მოდელების პასუხებში, განსაკუთრებით მულტიმოდალურ ამოცანებში. მათი ინტეგრაცია TRL-ის
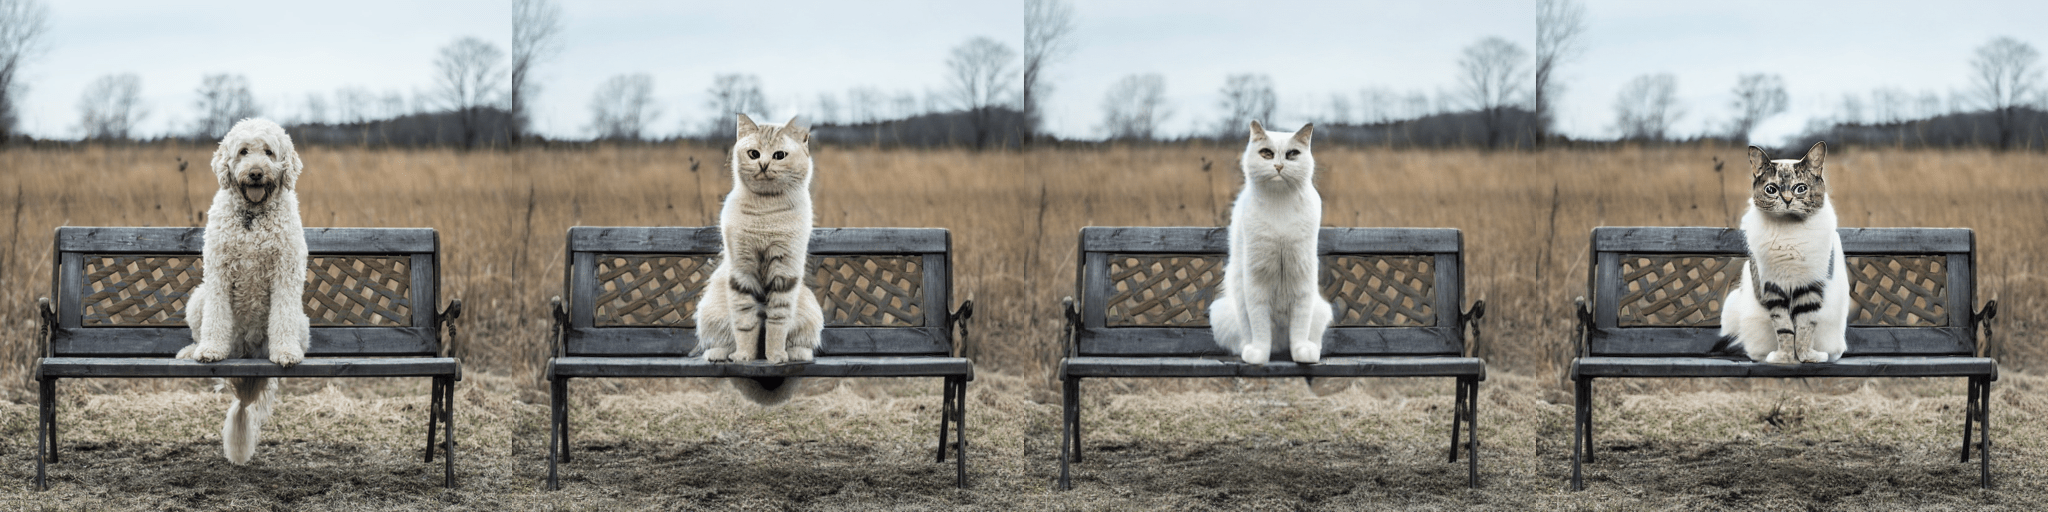
Stable Diffusion-ის რევოლუციური განახლებები: გამოსახულებიდან გამოსახულების გენერაცია, ოპტიმიზაცია და საზოგადოების წვლილი
Hugging Face-ის Stable Diffusion-ის უახლესი განახლებები მოიცავს დიდი ხნის ნანატრი ფუნქციებს, როგორიცაა გამოსახულებიდან გამოსახულების გენერაცია, ტექსტუალური ინვერსია და ინფეინთინგი. ასევე, წარმოდგენილია მნიშვნელოვანი ოპტიმიზაციები VRAM-ის გამოყენებისთვის, M1/M2 ჩიპების მხარდაჭერა და ONNX-თან თავსებადობა. გამოვიდა გაუმჯობესებული დოკუმენტაცია, ხოლო საზოგადოებამ შექმნა მრავალი ინოვაციური ინსტრუმენტი, როგორიცაა Stable Diffusion Videos და Waifu Diffusion.

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ