
Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.

PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტული მიგნებები და რჩევები Stable Diffusion-ისთვის
ამ პოსტში წარმოდგენილია Dreambooth-ის პარამეტრების ანალიზის შედეგები Stable Diffusion-ის დახვეწისას. მოცემულია რჩევები საუკეთესო შედეგების მისაღებად, მათ შორის სწავლის ტემპისა და სწავლის ნაბიჯების ოპტიმიზაცია, 'prior preservation' ტექნიკის გამოყენება, შესაბამისი განრიგის (scheduler) არჩევა (როგორიცაა DDIM) და ტექსტის ენკოდერის დახვეწის მნიშვნელობა, განსაკუთრებით სახეების დამუშავებისას. ხაზგასმულია მეთოდის ეთიკური გამოყენების აუცილებლობა.
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.

Sentence Transformers-ის ოპტიმიზაცია: ძირითადი კომპონენტები და ეფექტური მოდელების შექმნა
ამ სტატიაში განხილულია Sentence Transformers-ის მოდელების ოპტიმიზაციის პროცესი, რომელიც მოიცავს მონაცემთა ნაკრებებს, დანაკარგის ფუნქციებს, ვარჯიშის არგუმენტებს, შემფასებლებსა და ახალ ტრენერს. თითოეული კომპონენტი დეტალურადაა აღწერილი მაგალითებთან ერთად, რათა დაგეხმაროთ ეფექტური მოდელების შექმნაში კონკრეტული ამოცანებისთვის, სხვადასხვა მსგავსების კონცეფციის გათვალისწინებით.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt

SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ
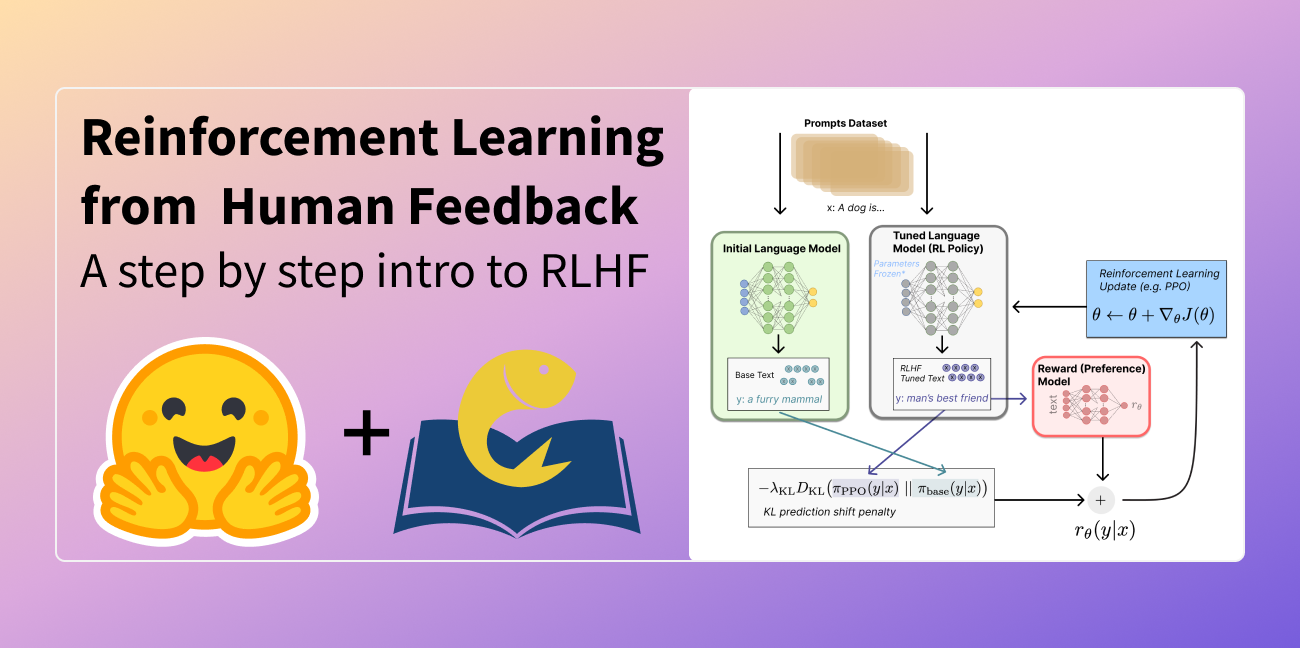
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
საფრანგეთი: ხელოვნური ინტელექტი სკოლების ეკოლოგიური განახლებისთვის მონაცემთა სუვერენიტეტის დაცვით
Banque des Territoires-ს, Polyconseil-სა და Hugging Face-ს შორის დაწყებული თანამშრომლობა გენერაციული ხელოვნური ინტელექტის პოტენციალს მონაცემთა სუვერენიტეტის მოთხოვნებთან აერთიანებს. პროექტის პირველი ფაზის დასრულების შემდეგ, შემუშავებული ინსტრუმენტი ოპტიმიზაციას უკეთებს Banque des Territoires-ის EduRénov პროგრამის მხარდაჭერის ჩარჩოს, რომელიც საფრანგეთში 10,000 საჯარო სკოლის დაწესებულების ეკოლოგიურ განახლებას ემსახურება. RAG სისტემაზე დაფუძნებული ეს გადაწყვეტა მონაცემთა უსაფრთხოებასა და სუვერენიტე
TRL ბიბლიოთეკა DPO-ს მხარდაჭერას იწყებს ვიზუალური ენობრივი მოდელებისთვის (VLM-ები)
უპირატესობების ოპტიმიზაცია, რომელიც ფართოდ გამოიყენება ენობრივი მოდელების დასახვეწად, ახლა ვრცელდება ვიზუალურ ენობრივ მოდელებზე (VLM-ები) TRL ბიბლიოთეკის მეშვეობით. TRL-მა დაამატა პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მხარდაჭერა VLM-ებისთვის, რაც საშუალებას იძლევა მოდელების გაწვრთნას მომხმარებლის პრეფერენციების ამსახველი მონაცემებით. სტატია დეტალურად აღწერს VLM-ების DPO-ით გაწვრთნის პროცესს, მონაცემთა ნაკრების მომზადებიდან (მაგ., `openbmb/RLAIF-V-Dataset`) და მეხსიერების ოპტიმიზაციის ტექნიკე
როგორ ვავარჯიშოთ ვიზუალურ-ენობრივი მოდელები (VLMs) TRL-ისა და DPO-ს გამოყენებით
უპირატესობის ოპტიმიზაცია ფართოდ გამოიყენება ენობრივი მოდელების დაზუსტებისთვის, თუმცა მისი გამოყენება შესაძლებელია ვიზუალურ-ენობრივი მოდელებისთვისაც (VLM). TRL ბიბლიოთეკა ახლა უკვე პირდაპირი უპირატესობის ოპტიმიზაციას (DPO) უჭერს მხარს VLMs-ისთვის. ეს სტატია დაწვრილებით განგიმარტავთ VLMs-ის წვრთნის პროცესს TRL-ისა და DPO-ს გამოყენებით, მონაცემთა მომზადებიდან დაწყებული მეხსიერების ოპტიმიზაციის ტექნიკების ჩათვლით.

ნულოვანი ტრიმესტრის აღზევება: როგორ ემზადებიან ქალები ორსულობისთვის მარათონის მსგავსად
ესთერ რორის სამწლიანი ინტენსიური მომზადება ორსულობისთვის ხაზს უსვამს მზარდ ტენდენციას, რომელსაც სოციოლოგმა მირანდა ვაგნერმა „ნულოვანი ტრიმესტრი“ უწოდა. ველნეს კულტურისა და სოციალური მედიის ინფლუენსერების მიერ წახალისებული, ქალები სულ უფრო მეტად აკეთებენ ცხოვრების წესის, დიეტისა და დანამატების ყოვლისმომცველ ოპტიმიზაციას, რათა უზრუნველყონ ჯანსაღი ჩასახვა, მარტივი ორსულობა და ბავშვისთვის ცხოვრების ჯანსაღი დასაწყისი. ეს მოიცავს ყველაფერს, ჰორმონალურ ტესტირებიდან და ტოქსინებისგან გაწმენდიდან, სპეციფი
ხელოვნური ინტელექტი ენერგოსისტემის ოპტიმიზაციისთვის: MIT-ის ექსპერტი გამოწვევებსა და შესაძლებლობებზე
მიუხედავად იმისა, რომ ხელოვნური ინტელექტი ცნობილია ენერგიის მაღალი მოხმარებით, განსაკუთრებით მონაცემთა ცენტრებში, ზოგიერთ AI ინსტრუმენტს აქვს მნიშვნელოვანი პოტენციალი ენერგიის მოხმარების შესამცირებლად და ელექტროენერგიის ქსელების ეფექტურობის გასაუმჯობესებლად. MIT-ის ექსპერტი, პრია დონტი, განმარტავს, თუ როგორ შეუძლია ხელოვნურ ინტელექტს ქსელის ოპტიმიზაცია, განახლებადი ენერგიის ინტეგრაცია და რთული ბალანსირების პრობლემების გადაჭრა.

AI ძიების რევოლუცია: Microsoft-ის სტრატეგიები წარმატებისთვის ახალ ეპოქაში
ხელოვნური ინტელექტის (AI) განვითარებასთან ერთად, ძიების ლანდშაფტი რადიკალურად იცვლება. Microsoft-ის უახლესი მეგზური გვიჩვენებს, თუ როგორ უნდა მოვახდინოთ კონტენტის ოპტიმიზაცია AI ასისტენტების მიერ რეკომენდაციისთვის, ტრადიციული SEO-დან AEO (Agentic Engine Optimization) და GEO (Generative Engine Optimization) მიმართულებით.