როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი
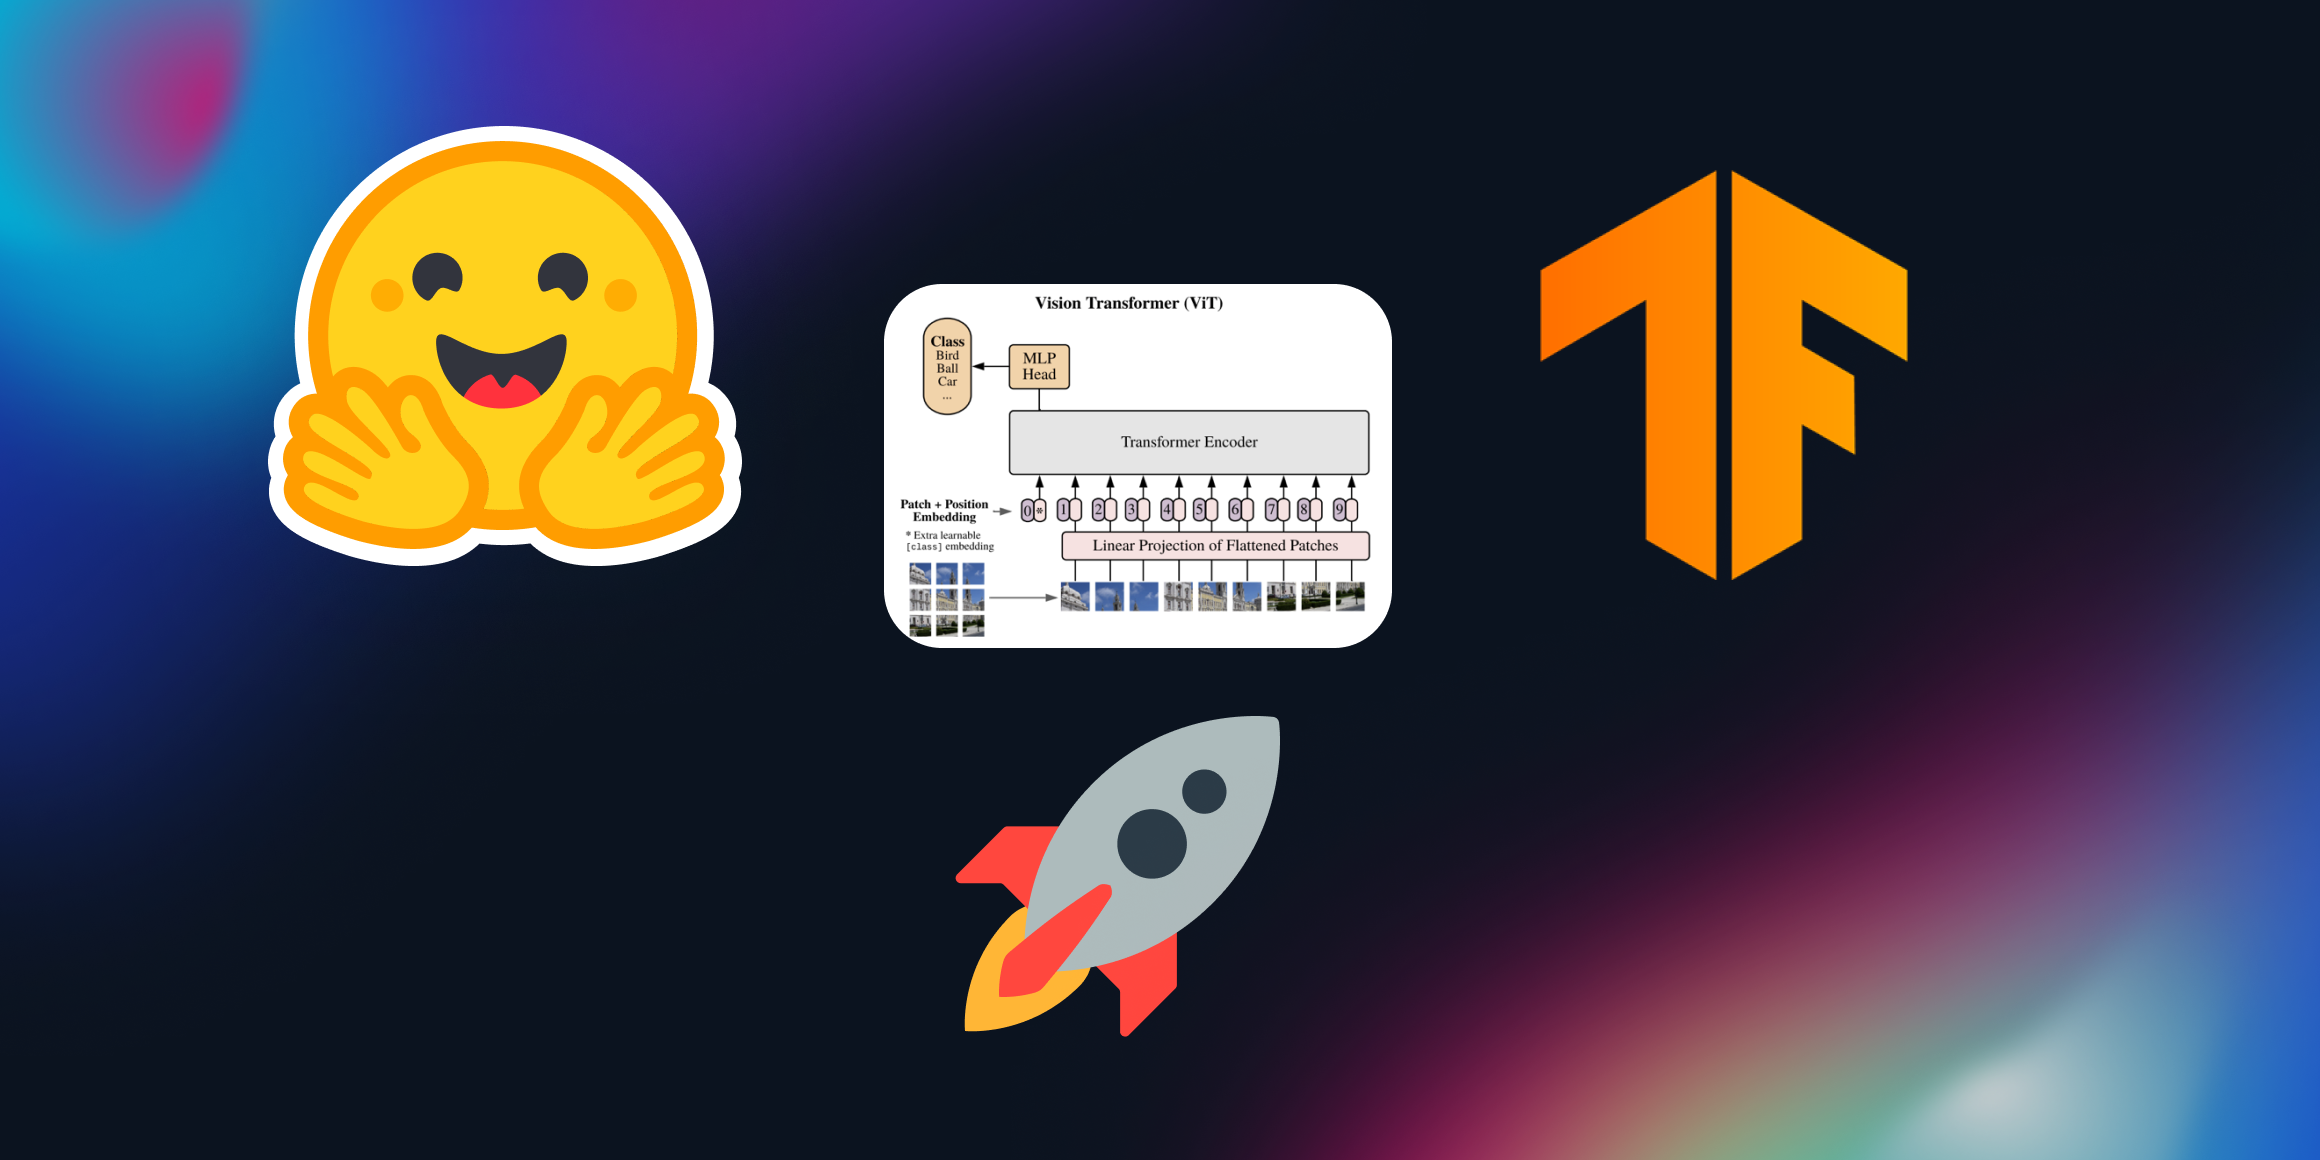
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ავარჯიშეთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი: როგორ აამუშავოთ Half-Cheetah
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს, თუ როგორ უნდა ავარჯიშოთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი ნულიდან. ის განმარტავს Decision Transformer-ის ძირითად კონცეფციას, რომელიც აძლიერებს სწავლის პრობლემას პირობით-თანმიმდევრობის მოდელირების ამოცანად გარდაქმნის გზით, რათა წარმოქმნას მომავალი ქმედებები სასურველი შედეგების, წარსული მდგომარეობებისა და ქმედებების საფუძველზე. გაკვეთილი ფოკუსირებულია ოფლაინ მიდგომაზე, Google Colab-ის, 🤗 Trainer-ის და სპეციალური მონაცემთა კოლატორის გამოყ
ოფლაინ გადაწყვეტილების ტრანსფორმატორის მოდელის გაწვრთნა: ნახევრად-გეპარდის სიმულაციის მიღწევა
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა გაწვრთნათ ოფლაინ გადაწყვეტილების ტრანსფორმატორის (Decision Transformer) მოდელი ნულიდან, რათა სიმულაციურ გარემოში ნახევრად-გეპარდმა შეძლოს მოძრაობა. განხილულია მოდელის ფუნდამენტური პრინციპები, რომელიც განმტკიცებით სწავლებას მიმდევრობის მოდელირების პრობლემად აღიქვამს და წარსული მონაცემებისა და სასურველი შედეგების საფუძველზე სამომავლო მოქმედებებს აგენერირებს. პრაქტიკული გაკვეთილი, რომელიც Google Colab-ზე სრულდება, ხსნის მონაცემთა დამუშავებასა და Hugging Fac
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან
Transformers Agents 2.0-ის გამოშვება: ახალი ეტაპი AI აგენტებში smolagents-თან ერთად
Hugging Face-ი აცხადებს Transformers Agents 2.0-ის გამოშვებას, რომელიც ახლა smolagents-ის სახელით იქნება ცნობილი. ეს განახლება წარმოგიდგენთ ორ ახალ აგენტს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე რთული ამოცანების გადაჭრა. სისტემა გამიზნულია იყოს მკაფიო, მოდულარული და გამჭვირვალე, თემის გაზიარების ოფციებით. აღსანიშნავია მისი გაუმჯობესებული წარმადობა, რადგან Llama-3-70B-Instruct აგენტი აჯობებს GPT-4-ზე დაფუძნებულ აგენტებს GAIA-ს ლიდერთა სიაში. LLM-ებს ხშირად უჭირთ ლოგიკის, გამოთვლისა დ
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე

Sentence Transformers-ის ოპტიმიზაცია: ძირითადი კომპონენტები და ეფექტური მოდელების შექმნა
ამ სტატიაში განხილულია Sentence Transformers-ის მოდელების ოპტიმიზაციის პროცესი, რომელიც მოიცავს მონაცემთა ნაკრებებს, დანაკარგის ფუნქციებს, ვარჯიშის არგუმენტებს, შემფასებლებსა და ახალ ტრენერს. თითოეული კომპონენტი დეტალურადაა აღწერილი მაგალითებთან ერთად, რათა დაგეხმაროთ ეფექტური მოდელების შექმნაში კონკრეტული ამოცანებისთვის, სხვადასხვა მსგავსების კონცეფციის გათვალისწინებით.

Transformers-ის დოკუმენტაციის მასშტაბური განახლება: რატომ გახდა ის აუცილებელი
Transformers-ის ბიბლიოთეკის დოკუმენტაცია, რომელიც თავდაპირველად მანქანური სწავლების ინჟინრებსა და მკვლევრებზე იყო მორგებული, ხელოვნური ინტელექტის (AI) სწრაფი განვითარების ფონზე მოუწესრიგებელი და მოძველებული გახდა. მიმდინარეობს მასშტაბური რედიზაინი, რათა დოკუმენტაცია გახდეს კოდზე ორიენტირებული, გადაწყვეტილებებისკენ მიმართული და მომხმარებელზე მორგებული, განსაკუთრებით კი დეველოპერებისთვის. მიზანია, უზრუნველყოს მისი ზრდა და ადაპტაცია მომავალ საჭიროებებთან, სიხისტე კი მოქნილობით ჩანაცვლდეს.

swift-transformers 1.0: ლოკალური ხელოვნური ინტელექტის ახალი ერა Apple Silicon-ზე
`swift-transformers` ბიბლიოთეკამ გამოუშვა ვერსია 1.0, რაც მის სტაბილურობასა და Apple Silicon პლატფორმებზე, iPhone-ების ჩათვლით, ლოკალური მანქანური სწავლების მოდელების უწყვეტი ინფერენციის მხარდაჭერის მზადყოფნას ადასტურებს. განახლება მიზნად ისახავს საზოგადოებისთვის მაქსიმალური სარგებლის მოტანას, მომავალი განვითარების საფუძვლების ჩაყრას და განსაკუთრებულ ყურადღებას უთმობს MLX-სა და აგენტურ გამოყენების შემთხვევებს.
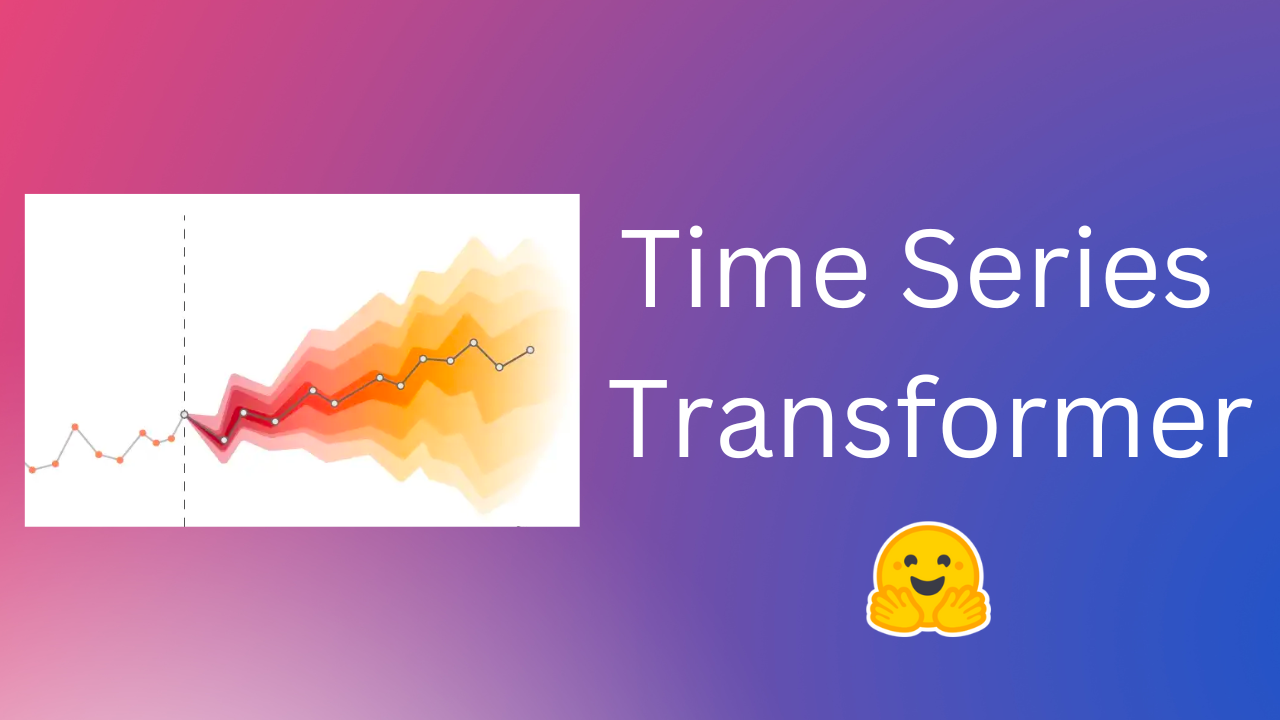
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი
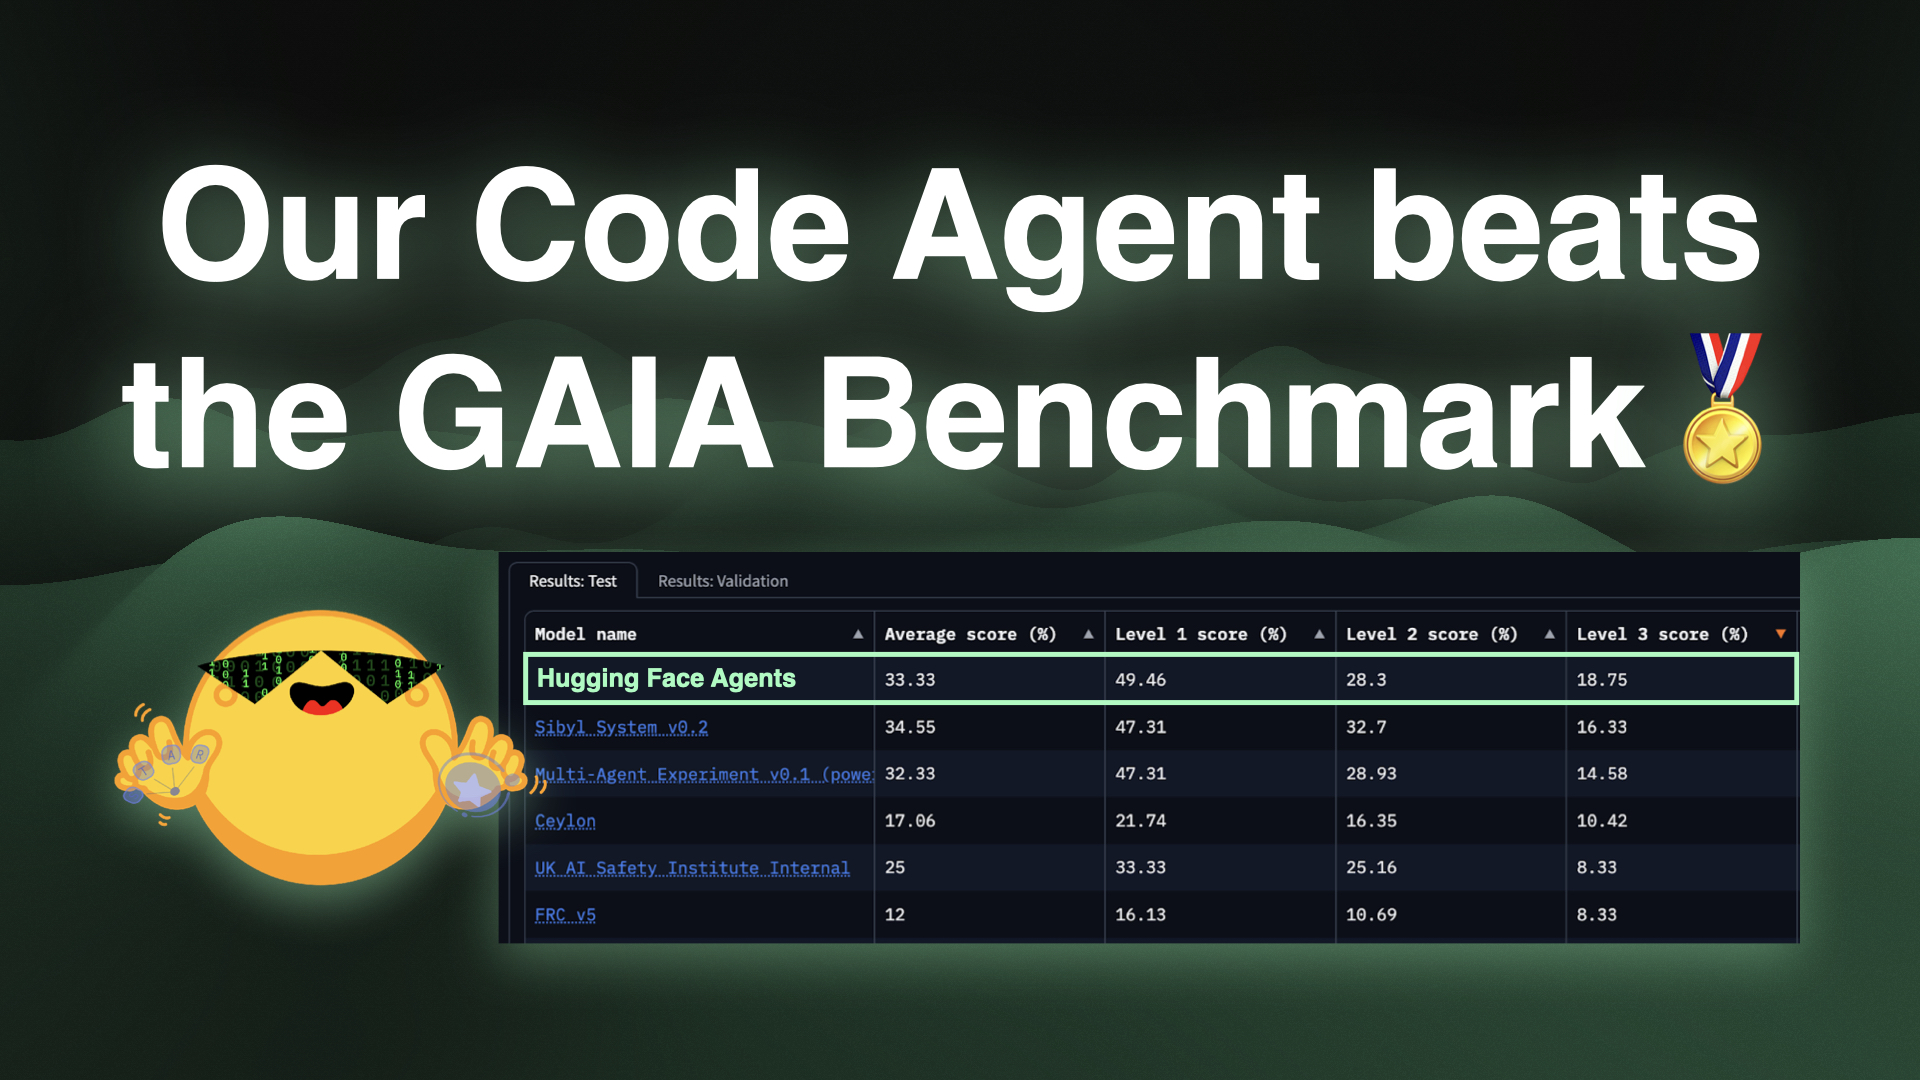
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ
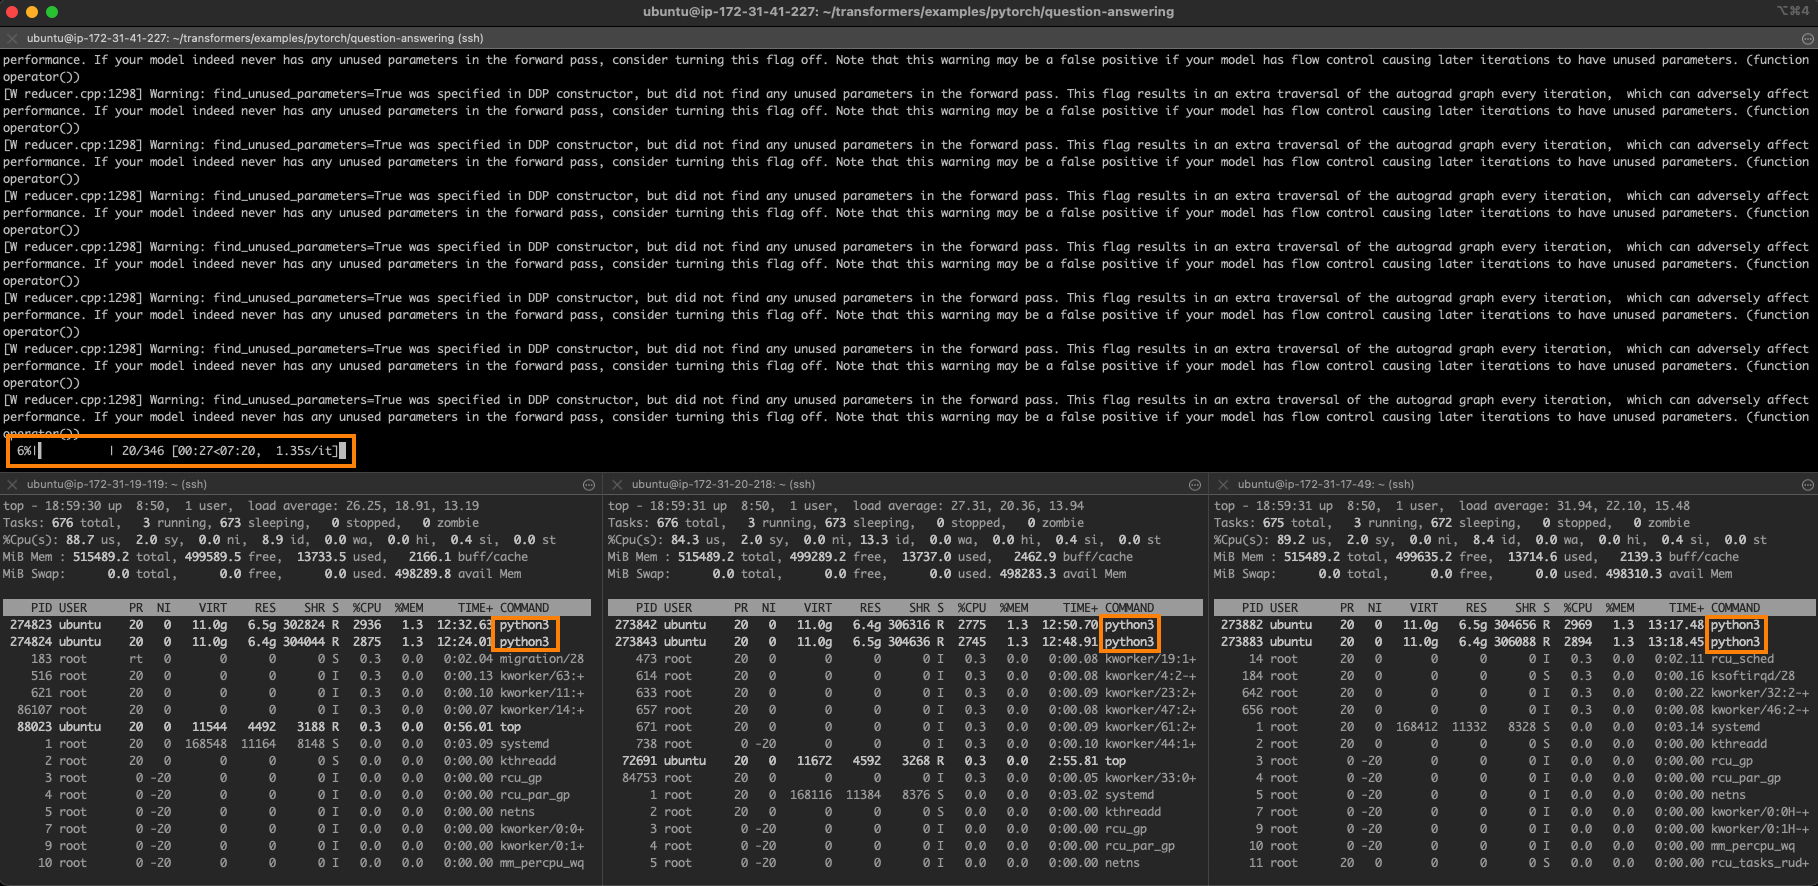
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო

Sentence Transformers Hugging Face-ის ოჯახს უერთდება
Sentence Transformers (SBERT), სემანტიკური მნიშვნელობის მქონე მაღალი ხარისხის ემბედინგების გენერირების პოპულარული ღია კოდის ბიბლიოთეკა, ოფიციალურად შეუერთდა Hugging Face-ის ოჯახს. 2019 წელს ნილს რაიმერსის მიერ დაარსებული პროექტი ფართოდ გამოიყენება ბუნებრივი ენის დამუშავების (NLP) ამოცანებში და უკვე 16,000-ზე მეტ მოდელს მოიცავს, რომლებიც ყოველთვიურად მილიონობით მომხმარებელს ემსახურება. Hugging Face პირობას დებს, რომ გააგრძელებს პროექტის ზრდისა და ინოვაციების მხარდაჭერას, ამავდროულად შეინარჩუნებს

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal