მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე

Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging
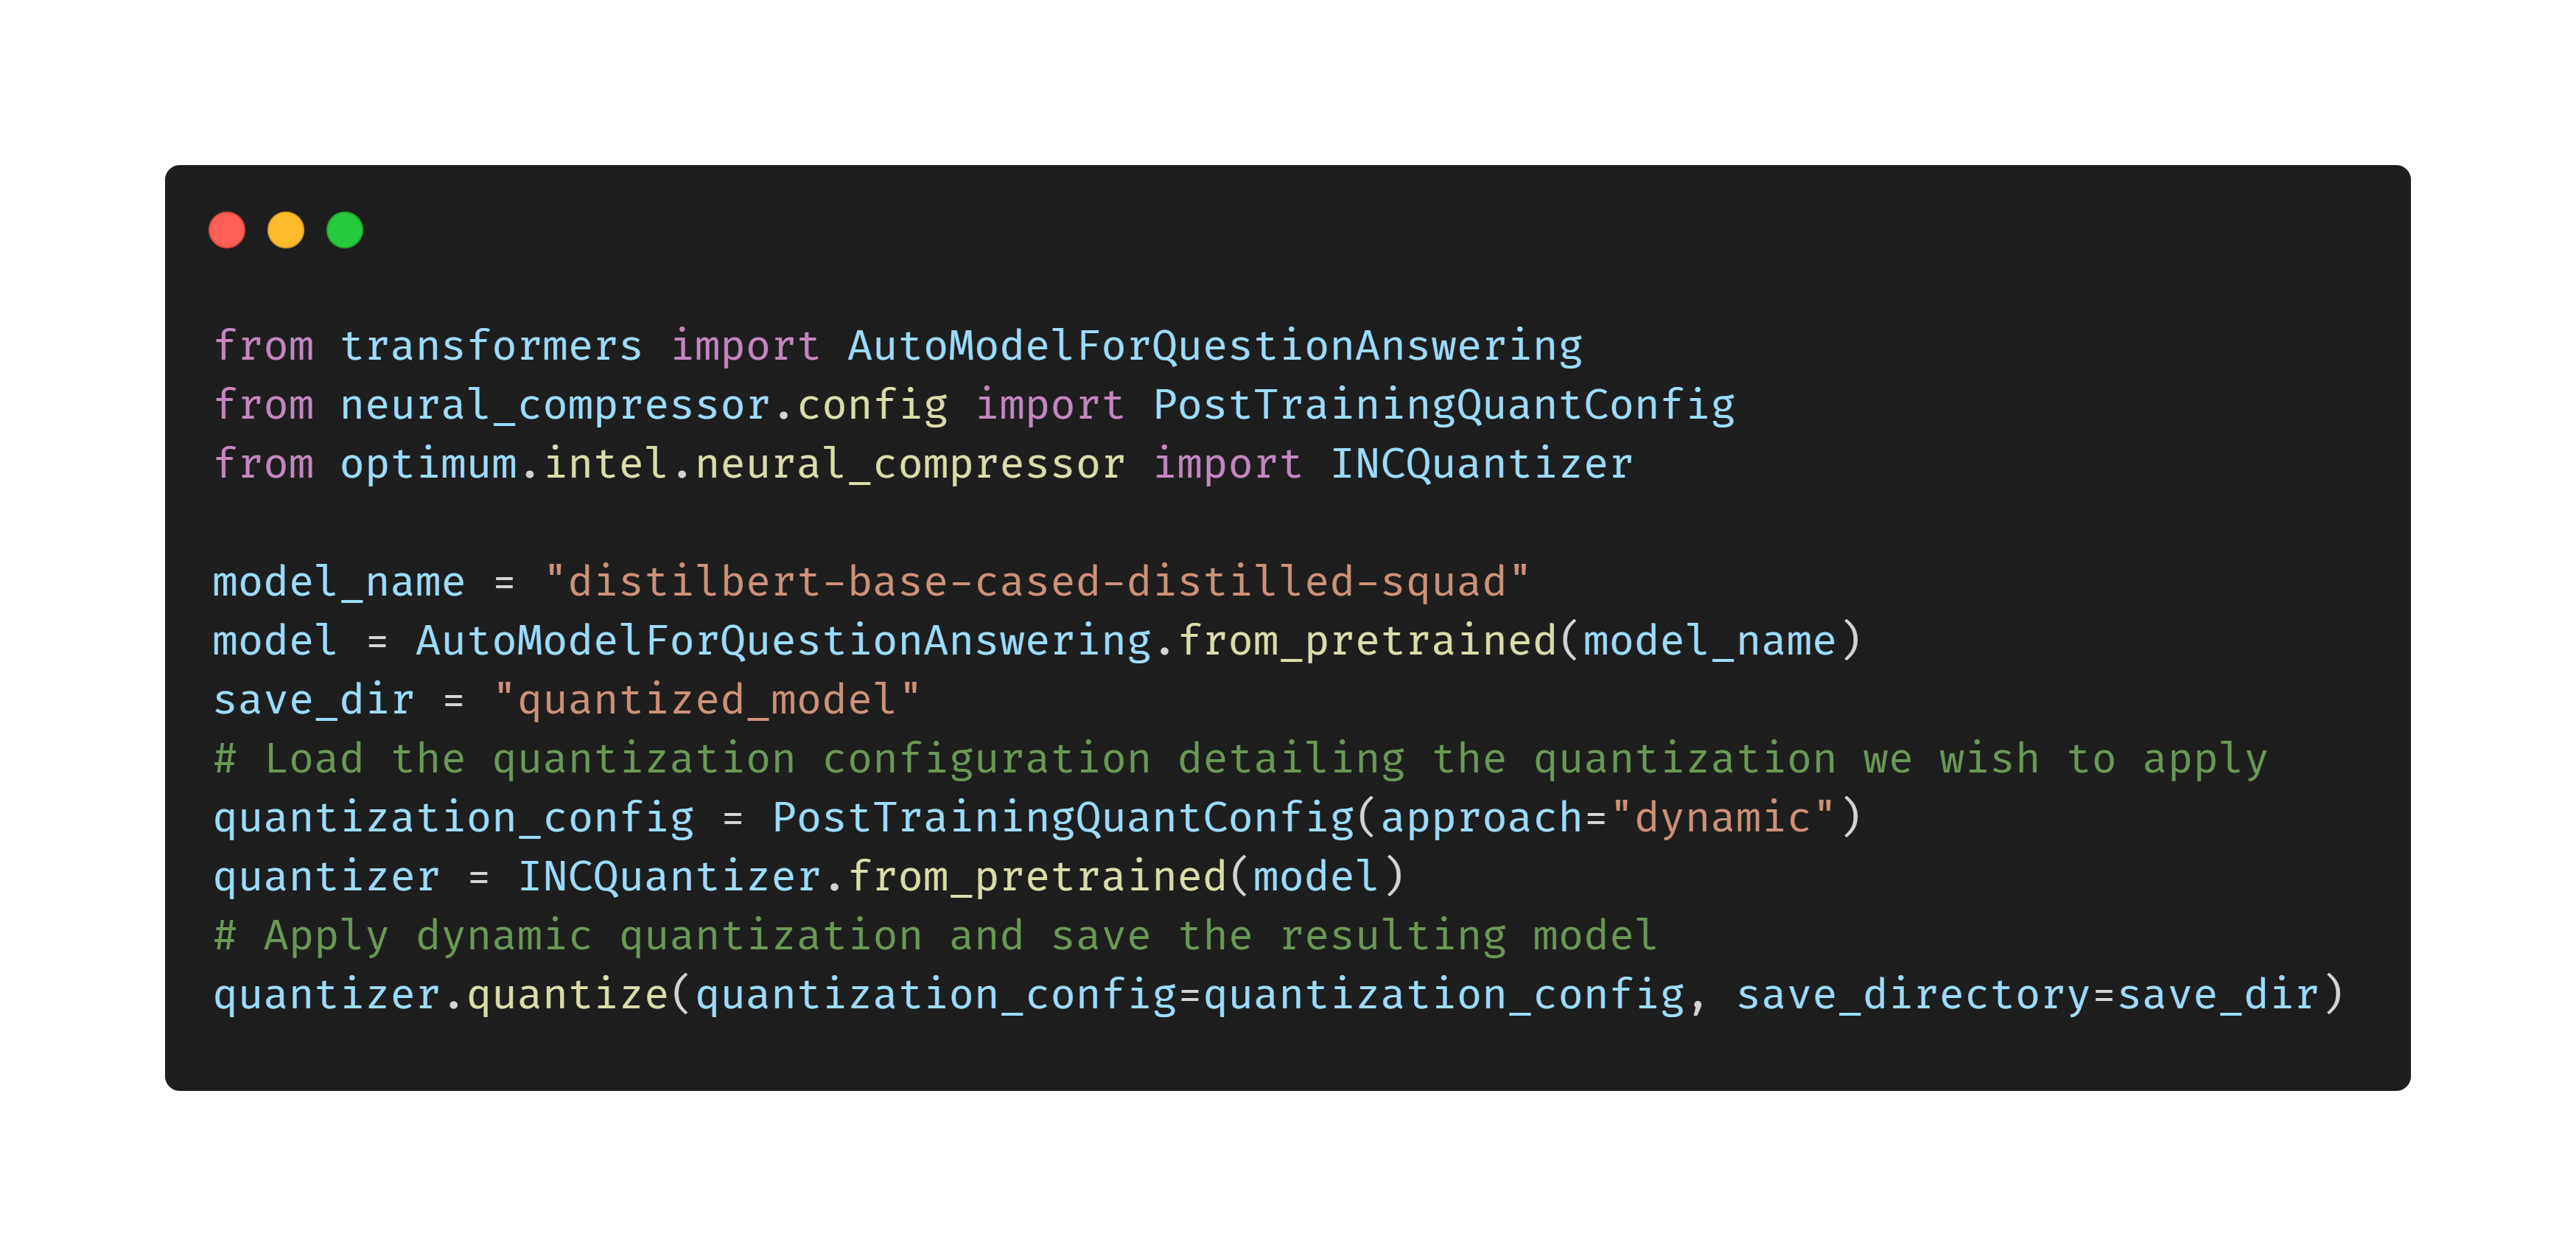
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
LLM-ების ეფექტური განლაგება: გამოთვლითი და მეხსიერების გამოწვევების გადაჭრა
დიდი ენობრივი მოდელები (LLM-ები) სწრაფად იკიდებენ ფეხს ცოდნაზე დაფუძნებულ ინდუსტრიებში, თუმცა მათი რეალურ სამყაროში განლაგება გამოწვევებითაა სავსე, განსაკუთრებით გამოთვლითი რესურსებისა და მეხსიერების კუთხით, ვრცელი შეტანის თანმიმდევრობებთან მუშაობისას. ეს პოსტი მიმოიხილავს ყველაზე ეფექტურ ტექნიკებს LLM-ების ოპტიმიზებული განლაგებისთვის, მათ შორის დაბალ სიზუსტეს (8-ბიტიანი და 4-ბიტიანი), Flash Attention-ს მეხსიერების ეფექტური გამოყენებისთვის და არქიტექტურულ ინოვაციებს, როგორიცაა Alibi, Rotary embe

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
Hugging Face-ი და Graphcore-ი AI-ის ოპტიმიზაციისთვის პარტნიორობენ IPU-ებზე Transformer მოდელების განვითარებით
Hugging Face-ის ახალი აპარატურის პარტნიორის პროგრამა Graphcore-ის სისტემების მომხმარებელ დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ IPU-ებისთვის ოპტიმიზებული უახლესი Transformer მოდელები. ეს თანამშრომლობა მიზნად ისახავს ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას, მაღალი წარმადობისა და ეფექტურობის უზრუნველყოფით ისეთ სფეროებში, როგორიცაა ბუნებრივი ენის დამუშავება (NLP), კომპიუტერული ხედვა და სხვა.
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
3D Gaussian Splatting: რევოლუციური ტექნოლოგია 3D გრაფიკაში
3D Gaussian Splatting არის უახლესი რასტერიზაციის ტექნიკა, რომელიც 3D გარემოს წარმოსახვის ახალ სტანდარტებს აწესებს. სამკუთხედების ნაცვლად გაუსიანების გამოყენებით, ის უზრუნველყოფს მაღალი ხარისხის სცენების რეალურ დროში რენდერინგს, რამაც დიდი ყურადღება მიიპყრო კომპიუტერული გრაფიკის სფეროში. სტატია დეტალურად განიხილავს ამ მეთოდის მუშაობის პრინციპებს, მისი მომზადების პროცესს და პოტენციურ გავლენას მომავალ ტექნოლოგიებზე, მათ შორის ინკარნირებული ხელოვნური ინტელექტის კვლევაზე.
3D Gaussian Splatting: რა არის და რატომ იპყრობს ის ყურადღებას?
3D Gaussian Splatting არის რასტერიზაციის ინოვაციური ტექნიკა, რომელიც საშუალებას იძლევა მაღალი ხარისხის 3D სცენების რეალურ დროში რენდერირებისთვის. ის იყენებს გაუსიანებს სამკუთხედების ნაცვლად, რათა შექმნას სივრცის მკვრივი წარმოდგენა. მეთოდი იწყება SfM-ით წერტილოვანი ღრუბლის შეფასებით, რასაც მოჰყვება გაუსიანებად გარდაქმნა და სტოქასტური გრადიენტული დაშვების გამოყენებით წვრთნა. მისი პოტენციალი მოიცავს ანიმაციას, ანარეკლებს და მნიშვნელოვან გავლენას Embodied AI-ის კვლევაზე, თუმცა მისი სრული ინტეგრაცია

ხელოვნური ინტელექტის აგენტების გაგება და გაუმჯობესება: ტრესინგი და შეფასება Arize Phoenix-ით
AI აგენტების შექმნა მხოლოდ დასაწყისია; მათი ქცევის გაგება და ოპტიმიზაცია გადამწყვეტია. ეს სტატია განმარტავს, თუ როგორ ეხმარება ტრესინგი და შეფასება აგენტების მუშაობის გაანალიზებაში, პრობლემების აღმოფხვრაში და ეფექტურობის უზრუნველყოფაში. Arize Phoenix წარმოადგენს ცენტრალიზებულ პლატფორმას ამ პროცესების რეალურ დროში განსახორციელებლად, OpenTelemetry-სა და OpenInference-თან ინტეგრაციით. განხილულია პრაქტიკული ნაბიჯები DuckDuckGo-ს საძიებო ხელსაწყოს მაგალითზე, სადაც LLM-ები, მაგალითად GPT-4o, გამოიყენე
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.
როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ