
Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის
Streamlit Hugging Face Spaces-ში: ML მოდელებისა და მონაცემთა ვიზუალიზაცია
ეს სტატია განმარტავს, თუ როგორ გამოიყენოთ Streamlit Hugging Face Spaces-თან ერთად მანქანური სწავლების მოდელების დემოების შესაქმნელად და მონაცემთა ნაკრებების ვიზუალიზაციისთვის. ის მოიცავს მოდელების ჰოსტინგს, ინტერფეისის აგებას, მონაცემთა სტრიმინგსა და ვიზუალიზაციის კომპონენტების გამოყენებას, მაგალითად, „Write with Transformer“-ის რეპლიკაციით.
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.
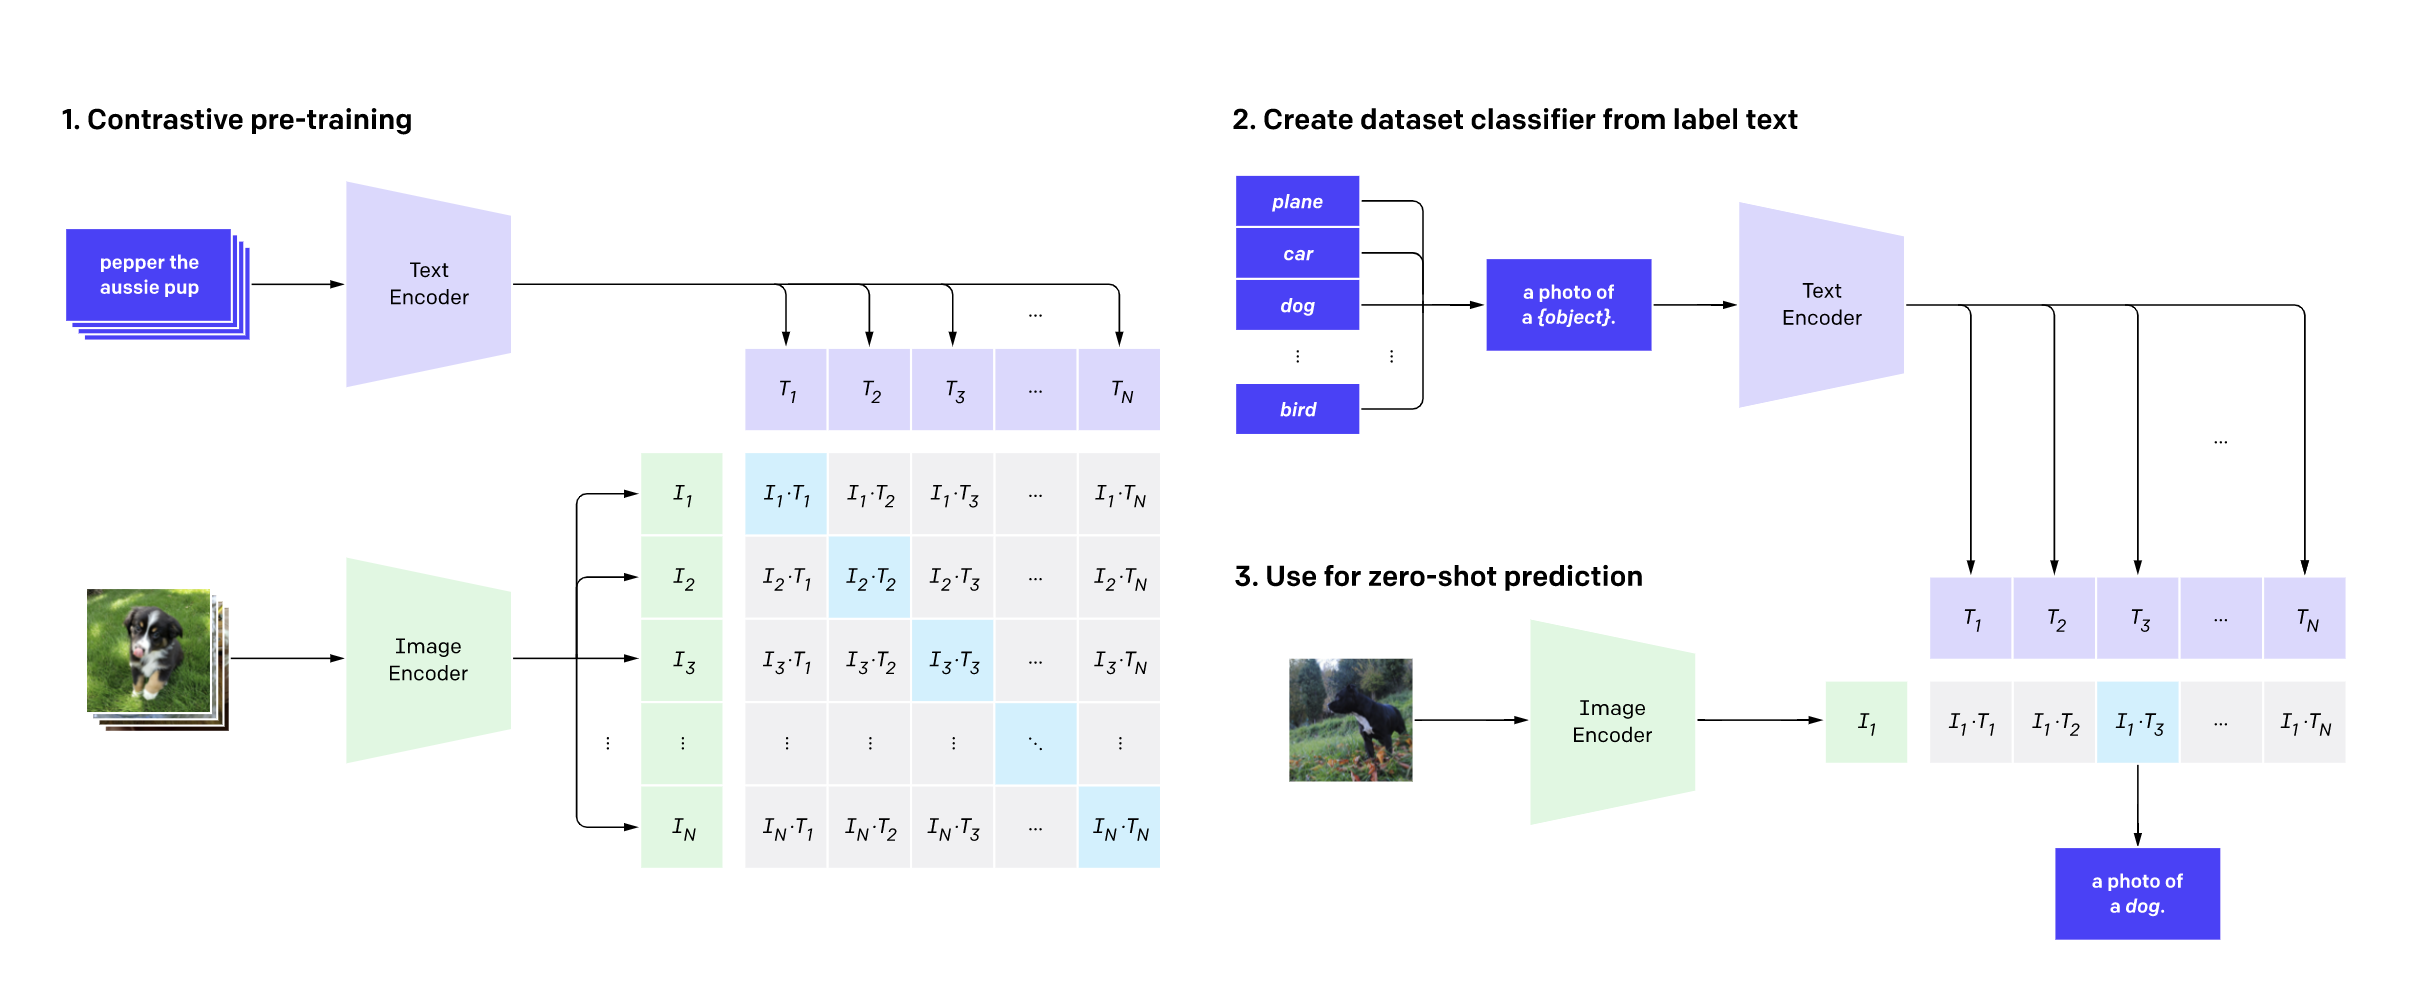
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
ახალი ბენჩმარკი: Llama 2-ის განლაგების ოპტიმალური სტრატეგიები Amazon SageMaker-ზე
დიდი ენობრივი მოდელების (დემ) განლაგება გამოწვევებთან არის დაკავშირებული მათი გამოთვლითი მოთხოვნებისა და დაყოვნების საჭიროებების გამო. ამ პრობლემის გადასაჭრელად, შემუშავდა ყოვლისმომცველი ბენჩმარკი, რომელმაც შეაფასა Llama 2-ის 60-ზე მეტი განლაგების კონფიგურაცია Amazon SageMaker-ზე Hugging Face-ის დემ დასკვნის კონტეინერის გამოყენებით. კვლევამ მიზნად დაისახა ოპტიმალური სტრატეგიების მოძიება კომპანიებისთვის, რათა დააბალანსონ ხარჯები, გამტარუნარიანობა და დაყოვნება Llama 2-ის სხვადასხვა ზომისა და Amazo
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
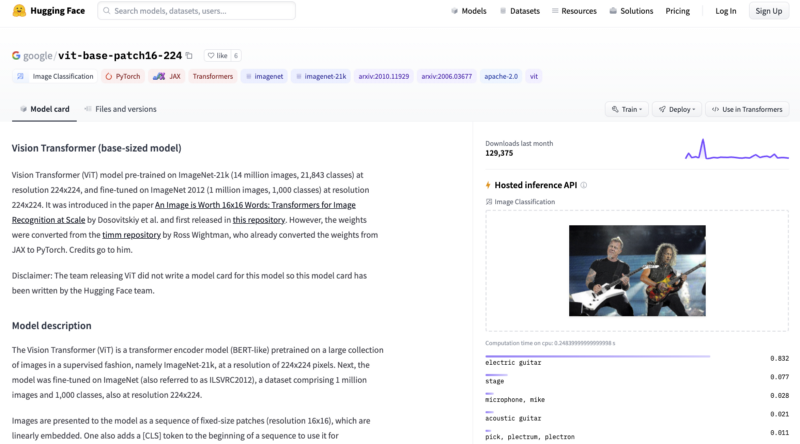
მანქანური სწავლა ყველგან: როგორ ვაქციოთ AI საწარმოო რეალობად MLOps-ისა და ტრანსფორმერების დახმარებით
მანქანური სწავლისა (ML) და ხელოვნური ინტელექტის (AI) ფართო დანერგვის ფონზე, ტექსტი აყენებს კითხვას ინდუსტრიის მზაობის შესახებ ამ მასშტაბური განთავსებისთვის. ავტორი ხაზს უსვამს MLOps-ის მნიშვნელობას, რომელიც აერთიანებს პროგრამული ინჟინერიის საუკეთესო პრაქტიკებს (ვერსიონირება, ხელახალი გამოყენება, ტესტირება) მანქანური სწავლის სამუშაო პროცესებთან. იგი ამტკიცებს, რომ საჭიროა მეტი ML-ში გათვითცნობიერებული პროგრამული უზრუნველყოფის და DevOps ინჟინერი, ვიდრე უბრალოდ მონაცემთა მეცნიერი, რათა მოდელები წარ
ხელოვნური ინტელექტი და მისი განვითარება: გამოწვევები, MLOps-ის მნიშვნელობა და ტრანსფორმერების აღზევება
ხელოვნური ინტელექტი (ხი) და მანქანური სწავლება (მს) სულ უფრო ხშირად გამოიყენება კრიტიკულ ინფრასტრუქტურაში, თუმცა ჩნდება კითხვები ინდუსტრიის სიმწიფისა და მასშტაბური დანერგვის შესახებ. სტატია განიხილავს მყარი მს-სამუშაო პროცესების შექმნის აუცილებლობას, ხაზს უსვამს MLOps-ის, როგორც DevOps-ის გაგრძელების, მნიშვნელობას და ამტკიცებს, რომ პროგრამული უზრუნველყოფის და DevOps ინჟინრები, რომლებსაც ესმით მანქანური სწავლება, უფრო მეტად არიან საჭირო, ვიდრე უბრალოდ მონაცემთა მეცნიერები. ასევე, ყურადღება ექცევა
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.

Yaak-ი და LeRobot-ი L2D-ს, მსოფლიოში უდიდეს მულტიმოდალურ მონაცემთა ბაზას, წარადგენენ რობოტიკის ხელოვნური ინტელექტისთვის
კომპანია Yaak-მა, 🤗-ის LeRobot გუნდთან თანამშრომლობით, გამოაცხადა Learning to Drive (L2D) — მსოფლიოში უდიდესი მულტიმოდალური მონაცემთა ბაზა. L2D მიზნად ისახავს რობოტიკის ხელოვნური ინტელექტის პოტენციალის განბლოკვას ავტონომიური მართვის სფეროში, განსაკუთრებული მხარდაჭერით LeRobot-ის ტრენინგის პაიპლაინებისთვის. მონაცემთა ბაზა მოიცავს რეალურ მართვის სცენარებს 60 ელექტრომობილიდან, რომლებსაც გერმანიის 30 ქალაქში ავტოსკოლები მართავდნენ. ის განასხვავებს ექსპერტისა და სტუდენტის მართვის პოლიტიკებს, ბუნებრივ
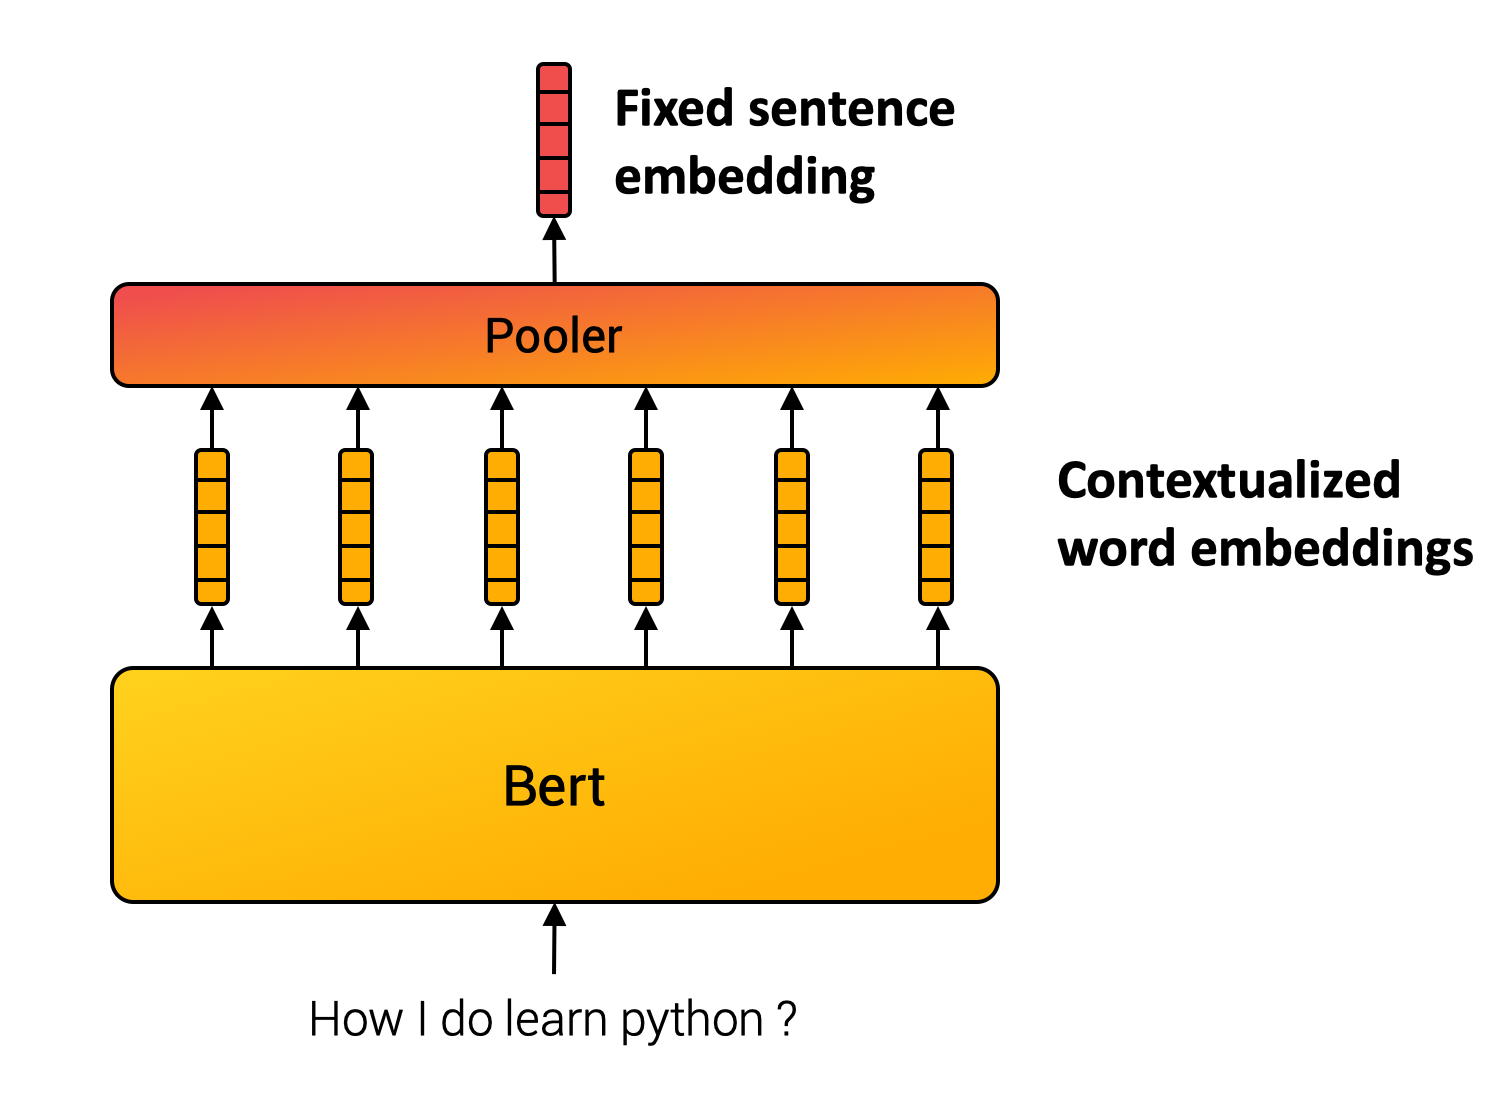
Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე

"OlympicCoder": ხელოვნური ინტელექტის ახალი მოდელები კონკურენტულ პროგრამირებაში გიგანტებს აჭარბებენ
მკვლევრებმა შეიმუშავეს ხელოვნური ინტელექტის მოდელების ახალი ნაკრები, სახელწოდებით „OlympicCoder“, რომელიც სპეციალურად კონკურენტული პროგრამირებისთვის არის შექმნილი. CodeForces-ისა და IOI-ის მორგებულ მონაცემთა ბაზებზე გაწვრთნილი OlympicCoder-32B აჩვენებს უმაღლეს დონის შესრულებას, აჯობა ბევრ მნიშვნელოვნად უფრო დიდ, ღია წყაროს მოდელს კოდის მსჯელობის ამოცანებში. ეს მიღწევა უპასუხებს არსებული მონაცემთა ბაზების შეზღუდვებს, სრულად გადამოწმებადი პრობლემური ნაკრებებისა და დეტალური გადაწყვეტილებების მიწოდე
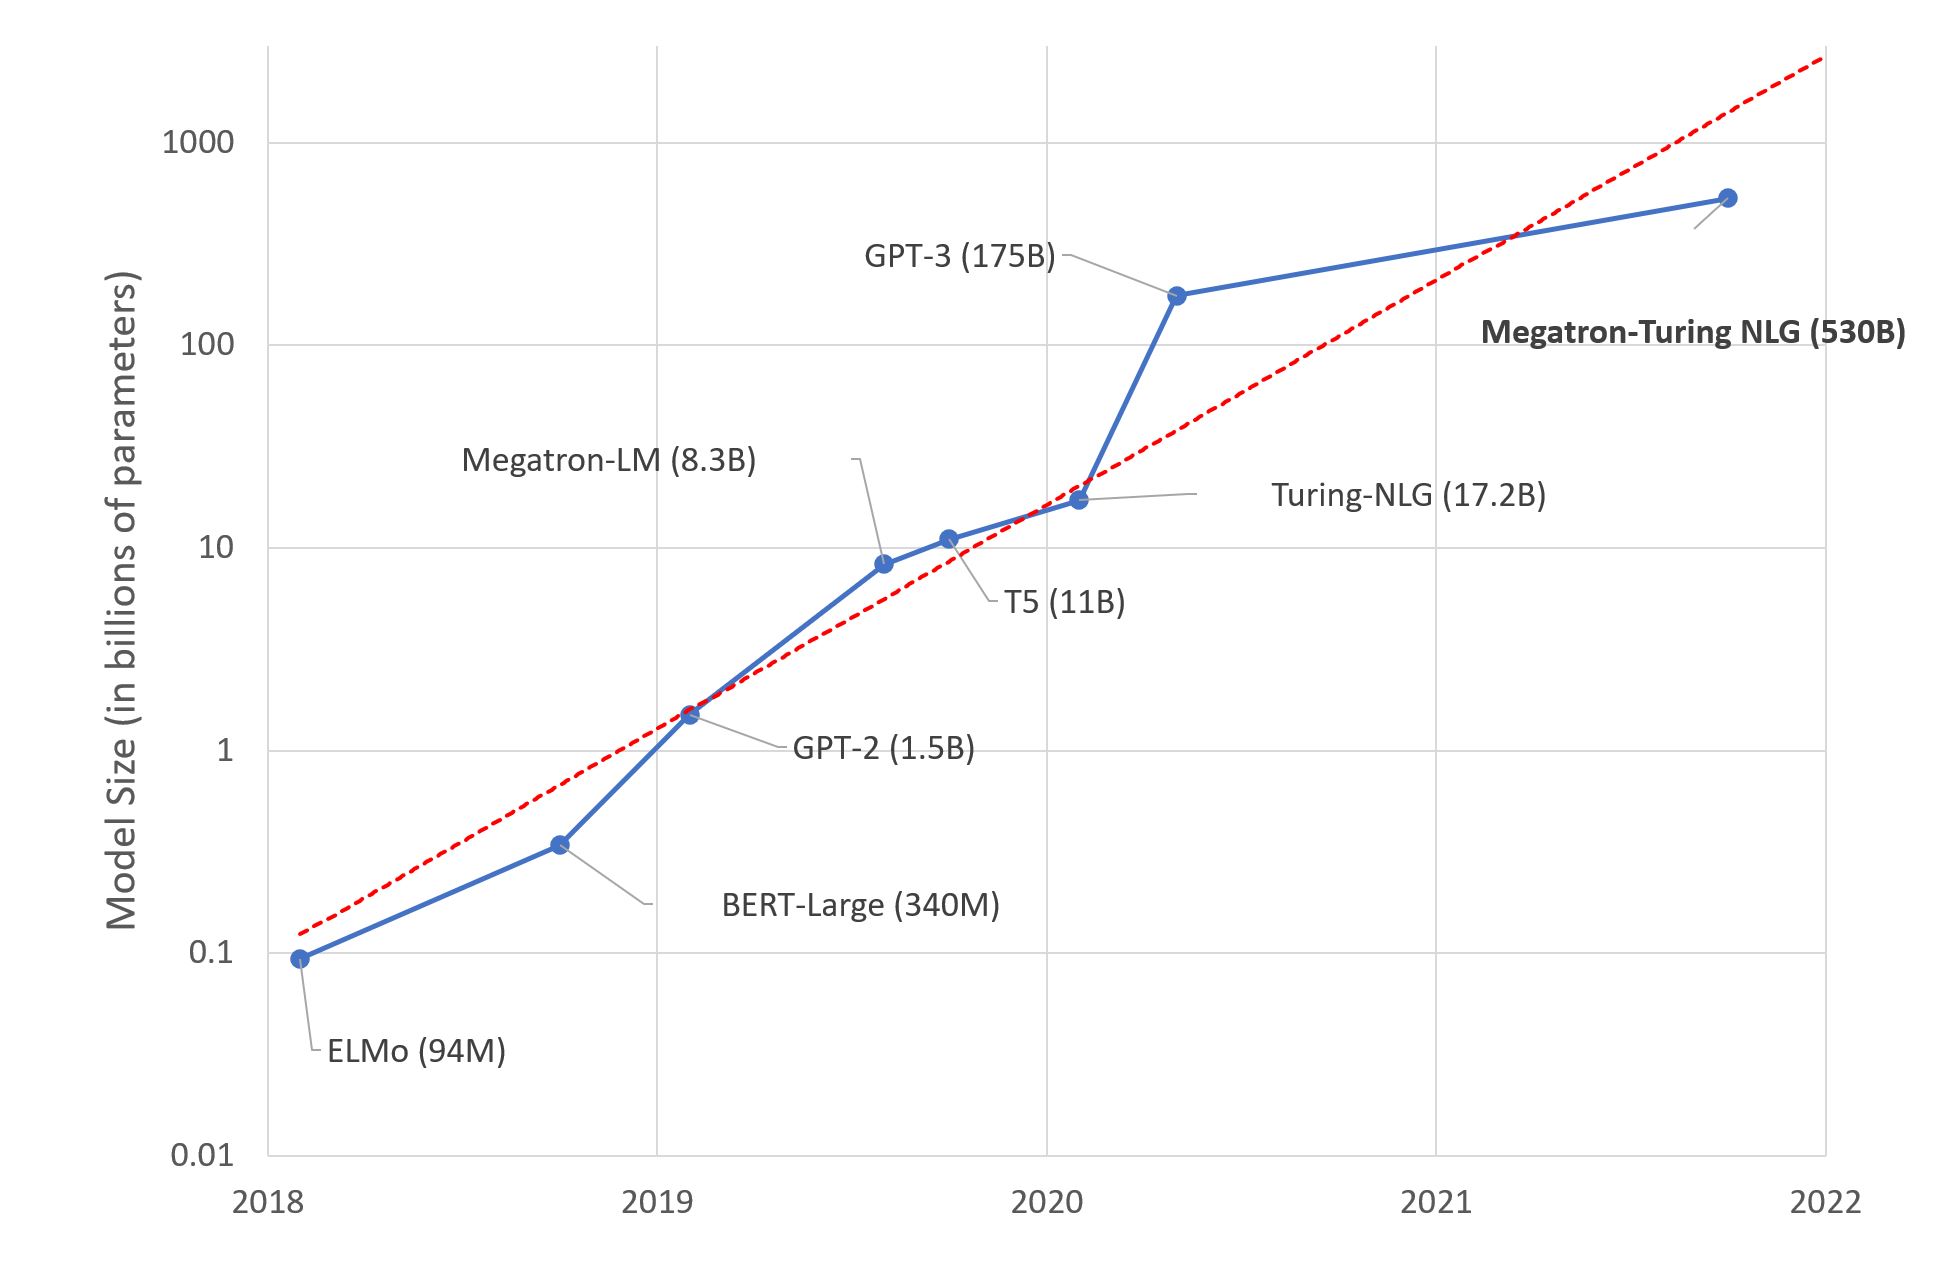
ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f

Hugging Face-ის მუშაობა ხელოვნური ინტელექტის ეთიკაზე: რეგულაციების ფორმირება და ღიაობის ხელშეწყობა
Hugging Face დეტალურად აღწერს თავის ფართომასშტაბიან მუშაობას ხელოვნური ინტელექტის ეთიკის სფეროში, მათ შორის ევროკავშირის, დიდი ბრიტანეთისა და აშშ-ის კანონმდებლებთან თანამშრომლობას მომავალი რეგულაციების ჩამოსაყალიბებლად. კომპანია ხაზს უსვამს ღიაობის, ანგარიშვალდებულებისა და დემოკრატიზაციისადმი თავის ერთგულებას საჯარო გამოსვლებით, კვლევებითა და ახალი რესურსებით, რითაც ხაზგასმულია ადამიანური ღირებულებების ცენტრალური როლი პასუხისმგებლიანი ხელოვნური ინტელექტის განვითარებაში. ასევე აღინიშნება გუნდის მ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
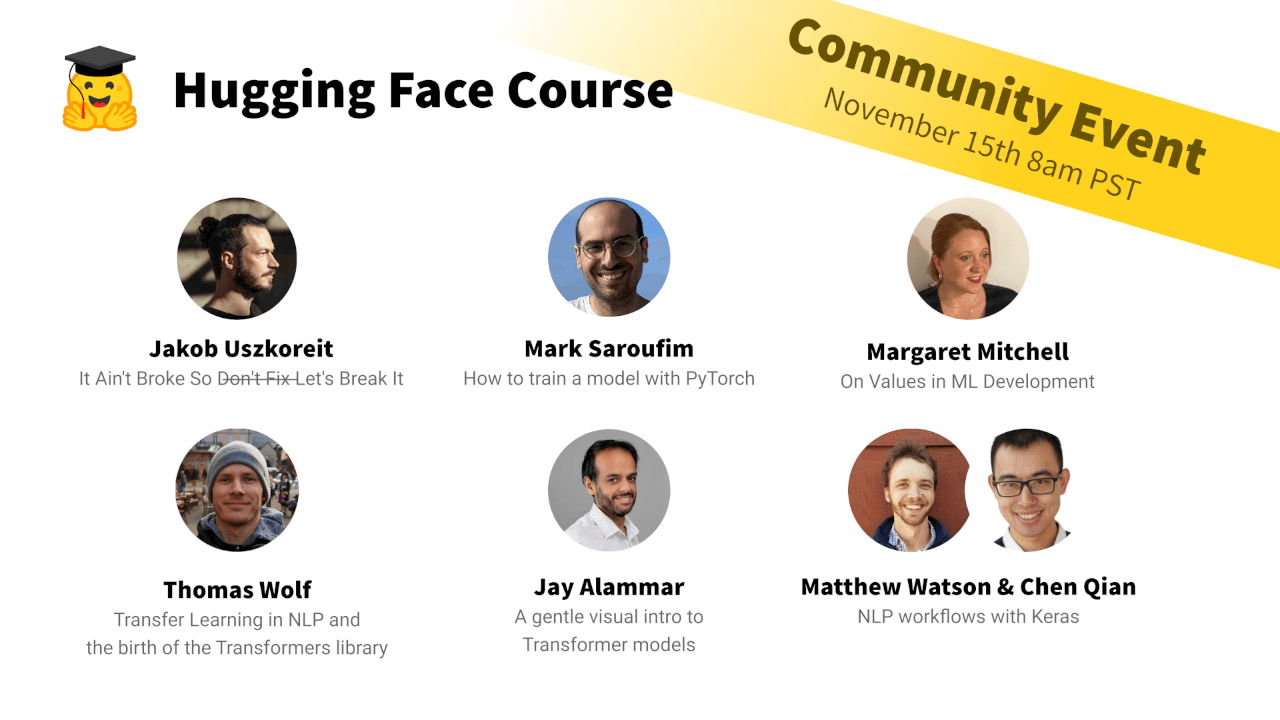
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
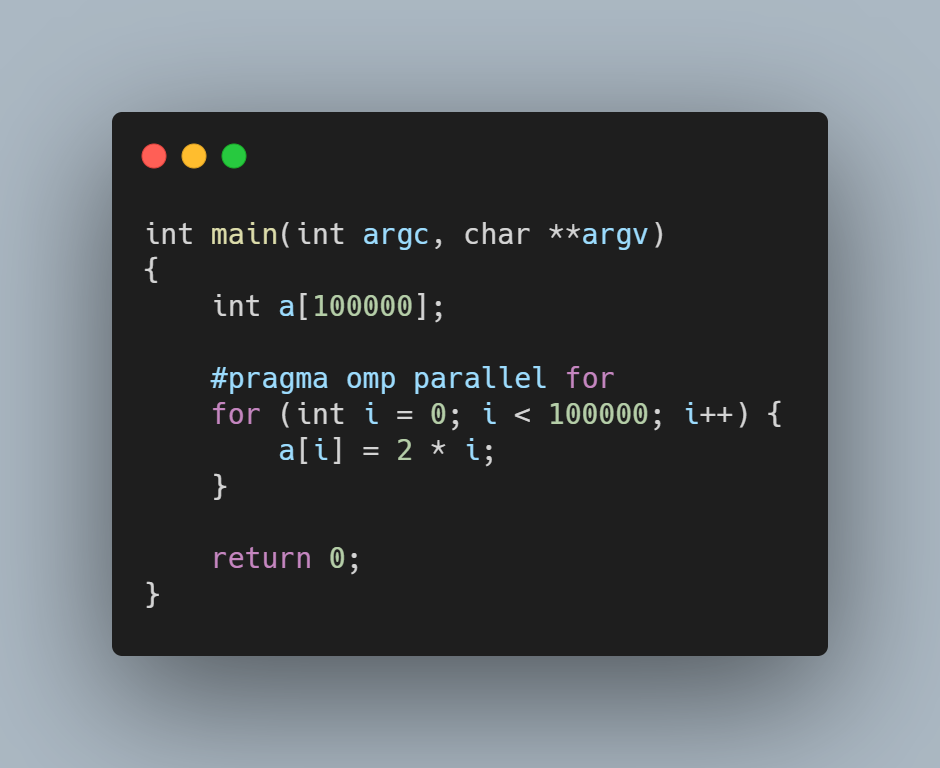
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და