
SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის მოდელები: არქიტექტურისა და ინფერენციის სიღრმისეული მიმოხილვა
ეს ბლოგ-პოსტი დეტალურად განმარტავს, თუ როგორ ამუშავებენ ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის არქიტექტურის მოდელები მიმდევრობა-მიმდევრობაზე ამოცანებს. განხილულია მათემატიკური მოდელი და მისი გამოყენება ინფერენციაში, NLP-ში მიმდევრობა-მიმდევრობაზე მოდელების ისტორიულ კონტექსტთან ერთად. იგი ყოფს ტრანსფორმერის არქიტექტურას ენკოდერისა და დეკოდერის ნაწილებად, გვაწვდის ვიზუალურ მასალას და აკავშირებს თეორიას 🤗Transformers-ის პრაქტიკულ გამოყენებასთან. სტატია მოკლედ მიმოიხილავს ნეირონული ენკოდერ-დეკო
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.
Stable Diffusion XL სამომხმარებლო აპარატურაზე: მოდელის ზომისა და მუშაობის ოპტიმიზაციის ახალი გზები
Stable Diffusion XL (SDXL) დიდი ზომის მოდელია, თუმცა მისი გაშვება უკვე შესაძლებელია 16 GB GPU RAM-ის მქონე CUDA აპარატურაზე, მათ შორის Colab-ის უფასო ვერსიაზეც. ბოლო თვეებში გაიზარდა ინტერესი ML მოდელების ადგილობრივად გაშვების მიმართ, რაც განპირობებულია კონფიდენციალურობითა და მოხერხებულობით. Apple-მა და Hugging Face-მა წარმოადგინეს SDXL-ის Core ML ვერსია, რომელიც ღია წყაროა. ნერგდება ახალი ტექნიკა – შერეული ბიტის პალეტიზაცია (mixed-bit palettization), რომელიც მნიშვნელოვნად ამცირებს მოდელის ზომას

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
მოწინავე ჰიპერპარამეტრების ოპტიმიზაცია Hugging Face Transformers-თან და Ray Tune-თან ერთად
მანქანური სწავლების მოდელების ეფექტურობის გასაუმჯობესებლად აუცილებელია ჰიპერპარამეტრების დარეგულირება, თუმცა ხშირად მას სათანადო ყურადღება არ ექცევა. Hugging Face Transformers-ის 3.1 ვერსიაში Hugging Face Transformers-მა და Ray Tune-მა გააერთიანეს ძალები, რათა შემოგვთავაზონ მარტივი, მაგრამ მძლავრი ინტეგრაცია. ეს გადაწყვეტა უზრუნველყოფს მოწინავე ოპტიმიზაციის ალგორითმებზე მარტივ წვდომას, როგორიცაა PBT, HyperBand და ბაიესური ოპტიმიზაცია, რაც მნიშვნელოვნად აუმჯობესებს მოდელების მუშაობას და ინარჩუნებ
Segmind-ის ინოვაცია: გენერაციული AI მოდელები SD-Small და SD-Tiny - უფრო სწრაფი და ეფექტური
კომპანია Segmind-მა წარმოადგინა შეკუმშული გენერაციული AI მოდელები, SD-Small და SD-Tiny, რომლებიც მნიშვნელოვნად აჩქარებენ დასკვნის გამოტანის პროცესს და ამცირებენ რესურსების მოხმარებას. Knowledge-Distillation (KD) ტექნიკით გაწვრთნილი ეს მოდელები საბაზისო მოდელებთან შედარებით 35%-ით და 55%-ით ნაკლებ პარამეტრს შეიცავს, მაგრამ გამოსახულების შედარებით ხარისხს ინარჩუნებს. წინა წელს გამოშვებულ voltaML ბიბლიოთეკასთან ერთად, რომელიც ინფერენციის სიჩქარეს 4-6-ჯერ ზრდის, ახალი მოდელები 100%-მდე მეტ სისწრაფეს
smolagents: ვიზუალური მხარდაჭერა და აგენტური ბრაუზერი
ჩვენ smolagents-ს დავუმატეთ ვიზუალური მხარდაჭერა, რაც ხსნის ვიზუალური ენობრივი მოდელების (VLM) გამოყენების შესაძლებლობას აგენტურ პაიპლაინებში მშობლიური ინტეგრაციით. ეს სიახლე მნიშვნელოვნად აუმჯობესებს ისეთ შესაძლებლობებს, როგორიცაა ვებ-დათვალიერება, სადაც ვიზუალური კონტენტი სრულად ვერ აღდგება მხოლოდ ტექსტის ამოღებით. ეს განახლება აგენტებს ნამდვილ სუპერძალას ანიჭებს, რის შედეგადაც მათ შეუძლიათ, მაგალითად, სრულ ავტონომიაში იმოძრაონ ვებ-სივრცეში.
როგორ შევქმნათ PS1-ის სტილის 3D აქტივები გენერაციული ხელოვნური ინტელექტის გამოყენებით
ეს სტატია გთავაზობთ პრაქტიკულ სახელმძღვანელოს, თუ როგორ უნდა მოხდეს გენერაციული ხელოვნური ინტელექტის ინტეგრირება PlayStation 1-ის სტილის 3D აქტივების შექმნაში თამაშებისთვის. ის განმარტავს, თუ რატომ არის ეს სტილი იდეალური არსებული text-to-3D მოდელების დაბალი ხარისხისთვის და გვიჩვენებს ნაბიჯ-ნაბიჯ პროცესს Shap-E-სა და Blender-ის (Dream Textures-თან ერთად) გამოყენებით, ტექსტიდან გამოსაყენებელი დაბალხარისხოვანი 3D მოდელის მისაღებად. სტატია ხაზს უსვამს ამ მეთოდის პოტენციალს უსასრულო დაბალხარისხოვანი

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ
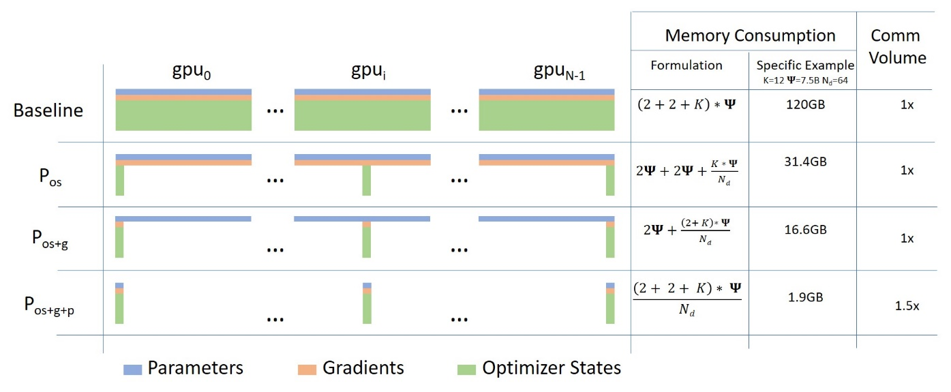
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ

ხელოვნური ინტელექტი და ხელოვნება: 2024 წლის საკვანძო მიღწევების მიმოხილვა და 2025 წლის მოლოდინები
ბოლო რამდენიმე წელი გადამწყვეტი აღმოჩნდა ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნების სფეროში. შემოქმედებითი გამოხატვისთვის განკუთვნილი ხელოვნური ინტელექტის ხელსაწყოები არასოდეს ყოფილა ასეთი ხელმისაწვდომი, და ეს მხოლოდ დასაწყისია. ეს სტატია მიმოიხილავს 2024 წლის ძირითად მიღწევებს ხელოვნური ინტელექტის მიერ გენერირებულ გამოსახულებებში, მათ შორის DiT არქიტექტურის, პერსონალიზაციისა და „ზერო-შოთ“ ტექნიკების წინსვლას. ხაზგასმულია, თუ როგორ ეჯიბრებიან ღია კოდის მოდელები დახურული კოდის გიგანტებ
ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
PyTorch/XLA და Hugging Face: გაუმჯობესებული მხარდაჭერა Cloud TPU-ებზე მოდელების ვარჯიშისთვის
PyTorch-TPU პროექტის ფარგლებში, რომელიც Facebook PyTorch-ისა და Google TPU-ის გუნდების თანამშრომლობით დაიწყო 2019 წელს, Hugging Face-თან ახალი ინტეგრაცია განხორციელდა. ეს ინტეგრაცია PyTorch-ის მომხმარებლებს საშუალებას აძლევს, ეფექტურად გააფართოვონ თავიანთი ხელოვნური ინტელექტის მოდელები Cloud TPU-ებზე, Hugging Face-ის ტრენერების ნაცნობი ინტერფეისის შენარჩუნებით. ეს სიახლე მნიშვნელოვნად ამარტივებს და აჩქარებს ღრმა სწავლის მოდელების ვარჯიშის პროცესს.