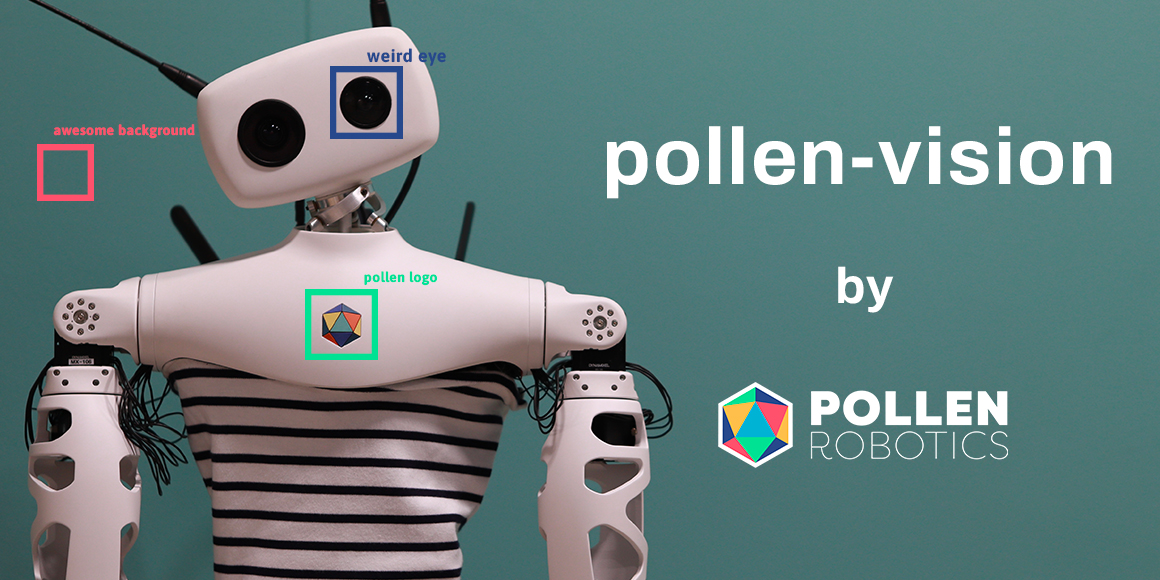
Pollen-vision: ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს უცნობი ობიექტების ავტონომიურ დაჭერაში ეხმარება
წარდგენილია Pollen-vision, ახალი ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს გარემოს ვიზუალური აღქმის საფუძველზე გაგებაში და 3D ობიექტების დეტექციაში ეხმარება. მისი მთავარი მიზანია რობოტების ავტონომიური ფუნქციონირება უცნობი ობიექტების წინასწარი წვრთნის გარეშე დაჭერის მიზნით.
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

TimeScope: ახალი ბენჩმარკი ხელოვნური ინტელექტის გრძელი ვიდეოების აღქმის სიღრმის შესამოწმებლად
TimeScope არის ახალი ღია კოდის ბენჩმარკი, რომელიც შექმნილია იმის შესაფასებლად, თუ რამდენად კარგად ესმით ვიზუალურ-ლინგვისტურ მოდელებს გრძელი ვიდეოები. ის ვიდეოებში (1 წუთიდან 8 საათამდე) მოკლე „ნემსის“ კლიპების ჩართვით აფასებს მოდელების უნარს არა მხოლოდ ინფორმაციის მოძიებაში, არამედ მის სინთეზში, ლოკალიზაციასა და წვრილმარცვლოვან მოძრაობის ანალიზში, რითაც არსებულ ტესტებში არსებულ ხარვეზებს ავსებს და AI-ს გრძელი ვიდეოების გაგების ნამდვილ შესაძლებლობებს ავლენს.
LiveCodeBench: ხელოვნური ინტელექტის პროგრამირების აგენტების შეფასების ინოვაციური სისტემა კონტამინაციის პრევენციით
LiveCodeBench არის პლატფორმა, რომელიც აგროვებს კოდირების ამოცანებს სხვადასხვა კონკურსის პლატფორმებიდან და აღნიშნავს მათ გამოშვების თარიღებს. ეს საშუალებას იძლევა მოდელების შეფასებას დროთა განმავლობაში, რაც ხელს უშლის მონაცემთა დაბინძურებას (კონტამინაციას). სტანდარტული კოდის გენერაციის გარდა, LiveCodeBench ასევე აფასებს თვითშეკეთებას, ტესტის შედეგის პროგნოზირებას და კოდის შესრულებას, რაც ჰოლისტურ ხედვას იძლევა AI პროგრამირების აგენტების შესაძლებლობებზე. ამოცანები LeetCode-დან, AtCoder-იდან და Cod
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.

Hugging Face-ის Trackio: ახალი ღია კოდის გადაწყვეტა მანქანური სწავლის ექსპერიმენტების თრექინგისთვის
Trackio არის Hugging Face-ის მიერ შემუშავებული ღია კოდის Python ბიბლიოთეკა მანქანური სწავლის მოდელების ვარჯიშის პროგრესის თრექინგისთვის. ის გვთავაზობს მარტივ გაზიარებას, მონაცემთა ხელმისაწვდომობას, ენერგიის მოხმარების გამჭვირვალობას და მოქნილობას ექსპერიმენტებისთვის. ბიბლიოთეკა, რომელიც თავსებადია ისეთ ინსტრუმენტებთან, როგორიცაა wandb, საშუალებას გაძლევთ ადვილად ვიზუალიზაცია მოახდინოთ Gradio დაფაზე და სინქრონიზაცია გაუკეთოთ Hugging Face Spaces-ს.
Hugging Face წარმოგიდგენთ Trackio-ს: ღია კოდის ბიბლიოთეკა ML ექსპერიმენტების მარტივი თვალთვალისთვის
Hugging Face-ის გუნდმა შეიმუშავა Trackio, ღია კოდის Python ბიბლიოთეკა მანქანური სწავლების ექსპერიმენტების თვალთვალისთვის. ის გამოირჩევა გაზიარების სიმარტივით, მონაცემთა ხელმისაწვდომობითა და მოქნილობით. Trackio იყენებს ლოკალურ Gradio დაფას, რომელიც შეიძლება სინქრონიზდეს Hugging Face Spaces-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ პროგრესი. ის ინტეგრირდება Hugging Face-ის სხვა ბიბლიოთეკებთან და მიზნად ისახავს საზოგადოების ჩართულობით განვითარებას, როგორც მსუბუქი და გამჭვირვალე ალ
როგორ მოვახდინოთ ცილების სტრუქტურის ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js-ის გამოყენებით
ამ სტატიაში აღწერილია, თუ როგორ შეიძლება ცილის სტრუქტურების ინტერაქტიული ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js ბიბლიოთეკისა და Gradio-ს გამოყენებით. ცილები სასიცოცხლოდ მნიშვნელოვანია, ხოლო მანქანური სწავლა გვეხმარება ახალი ცილების შექმნაში. სტრუქტურის გაგება გადამწყვეტია მათი ფუნქციისთვის. სტატია დეტალურად განიხილავს დემო აპლიკაციის შექმნას PDB კოდის ან ფაილის გამოყენებით, ტექნიკურ ასპექტებს iframe-ებით და ბრაუზერის უსაფრთხოების წესებს. მოცემულია ინტეგრაციის მეთოდები ML მოდელებთან და მოწი

NVIDIA-ის AI-Q Blueprint ლიდერთა დაფაზე: ღია კოდის AI-ს ტრიუმფი DeepResearch Bench-ზე
NVIDIA-ის AI-Q Blueprint, წამყვანი პორტატული, ღია სიღრმისეული კვლევითი აგენტი, პირველ ადგილზე გავიდა Hugging Face-ის „LLM ძიებით“ ლიდერთა დაფის სათავეში DeepResearch Bench-ზე. ეს მიღწევა ადასტურებს, რომ დეველოპერებისთვის ხელმისაწვდომ მოდელებს შეუძლიათ უზრუნველყონ მოწინავე აგენტური სამუშაო პროცესები, რომლებიც კონკურენციას უწევს ან აღემატება დახურულ ალტერნატივებს გამჭვირვალობისა და კონტროლის შენარჩუნებით. AI-Q აერთიანებს ორ მაღალპროდუქტიულ Llama 3.3 LLM-ს, რაც უზრუნველყოფს გრძელკონტექსტურ ინფორმაც
ღია კოდის ლიცენზიები საკმარისი აღარ არის მანქანური სწავლისთვის: OpenRAIL-ის აღზევება
ბოლო წლებში ხელოვნური ინტელექტის, განსაკუთრებით მანქანური სწავლის (MS) სფეროში მიღწეულმა დიდმა პროგრესმა, რომელიც ნაწილობრივ ღია კოდის კულტურას უკავშირდება, გამოავლინა ტრადიციული ღია კოდის ლიცენზიების შეზღუდვები. ეთიკური და სოციალურ-ეკონომიკური შეშფოთებები მიუთითებს, რომ ღიაობა მარტო საკმარისი არ არის. ვინაიდან MS მოდელები ტექნიკურად განსხვავდება პროგრამული კოდისგან, მათთვის საჭიროა სპეციალიზებული სალიცენზიო მექანიზმები, რომლებიც უზრუნველყოფენ პასუხისმგებლიან გამოყენებას. ამ გამოწვევების საპასუხ

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ

Arm KleidiAI და SDOT: გენერაციული ხელოვნური ინტელექტი მილიარდობით მოწყობილობაზე, მათ შორის ძველ მოდელებზეც
Arm-ის KleidiAI, SDOT CPU ფუნქციის გამოყენებით, გენერაციულ ხელოვნურ ინტელექტს (GenAI) ხელმისაწვდომს ხდის მოწყობილობების ფართო სპექტრზე – უახლესი ფლაგმანური მოდელებიდან დაწყებული, ხუთ წლამდე ძველი სმარტფონებითა და Raspberry Pi 5-ით დამთავრებული. ეს მიიღწევა პოპულარულ AI ფრეიმვორკებში ჩაშენებული ოპტიმიზაციებით და ExecuTorch 0.7 ბეტაში ნაგულისხმევი ჩართვით, რაც უზრუნველყოფს დიდი ენობრივი მოდელების (LLM) ეფექტურ მუშაობას კოდის შეცვლის გარეშე და მნიშვნელოვანი წარმადობის გაუმჯობესებით.
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ

წარმოგიდგენთ kimina-prover-rl-ს: ღია კოდის სასწავლო კონვეიერს Lean 4-ში ფორმალური თეორემების დამტკიცებისთვის
kimina-prover-rl არის ღია კოდის სასწავლო კონვეიერი Lean 4-ში ფორმალური თეორემების დასამტკიცებლად, რომელიც DeepSeek-R1-ის მიერ შთაგონებულ სტრუქტურირებულ მსჯელობა-შემდეგ-გენერაციის პარადიგმას ეფუძნება. ის წარმოადგენს Kimina Prover სისტემის გამარტივებულ ვერსიას, თუმცა ინარჩუნებს ძირითად კომპონენტებს და სრულად თავსებადია Verl ფრეიმვორკთან. მისი მიზანია დიდი ენობრივი მოდელებისთვის (LLMs) ფორმალური დამტკიცების ამოცანების გადაჭრა ასწავლოს, რაც დაგეგმვისა და შესრულების გამიჯვნის ხარჯზე ზრდის ახსნადობას,
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
Spaces Dev Mode: ახალი შესაძლებლობები დეველოპერებისთვის
Spaces Dev Mode დეველოპერებს საშუალებას აძლევს, პირდაპირ დაუკავშირდნენ მათ Space-ს VS Code-ის ან SSH-ის გამოყენებით. ეს ფუნქცია კოდის რედაქტირებას ამარტივებს და ადგილობრივი ცვლილებების Git-ის საშუალებით ატვირთვის საჭიროებას აქრობს. ის ამჟამად ბეტა რეჟიმშია და ხელმისაწვდომია PRO გამომწერებისთვის, რაც მუშაობის პროცესს მნიშვნელოვნად აჩქარებს.

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის