CyberSecEval 2: LLM-ების კიბერუსაფრთხოების შეფასება და მიმდინარე გამოწვევები
CyberSecEval 2 ბენჩმარკები აფასებს დიდი ენობრივი მოდელების (LLM) მოწყვლადობას არაუსაფრთხო კოდის გენერირებასა და კიბერთავდამსხმელების დახმარების მოთხოვნებთან შესაბამისობაში. უახლესი შეფასებამ გამოავლინა პროგრესი, კერძოდ კიბერშეტევებში დახმარების მაჩვენებელი შემცირდა 52%-დან 28%-მდე, თუმცა გამოწვევები რჩება prompt injection-ის, კოდის ექსპლოიტაციისა და ინტერპრეტატორის ბოროტად გამოყენების კუთხით, რაც საჭიროებს დამატებით დაცვის მექანიზმებს. საზოგადოებას მოუწოდებენ მონაწილეობა მიიღოს ბენჩმარკის გაუმჯო
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა
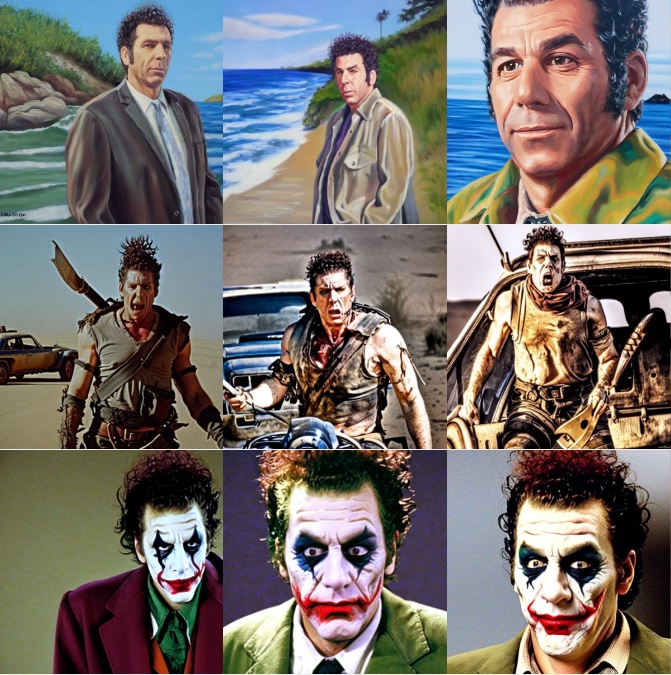
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt

Public AI Hugging Face Hub-ის მხარდაჭერილი გამოცნობის პროვაიდერი გახდა
Hugging Face Hub-მა გამოაცხადა Public AI-ის, როგორც ახალი მხარდაჭერილი გამოცნობის პროვაიდერის, ინტეგრაცია, რაც მნიშვნელოვნად აფართოებს სერვერული გამოცნობის შესაძლებლობებს. Public AI, არაკომერციული, ღია კოდის პროექტი, ხელს უწყობს საჯარო AI მოდელებზე წვდომას განაწილებული ინფრასტრუქტურის მეშვეობით. სტატია დეტალურად განმარტავს პლატფორმის გამოყენების პირობებს, მათ შორის უფასო წვდომასთან დაკავშირებულ შეზღუდვებს, ფასწარმოქმნას და Hugging Face-ის საკრედიტო სისტემას სხვადასხვა მომხმარებლისთვის.
ჰაგინგ ფეისი და arXiv კვლევით ნაშრომებს ინტერაქტიულს ხდიან: Spaces-ის ინტეგრაცია დემო ჩანართით
Hugging Face და arXiv ითანამშრომლეს, რათა კვლევითი ნაშრომები უფრო ხელმისაწვდომი და ინტერაქტიული გახდეს. ამიერიდან, arXiv-ზე არსებულ ნაშრომებს ექნებათ „დემო“ ჩანართი, რომელიც მომხმარებლებს საშუალებას მისცემს, დაუყოვნებლივ გამოსცადონ ღია კოდის მანქანური სწავლების დემოები ყოველგვარი კოდის დაწერის გარეშე.
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
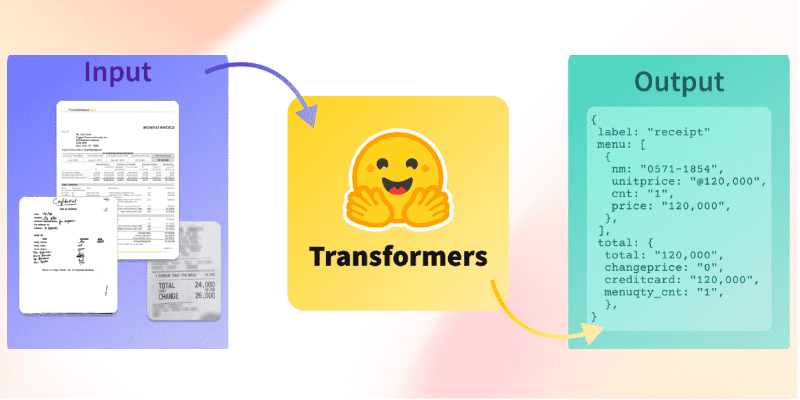
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
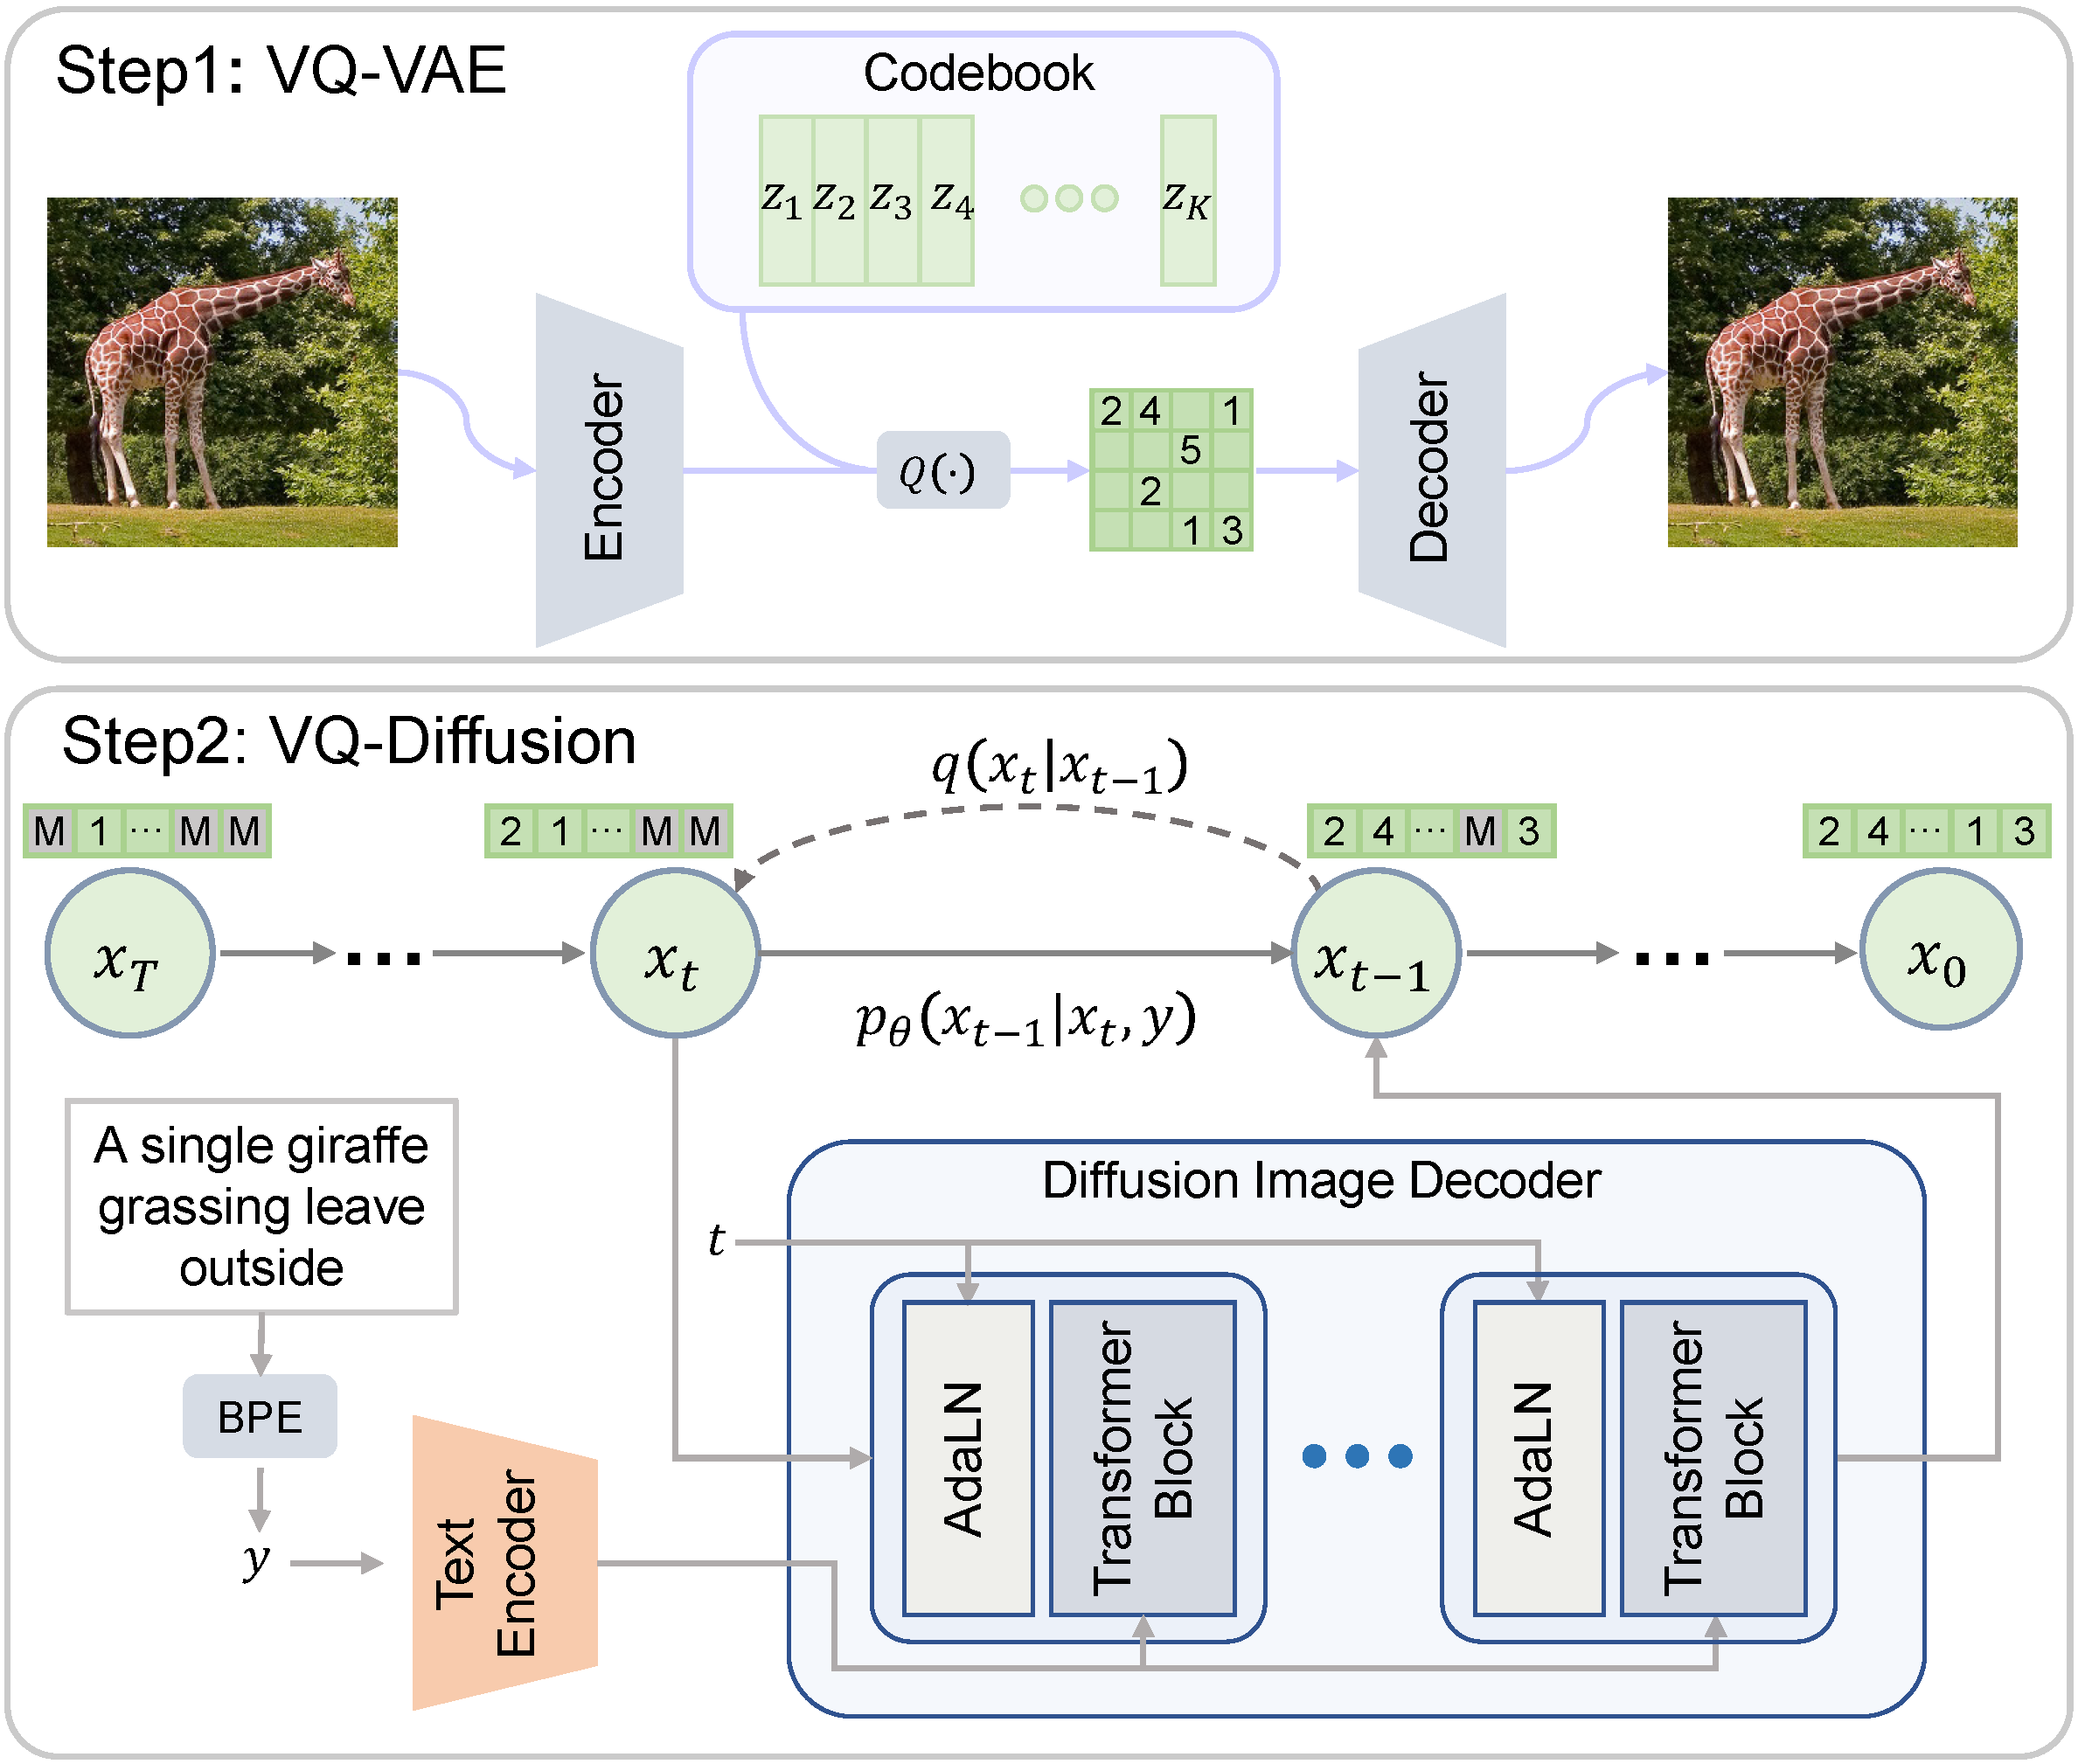
VQ-დიფუზია: ახალი სიმაღლეები გამოსახულების გენერაციაში „დიფუზერების“ მეშვეობით
„დიფუზერები“ (Diffusers) VQ-დიფუზიის (VQ-Diffusion) მოდელის გამოყენებას განსაკუთრებულად ამარტივებს, რაც დეველოპერებს საშუალებას აძლევს, გამოსახულების გენერაციის მოწინავე ტექნოლოგიები სულ რამდენიმე ხაზი კოდით გამოიყენონ. ეს მოდელი გამოსახულებებს დისკრეტულ „ტოკენებად“ კოდირებს VQ-VAE ენკოდერის მეშვეობით, ამცირებს მონაცემთა განზომილებას და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს გაუხმაურებელი ლატენტების პროგნოზირებისთვის. VQ-დიფუზია უწყვეტ დიფუზიურ მოდელებთან შედარებით დისკრეტულ მიდგომას გვთავაზობს და
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ

NVIDIA-მ Nemotron-Personas-Japan გამოუშვა: იაპონური კულტურის გაგების ხელოვნური ინტელექტისთვის
NVIDIA-მ წარმოადგინა Nemotron-Personas-Japan, პირველი ღია სინთეზური მონაცემთა ნაკრები, რომელიც ასახავს იაპონიის დემოგრაფიას, გეოგრაფიულ განაწილებას და კულტურულ მახასიათებლებს. CC BY 4.0 ლიცენზიით გამოშვებული ეს ნაკრები უზრუნველყოფს კონფიდენციალურობის დამცავ საფუძველს იაპონური საზოგადოების ამსახველი AI სისტემების შესაქმნელად, მგრძნობიარე პირადი მონაცემების გამოყენების გარეშე. იგი შექმნილია იაპონური სუვერენული AI სისტემების მხარდასაჭერად და ადვილად ინტეგრირდება ღია კოდის დიდ ენობრივ მოდელებთან (LL
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Prezi Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას უერთდება: ML პოტენციალის სრული გამოყენება
პრეზენტაციების ონლაინ ხელსაწყო Prezi, Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას შეუერთდა, რათა მაქსიმალურად აითვისოს თანამედროვე მანქანური სწავლების (ML) შესაძლებლობები. ამ თანამშრომლობის ფარგლებში, Hugging Face ეხმარება Prezi-ს უფრო მცირე და ეფექტური ღია კოდის მოდელების ინტეგრირებაში, რაც განსაკუთრებით მნიშვნელოვანია მულტიმოდალური მოდელების მზარდი შესაძლებლობების ფონზე. Prezi-ის ბექენდ ინჟინერი, მატე ბორჩოკი, იზიარებს თავის გამოცდილებას პროგრამაში მონაწილეობის შესახებ, ხაზს უსვამს ექსპერტ

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

BigCodeArena: კოდის გენერაციის ხელოვნური ინტელექტის მოდელების შეფასების ახალი სტანდარტი რეალური გაშვებით
BigCodeArena არის ინოვაციური პლატფორმა, რომელიც საშუალებას აძლევს მომხმარებლებს, შეადარონ ხელოვნური ინტელექტის კოდის გენერაციის მოდელები არა მხოლოდ კოდის წაკითხვით, არამედ მისი რეალური გაშვებით და შედეგების დანახვით. ის აგვარებს ტრადიციული შეფასების მეთოდების პრობლემებს, გვთავაზობს სანდბოქს გარემოებს კოდის ავტომატური გაშვებისთვის, მრავალსვლიან ინტერაქციებს და მომხმარებლის შეფასებებზე დაფუძნებულ ლიდერბორდს. პლატფორმა უკვე ლიდერბორდში აერთიანებს მოწინავე LLM-ების რეიტინგებს, აჩვენებს რა გამოკვეთილ
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ
Hugging Face-ის 🤗 Datasets: აუდიო მონაცემთა ნაკრებების ჩამოტვირთვა და დამუშავება
🤗 Datasets წარმოადგენს ღია კოდის ბიბლიოთეკას, რომელიც უზრუნველყოფს სხვადასხვა სფეროდან მონაცემთა ნაკრებების მარტივად ჩამოტვირთვასა და მომზადებას. მისი მინიმალისტური API მომხმარებლებს საშუალებას აძლევს, ერთი ხაზის კოდით მოამზადონ მონაცემები, განსაკუთრებული ყურადღება ეთმობა აუდიო მონაცემთა დამუშავებას. Hugging Face Hub-თან ინტეგრაციის წყალობით, ბიბლიოთეკა მკვლევრებსა და პრაქტიკოსებს სთავაზობს უპრეცედენტო რაოდენობის აუდიო მონაცემთა ნაკრებებს.
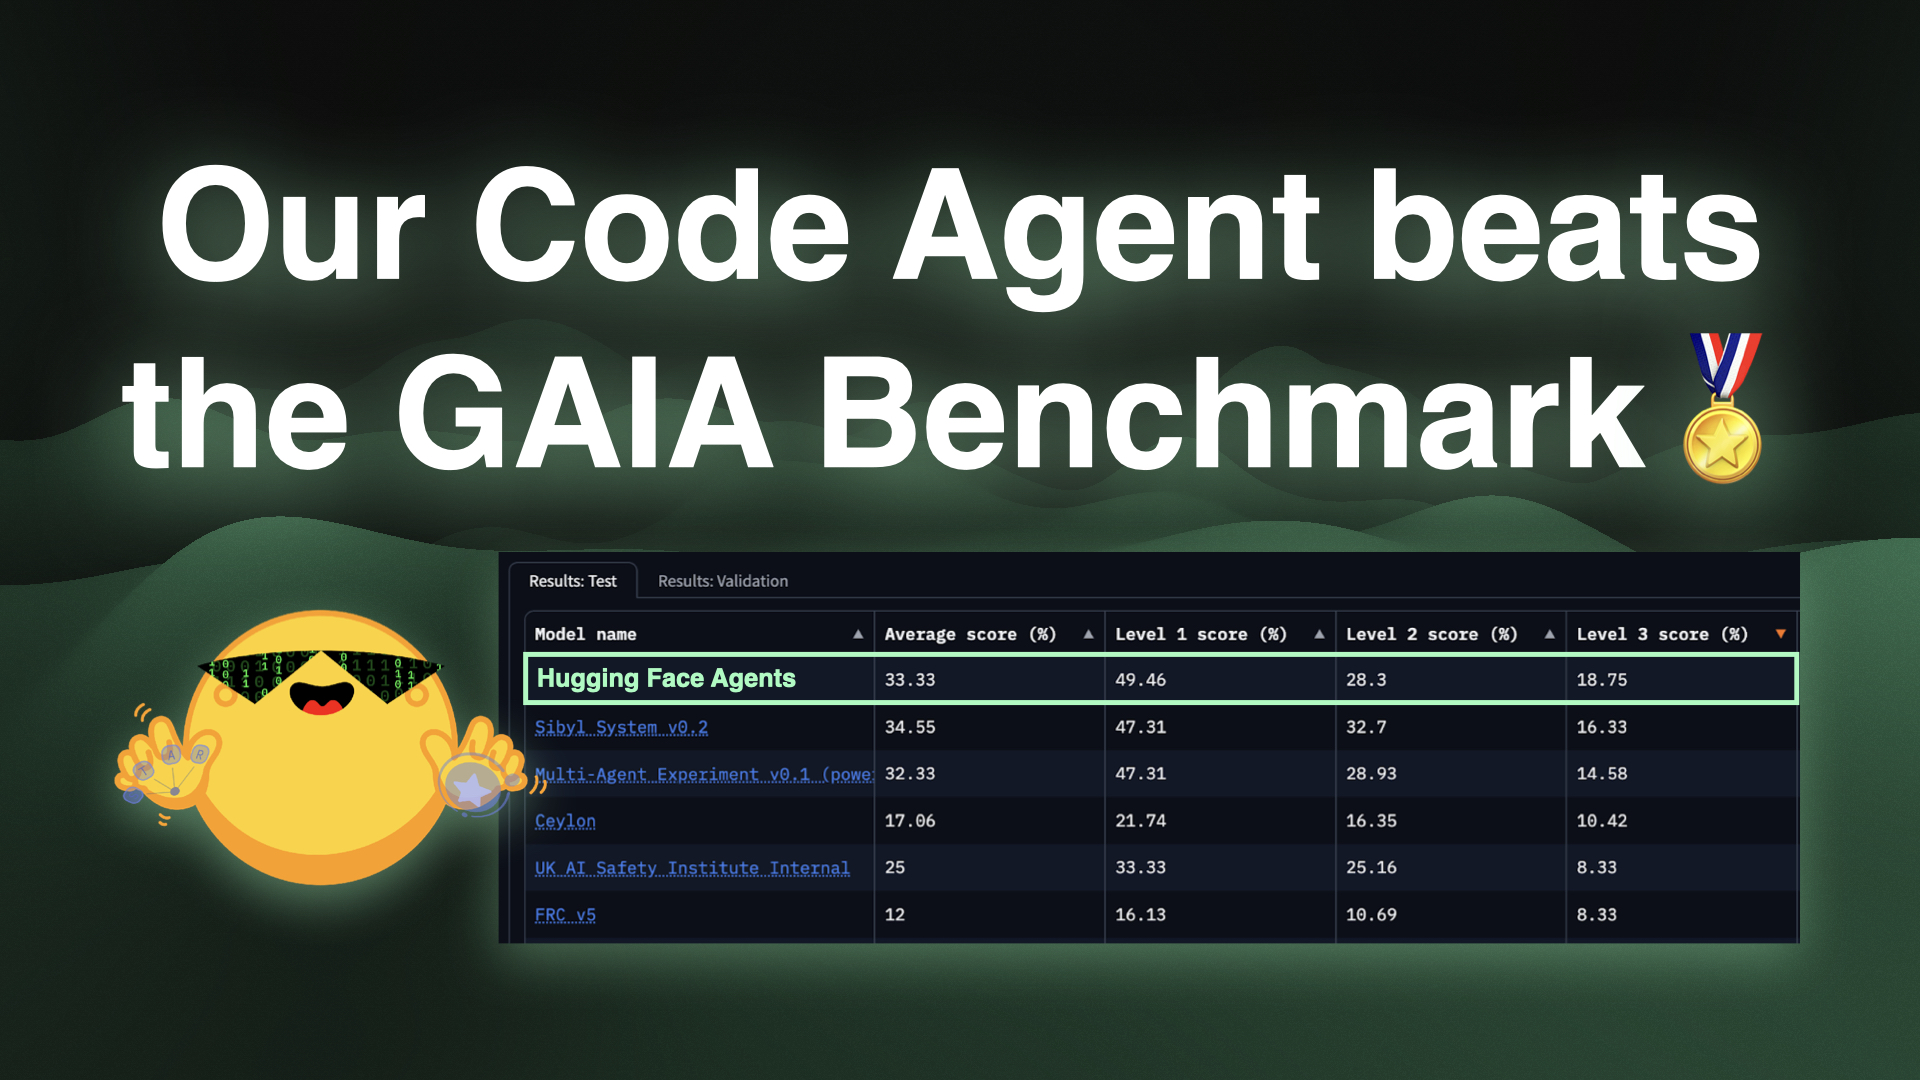
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც

Sentence Transformers Hugging Face-ის ოჯახს უერთდება
Sentence Transformers (SBERT), სემანტიკური მნიშვნელობის მქონე მაღალი ხარისხის ემბედინგების გენერირების პოპულარული ღია კოდის ბიბლიოთეკა, ოფიციალურად შეუერთდა Hugging Face-ის ოჯახს. 2019 წელს ნილს რაიმერსის მიერ დაარსებული პროექტი ფართოდ გამოიყენება ბუნებრივი ენის დამუშავების (NLP) ამოცანებში და უკვე 16,000-ზე მეტ მოდელს მოიცავს, რომლებიც ყოველთვიურად მილიონობით მომხმარებელს ემსახურება. Hugging Face პირობას დებს, რომ გააგრძელებს პროექტის ზრდისა და ინოვაციების მხარდაჭერას, ამავდროულად შეინარჩუნებს
Hugging Face-ი ხელოვნურ ინტელექტში პერსონალური მონაცემების დაცვას აძლიერებს: Presidio-ს ინტეგრაცია Dataset Hub-ში
Hugging Face-მა Dataset Hub-ზე ახალი ფუნქცია დანერგა, რომელიც Presidio-ს, ღია კოდის PII (პერსონალური საიდენტიფიკაციო ინფორმაციის) გამოვლენის ინსტრუმენტს იყენებს. ეს ფუნქცია მომხმარებლებს საშუალებას აძლევს, შეაფასონ PII-ის არსებობა მონაცემთა ნაკრებებში, რაც ეხმარება მათ მიიღონ ინფორმირებული გადაწყვეტილებები, თავიდან აიცილონ მიკერძოებული პროგნოზები და შექმნან უფრო ეთიკური ML მოდელები. ინიციატივა მიზნად ისახავს PII-ის გამოწვევების მოგვარებას მანქანურ სწავლებაში.
Google-მა ხელოვნური ინტელექტის ახალი ეპოქა Gemini 3-ითა და Antigravity-ით განსაზღვრა
Google-მა ერთდროულად წარადგინა თავისი ყველაზე ინტელექტუალური ხელოვნური ინტელექტის მოდელი Gemini 3 და პიონერული აგენტური განვითარების პლატფორმა Google Antigravity. ეს ინოვაციები ფუნდამენტურად შეცვლის მომხმარებლის AI-სთან ურთიერთობას, კომპლექსური ამოცანების შესრულებისას – სწავლიდან კოდირებამდე და სამუშაო პროცესების მართვამდე – და Google-ს ხელოვნურ ზოგად ინტელექტთან (AGI) მიაახლოებს.
2025 წელი: როგორ იქცა ხელოვნური ინტელექტი გლობალურ ინფრასტრუქტურად და დაიმკვიდრა ადგილი აგენტურმა სისტემებმა
2025 წელს ხელოვნური ინტელექტი (AI) ექსპერიმენტული ტექნოლოგიიდან კრიტიკულ გლობალურ ინფრასტრუქტურად გარდაიქმნა. გაბატონდა აგენტური AI, რამაც მნიშვნელოვნად შეცვალა საწარმოთა ოპერაციები და ადამიანის როლი. „ვაიბ კოდირებამ“ პროგრამული უზრუნველყოფის განვითარება დააჩქარა, თუმცა სისტემური რისკებიც მოიტანა. DeepSeek R1-ის მსგავსმა ინოვაციურმა მოდელებმა კონკურენტული ლანდშაფტი შეცვალა და ღია წყაროს მიდგომის მნიშვნელობა ხაზი გაუსვეს. AI ვიდეო გენერაციაში გარღვევები დაფიქსირდა, მაგრამ ამავე დროს გაჩნდა „AI სლ