
ხელოვნური ინტელექტის კოდირების ხელსაწყოები: დაპირება და რეალობა არაპროგრამისტის თვალით
გენერაციული ხელოვნური ინტელექტის კოდირების ხელსაწყოები, როგორიცაა Cursor და Replit, მნიშვნელოვან წარმატებას აღწევს საწარმოებში, რადგანაც მათ შეუძლიათ პროგრამისტების შრომა მნიშვნელოვნად შეამცირონ. ამ სტატიაში ავტორი, რომელსაც პროგრამირების მცირე ცოდნა აქვს, ცდილობს შექმნას აპლიკაცია ამ ხელსაწყოების გამოყენებით. ის აღწერს როგორც დადებით მხარეებს – ავტომატურ დავალებებსა და ბუნებრივი ენის გამოყენებით მუშაობას – ასევე გამოწვევებს, როგორიცაა ბრძანების ხაზთან მუშაობის აუცილებლობა, ღრუბლოვანი სერვისების
ევროკავშირის AI აქტი: რა უნდა იცოდნენ ღია კოდის AI სისტემების შემქმნელებმა
ევროკავშირის ხელოვნური ინტელექტის აქტი (AI Act) შესაძლოა გავრცელდეს ღია კოდის AI სისტემებსა და მოდელებზე, სპეციფიკური წესებით, რომლებიც დამოკიდებულია მოდელის ტიპსა და მის გამოშვებაზე. უმეტეს შემთხვევაში, ვალდებულებები მოიცავს მკაფიო დოკუმენტაციის მიწოდებას, მოდელის შესახებ ინფორმაციის გასამჟღავნებლად ხელსაწყოების დამატებას განთავსებისას და არსებული საავტორო უფლებებისა და კონფიდენციალურობის წესების დაცვას. საბედნიეროდ, ამ პრაქტიკის უმეტესობა უკვე გავრცელებულია ღია კოდის სივრცეში, და Hugging Face
Hugging Face Hub: მანქანური სწავლების შესაძლებლობები GLAM სექტორისთვის
Hugging Face მიზნად ისახავს უმაღლესი ხარისხის მანქანური სწავლების საყოველთაო ხელმისაწვდომობას. ამის მისაღწევად კომპანია აწვდის ღია კოდის ბიბლიოთეკებს, უფასო კურსებს და Hugging Face Hub-ს – ცენტრალურ საცავს 190,000-ზე მეტი მოდელით, 33,000 მონაცემთა ნაკრებით და 100,000-ზე მეტი აპლიკაციით. ეს სტატია განკუთვნილია GLAM სექტორში (გალერეები, ბიბლიოთეკები, არქივები, მუზეუმები) მომუშავე პირებისთვის, რათა გაიგონ, როგორ გამოიყენონ და როგორ შეიტანონ წვლილი Hub-ში. მაგალითად, NER მოდელის გამოყენება ციფრული დ
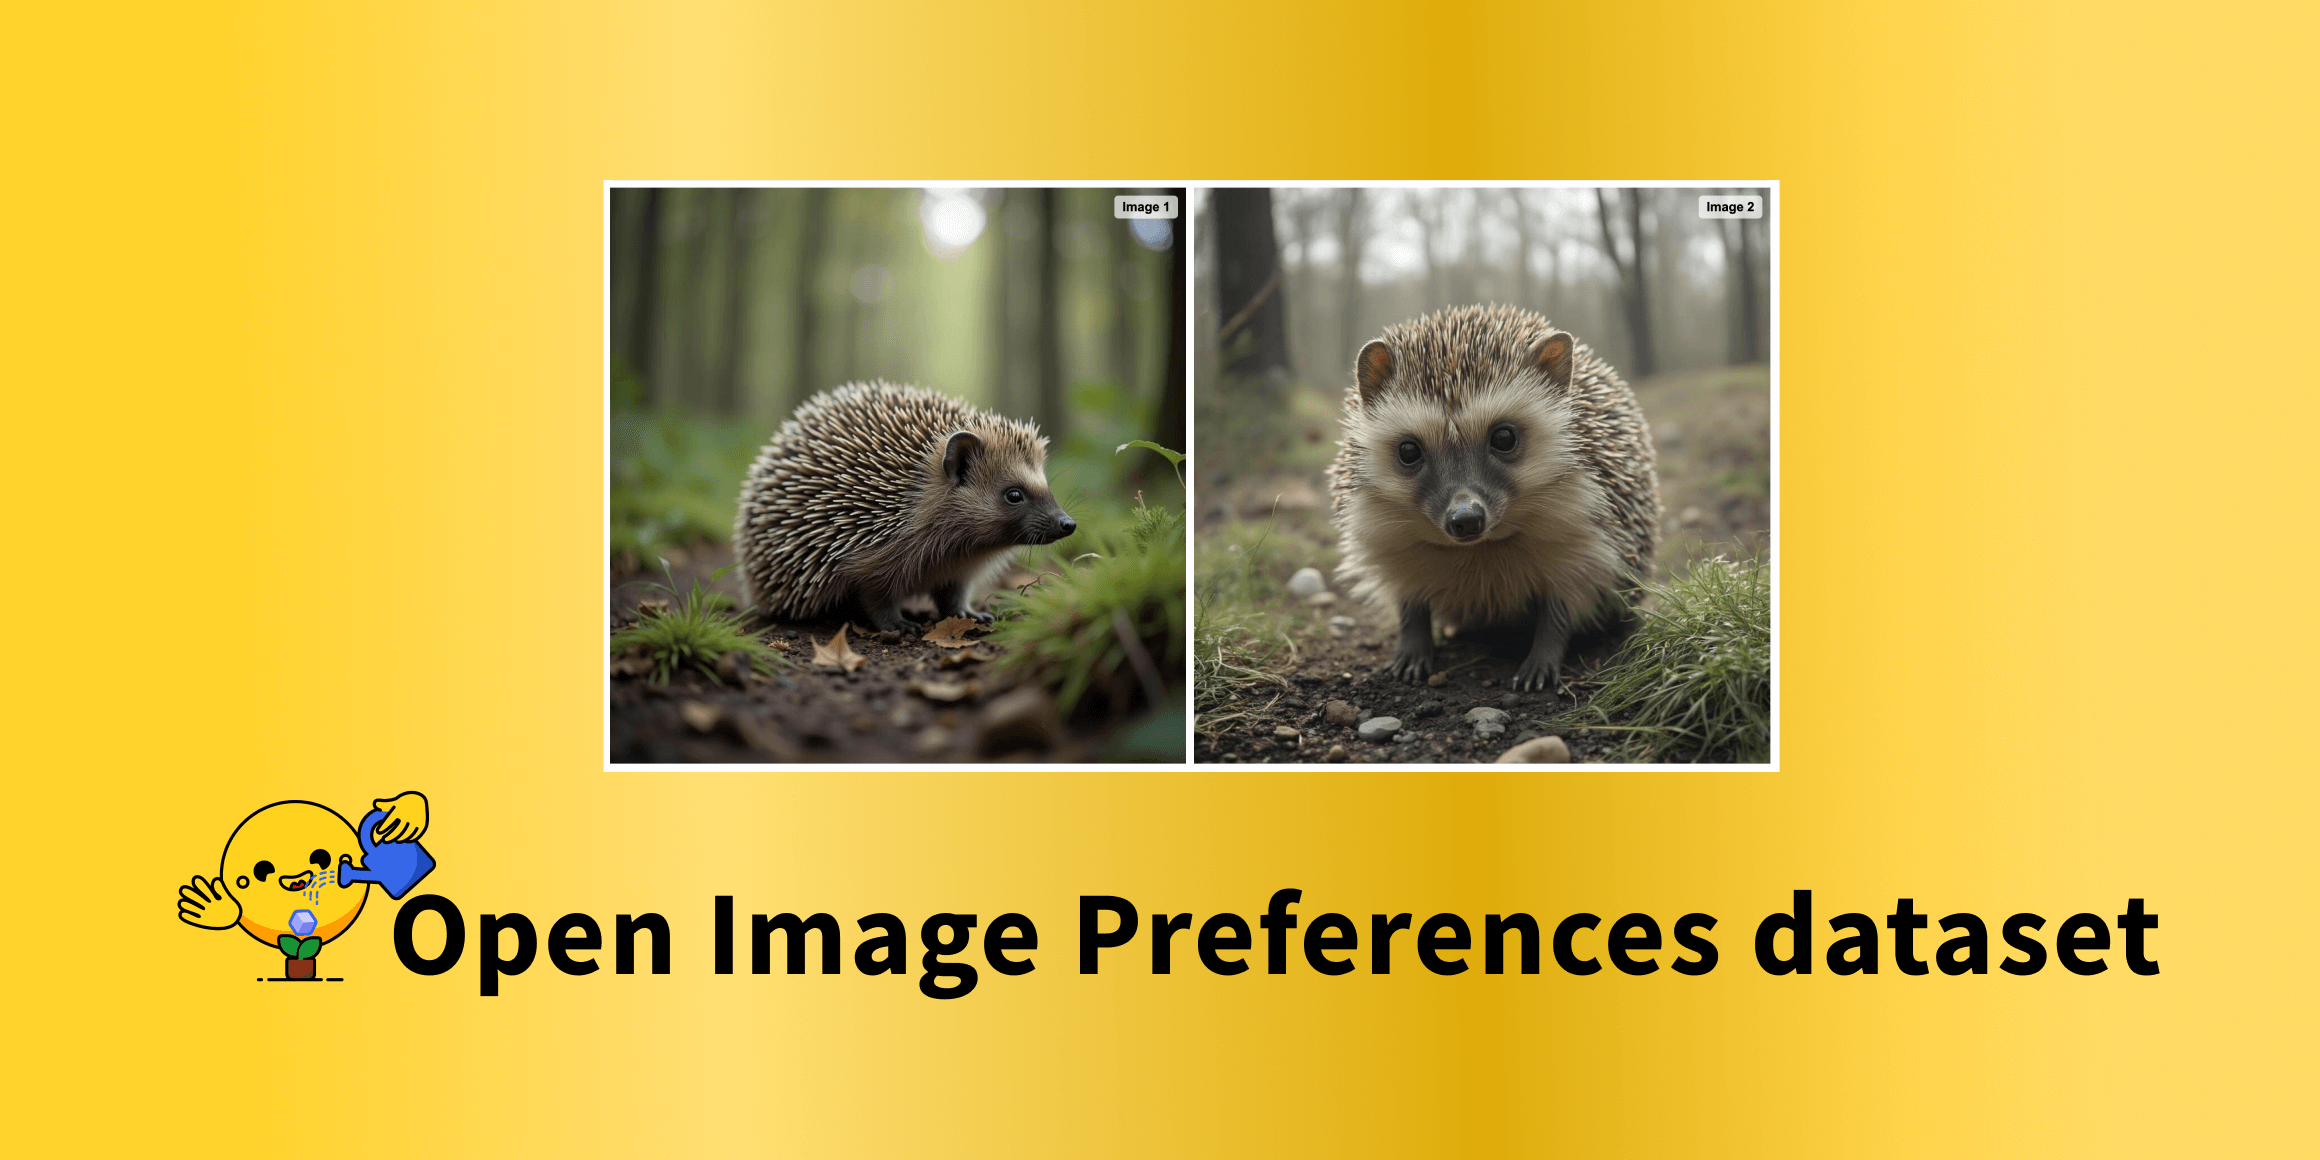
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
Writer-ის გზა: Hugging Face-ის მომხმარებლიდან ღია კოდის კონტრიბუტორამდე
ამ ინტერვიუში Writer-ის თანადამფუძნებელი და ტექნიკური დირექტორი, ვასიმ ალშიხი, საუბრობს Hugging Face-თან მათი თანამშრომლობის ევოლუციაზე, დაწყებული უბრალო მომხმარებლობიდან, დამთავრებული ღია კოდის მოდელების შექმნამდე.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L
AI WebTV: ხელოვნური ინტელექტით შექმნილი ვიდეო კონტენტის ინოვაციური პლატფორმა
AI WebTV წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დემონსტრირებს ღია კოდის ტექსტი-ვიდეოდ გადამყვანი მოდელებით, როგორიცაა Zeroscope და MusicGen, გენერირებულ ვიდეოებს. ის შექმნილია მოკლე, ტექნოლოგიური დემო კლიპების სახით, სადაც დიდი ენობრივი მოდელები (LLM), მაგალითად ChatGPT, გამოიყენება ვიდეო კადრებისთვის მრავალფეროვანი მოთხოვნების შესაქმნელად. სისტემა დანერგილია NodeJS-სა და TypeScript-ში, იყენებს Hugging Face-ის სერვისებს და მოიცავს კადრების გაფართოებას FILM ალგორითმით, ასევე მუსიკის დამატებას
ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო
ღია კოდის AI თამაშების ჯემი: გამარჯვებული და გამორჩეული ნამუშევრები
ღია კოდის ხელოვნური ინტელექტის თამაშების ჯემმა, რომლის მიზანიც იყო ღია კოდის AI ინსტრუმენტების თამაშებში ინტეგრირება, მოლოდინს გადააჭარბა 1300-ზე მეტი რეგისტრაციითა და 88 თამაშის წარდგენით. თემამ „გაფართოება“ ხელი შეუწყო მრავალფეროვან შემოქმედებას. თანატოლთა შეფასებისა და ჟიურის მსჯელობის შემდეგ, „Snip It“ (ohmlet-ის მიერ) დასახელდა გამარჯვებულად, რომელმაც წარმოაჩინა ინოვაციური, ხელოვნური ინტელექტის მიერ გენერირებული გეიმპლეი.
HfAgent: ხელოვნური ინტელექტის ინტეგრაცია მარტივად და უსაფრთხოდ
HfAgent ბიბლიოთეკა, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს ადვილად აერთიანებს თქვენს პროექტებში, გთავაზობთ მარტივ ინსტალაციასა და გამოყენებას. ის საშუალებას გაძლევთ შეასრულოთ ტექსტური ბრძანებები, წარმოქმნათ და შეაფასოთ კოდი. სტატია ასევე ყურადღებას ამახვილებს უსაფრთხოების რისკებზე თვითნებური კოდის შესრულებისას, გვირჩევს უსაფრთხო მეთოდებს და განმარტავს LLM-ისა და ხელსაწყოების მორგების ვარიანტებს, მათ შორის ფაილების შეყვანის შესაძლებლობას.
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ

ხელოვნური ინტელექტი და ხელოვნება: 2024 წლის საკვანძო მიღწევების მიმოხილვა და 2025 წლის მოლოდინები
ბოლო რამდენიმე წელი გადამწყვეტი აღმოჩნდა ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნების სფეროში. შემოქმედებითი გამოხატვისთვის განკუთვნილი ხელოვნური ინტელექტის ხელსაწყოები არასოდეს ყოფილა ასეთი ხელმისაწვდომი, და ეს მხოლოდ დასაწყისია. ეს სტატია მიმოიხილავს 2024 წლის ძირითად მიღწევებს ხელოვნური ინტელექტის მიერ გენერირებულ გამოსახულებებში, მათ შორის DiT არქიტექტურის, პერსონალიზაციისა და „ზერო-შოთ“ ტექნიკების წინსვლას. ხაზგასმულია, თუ როგორ ეჯიბრებიან ღია კოდის მოდელები დახურული კოდის გიგანტებ
ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ