Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
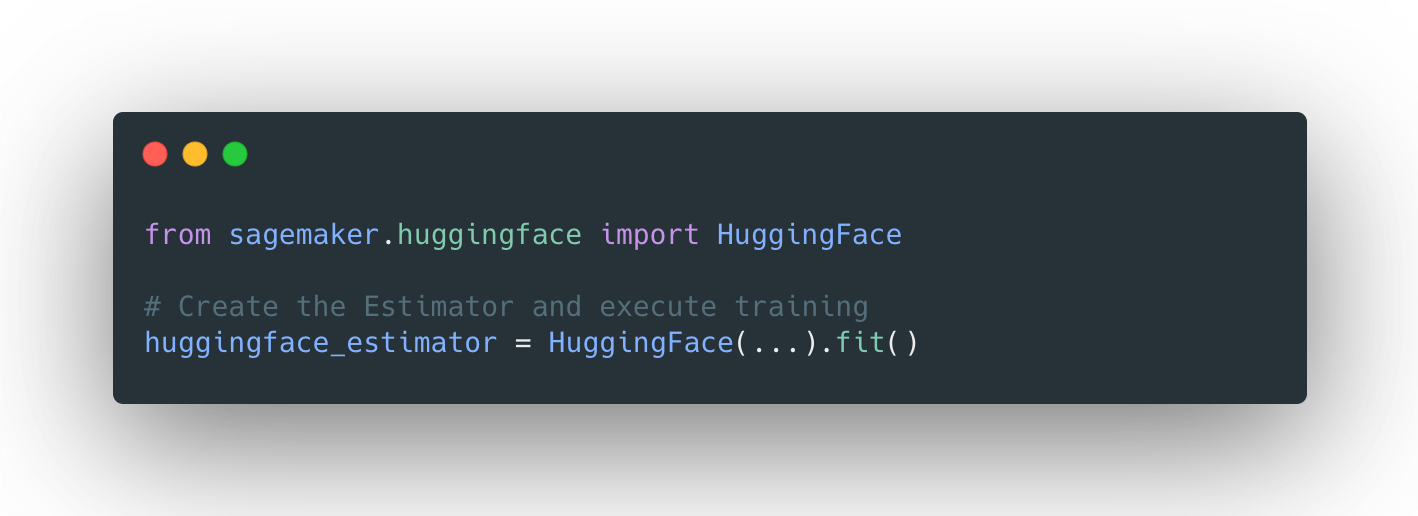
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
AWS SageMaker-ისა და Hugging Face-ის ინტეგრაცია: Transformer-ზე დაფუძნებული მოდელების ოპტიმიზებული ტრენინგი
AWS SageMaker-ისა და Hugging Face-ის გუნდებმა ერთობლივად შექმნეს ოპტიმიზებული ღრმა სწავლის კონტეინერები (DLCs) Transformer-ზე დაფუძნებული მოდელების ტრენინგის დასაჩქარებლად. ახალი HuggingFace estimator-ის SageMaker Python SDK-ში ინტეგრაციის წყალობით, მომხმარებლებს შეუძლიათ ტრენინგის დაწყება კოდის მხოლოდ ერთი ხაზით. სტატია დეტალურად აღწერს ამ ინტეგრაციას, მოიცავს განაწილებული Seq2Seq-transformer მოდელის გაწვრთნის პროცესს შეჯამების ამოცანისთვის და განხილულია მოდელის ატვირთვისა და ტესტირების ნაბიჯებ
Hugging Face-ის ეკოსისტემაში Code Llama-ს ინტეგრაცია გამოცხადდა: პროგრამირების ახალი ეპოქა
Code Llama, Llama 2-ის საფუძველზე შექმნილი კოდზე სპეციალიზებული ხელოვნური ინტელექტის მოდელების ოჯახი, Hugging Face-ის ეკოსისტემაში ინტეგრირდა. ის პროგრამისტების პროდუქტიულობის გაზრდას ისახავს მიზნად კოდის შევსებით, დოკუმენტაციის გენერირებით და ერთეული ტესტების შექმნით. მოდელები ხელმისაწვდომია 7B, 13B და 34B პარამეტრის ვარიანტებში, მათ შორის Python-ის სპეციალისტი და ინსტრუქციებზე მორგებული ვერსიები, და მხარს უჭერენ 100,000-მდე ტოკენის კონტექსტურ ფანჯარას.
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
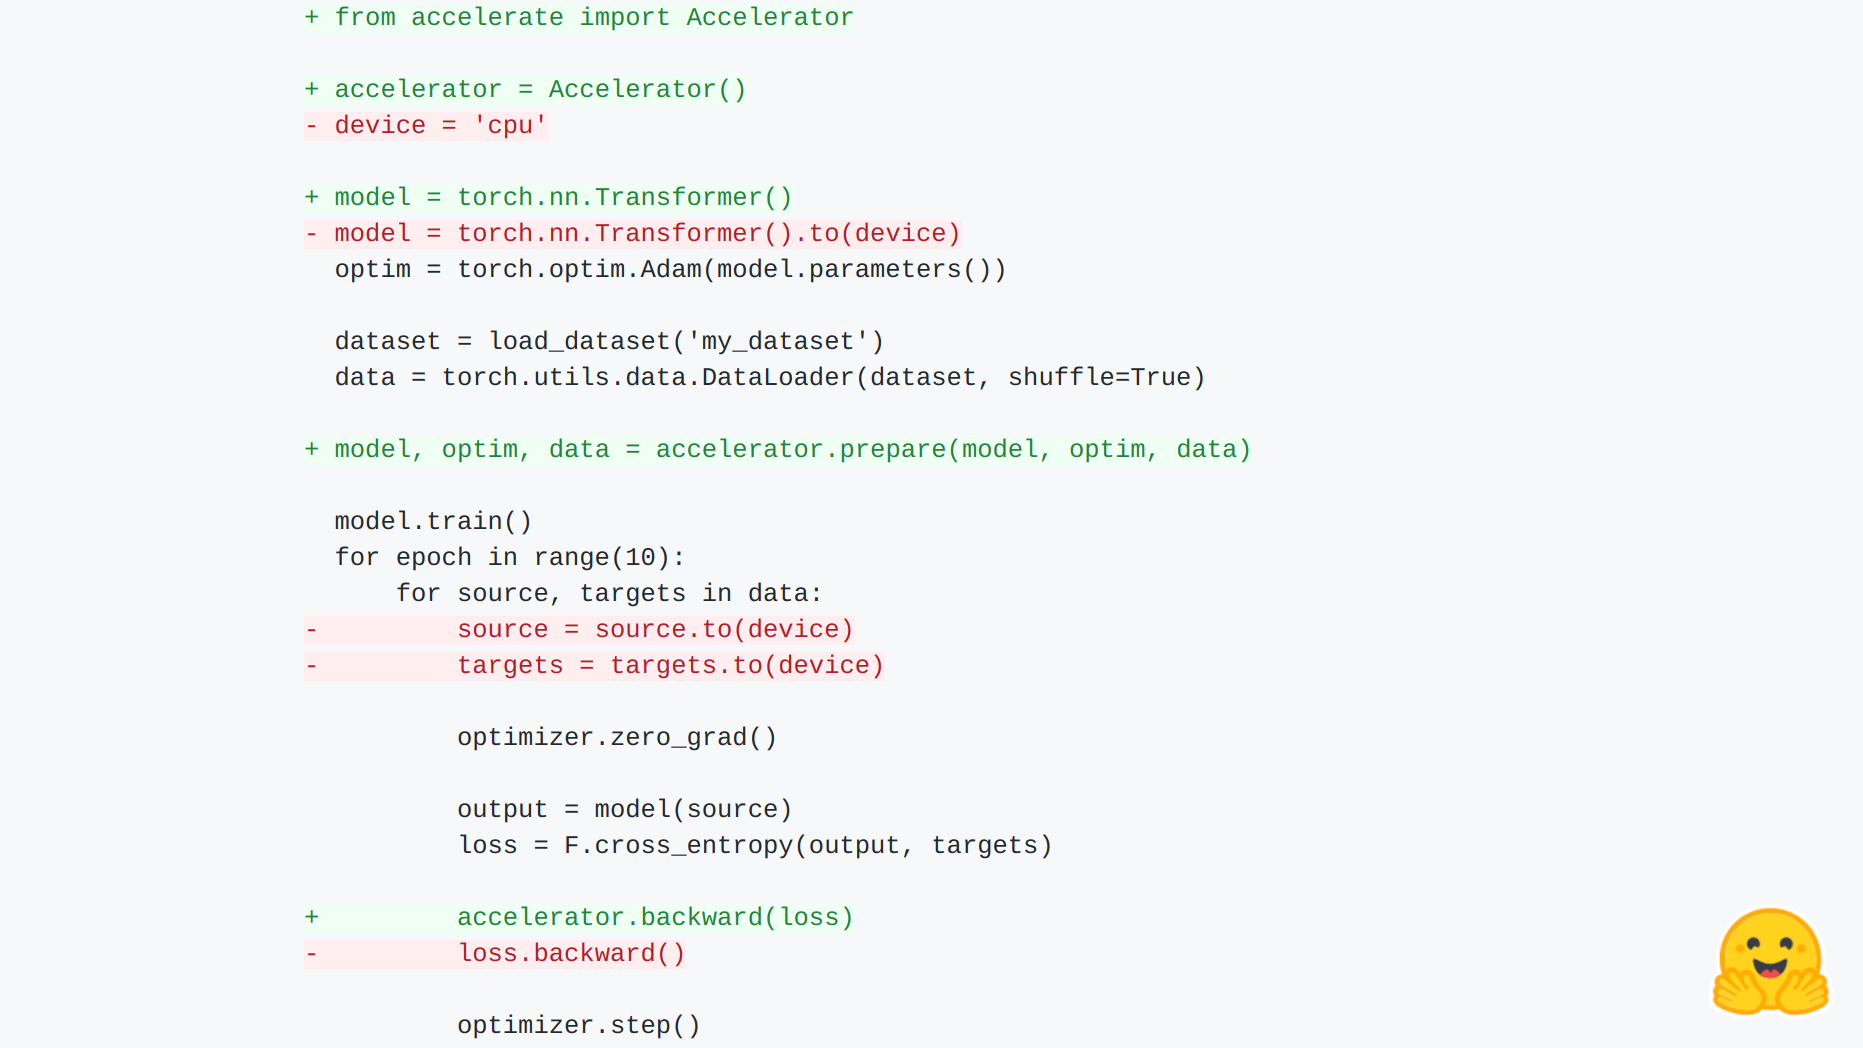
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ
Gradio 2.0: Hugging Face-ის მოდელების გამოყენება გრაფიკული ინტერფეისით კოდის მხოლოდ 1 ხაზში
Hugging Face-ის მოდელების ცენტრში ათასობით მანქანური სწავლების მოდელია ხელმისაწვდომი. Gradio-ს ბიბლიოთეკა დეველოპერებს უკვე აძლევდა საშუალებას, მარტივად შეექმნათ დემოები. ახლა, Gradio 2.0-ით, Hugging Face-ის თითქმის ნებისმიერი მოდელის ჩატვირთვა და გრაფიკული ინტერფეისით (GUI) გამოყენება კოდის მხოლოდ 1 ხაზშია შესაძლებელი. ეს სიახლე მნიშვნელოვნად ამარტივებს ხელოვნური ინტელექტის მოდელების ხელმისაწვდომობას როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის და ხსნის ახალ შესაძლებლობებს კომპლექსური
Hugging Face-ის SafeCoder: ღია კოდის კოდის ასისტენტი საწარმოებისთვის — სრული კონტროლი და კონფიდენციალურობა
პროგრამული უზრუნველყოფის შეცდომების გამოსწორების მაღალი ღირებულება ხაზს უსვამს ხარისხიანი კოდის მნიშვნელობას. ხელოვნური ინტელექტი გვთავაზობს კოდის გენერაციის პერსპექტიულ გზებს, მაგრამ დახურული კოდის სერვისებს აკლია მორგებადობა და გამჭვირვალობა. Hugging Face-მა წარმოადგინა SafeCoder — ღია კოდის კოდის ასისტენტი საწარმოებისთვის, რომელიც აგებულია StarCoder მოდელებზე. ის უზრუნველყოფს უახლეს მოდელებს, გამჭვირვალობას, სრულ მორგებადობას, IT მოქნილობას და უმაღლეს კონფიდენციალურობას, რაც საშუალებას აძლევს
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging
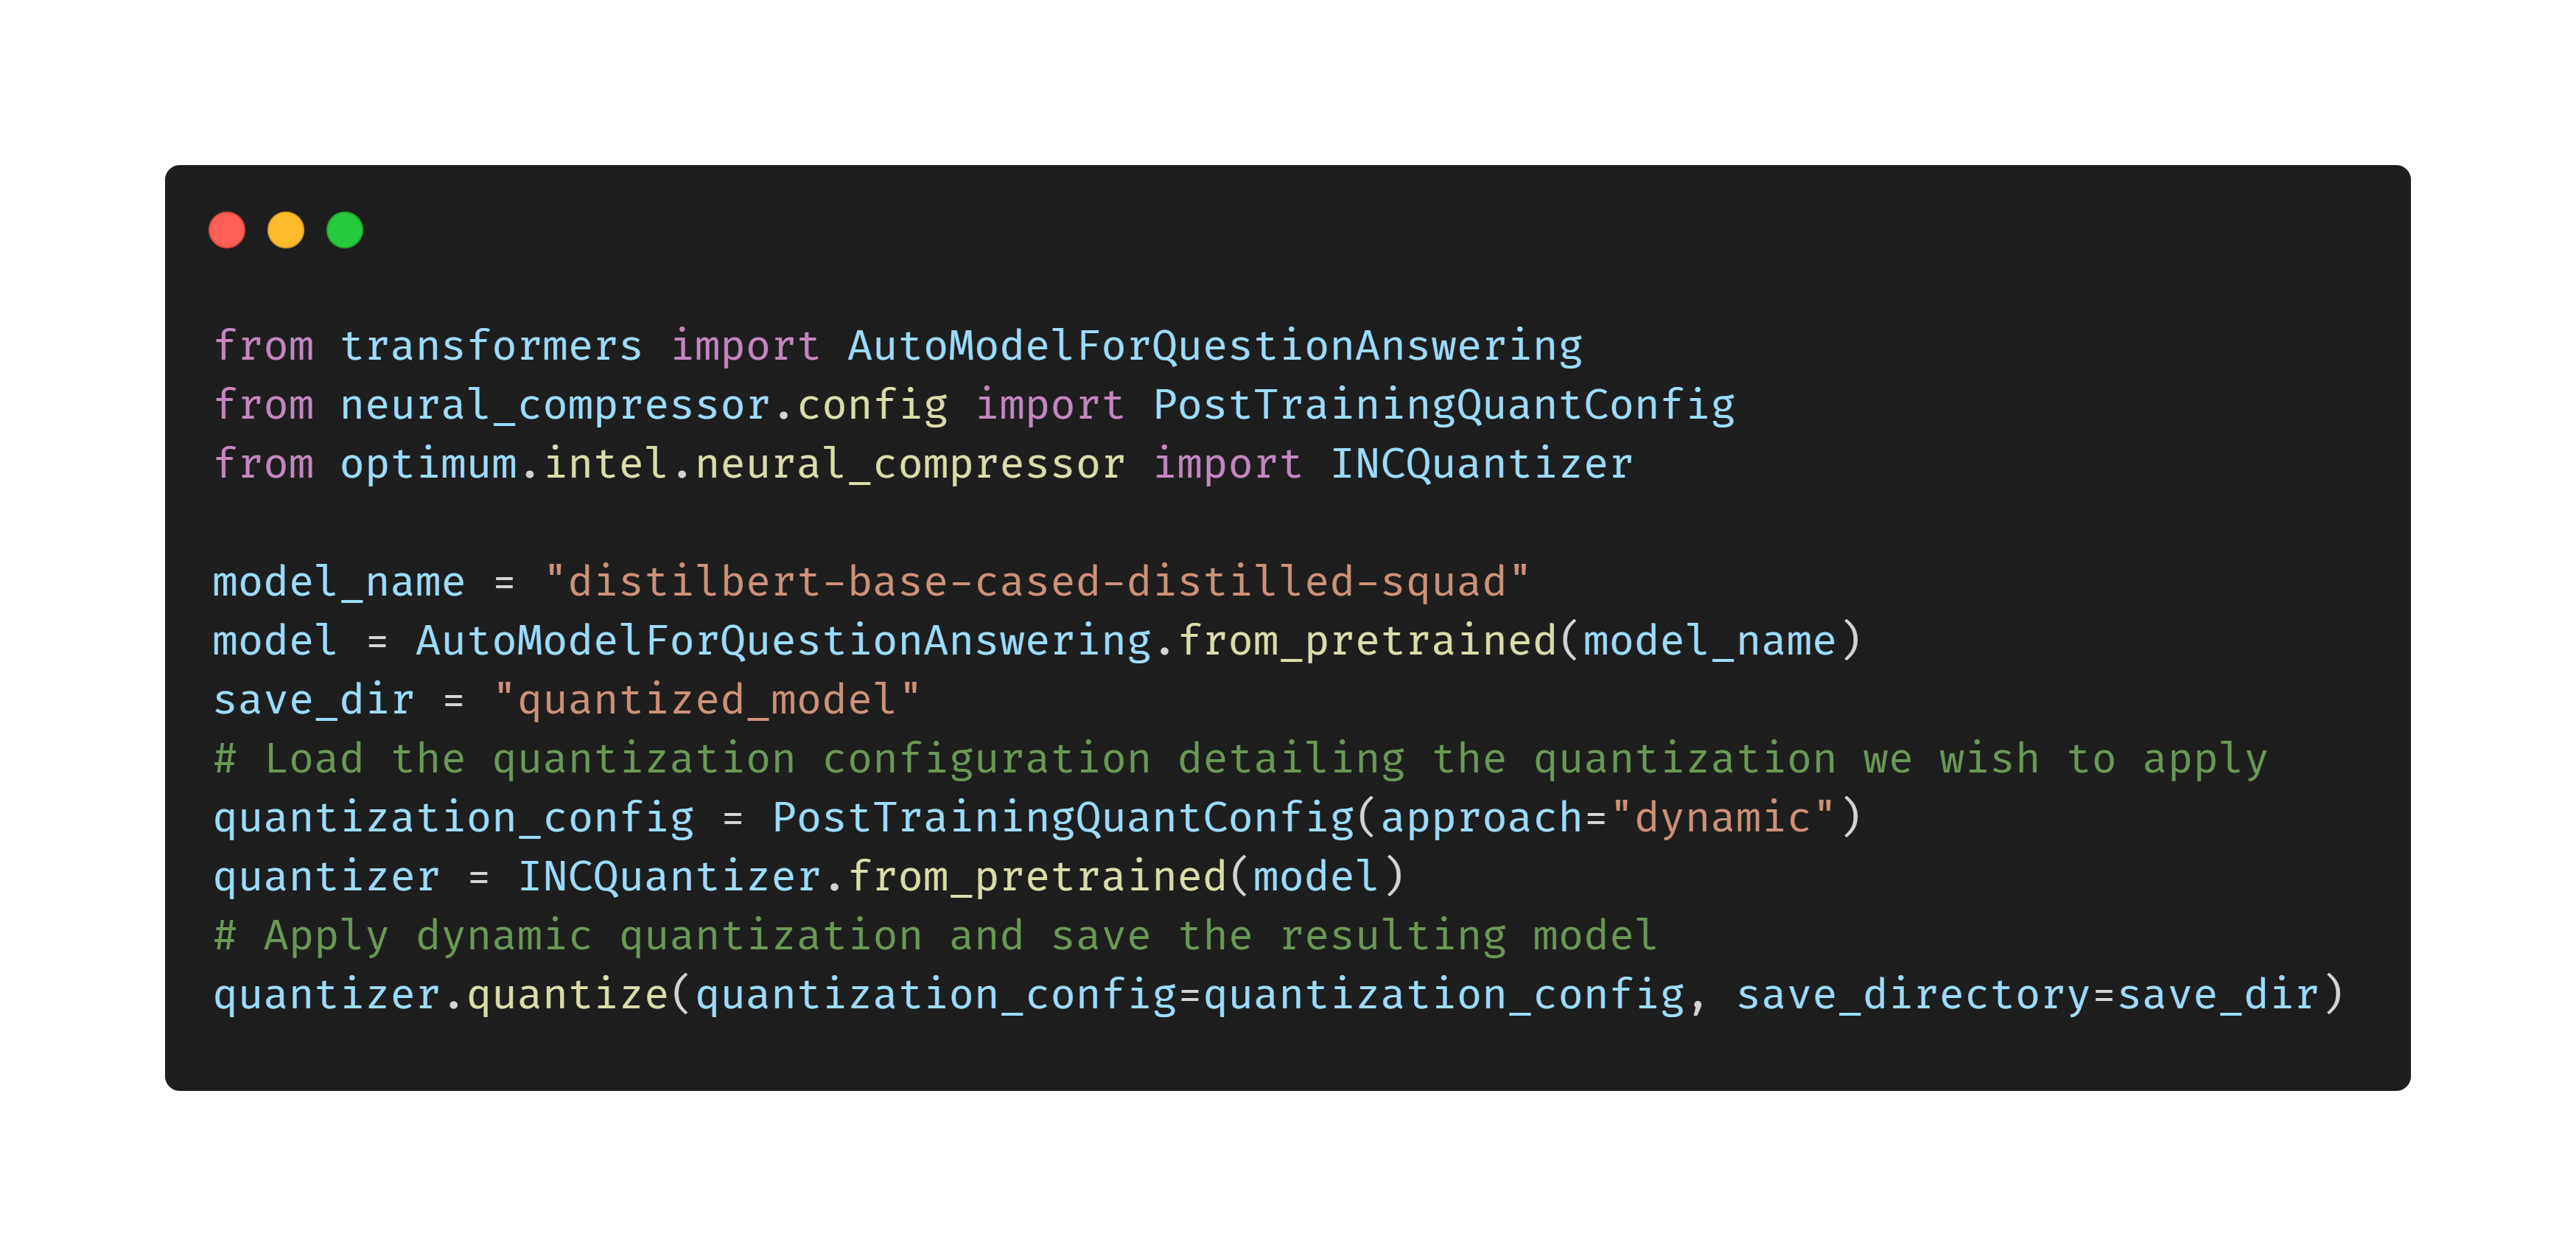
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.

"OlympicCoder": ხელოვნური ინტელექტის ახალი მოდელები კონკურენტულ პროგრამირებაში გიგანტებს აჭარბებენ
მკვლევრებმა შეიმუშავეს ხელოვნური ინტელექტის მოდელების ახალი ნაკრები, სახელწოდებით „OlympicCoder“, რომელიც სპეციალურად კონკურენტული პროგრამირებისთვის არის შექმნილი. CodeForces-ისა და IOI-ის მორგებულ მონაცემთა ბაზებზე გაწვრთნილი OlympicCoder-32B აჩვენებს უმაღლეს დონის შესრულებას, აჯობა ბევრ მნიშვნელოვნად უფრო დიდ, ღია წყაროს მოდელს კოდის მსჯელობის ამოცანებში. ეს მიღწევა უპასუხებს არსებული მონაცემთა ბაზების შეზღუდვებს, სრულად გადამოწმებადი პრობლემური ნაკრებებისა და დეტალური გადაწყვეტილებების მიწოდე

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ
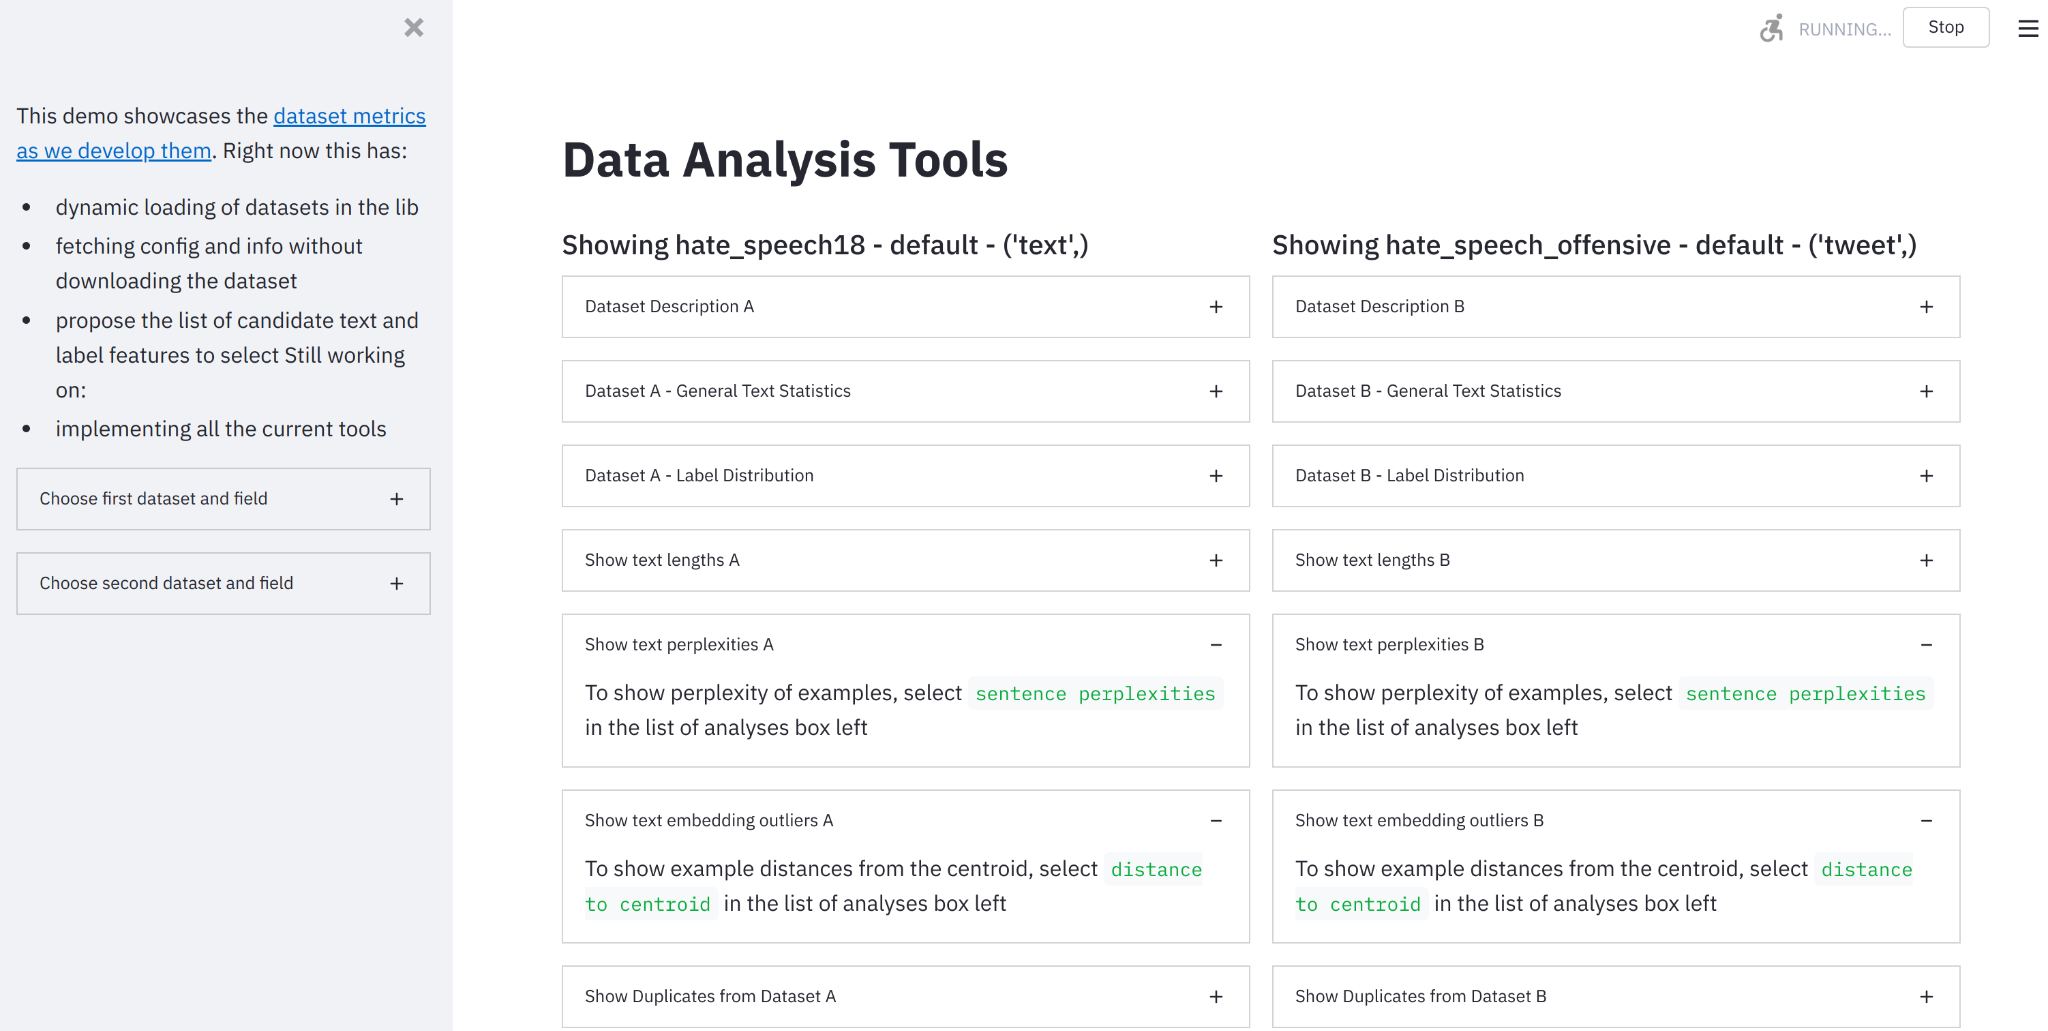
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
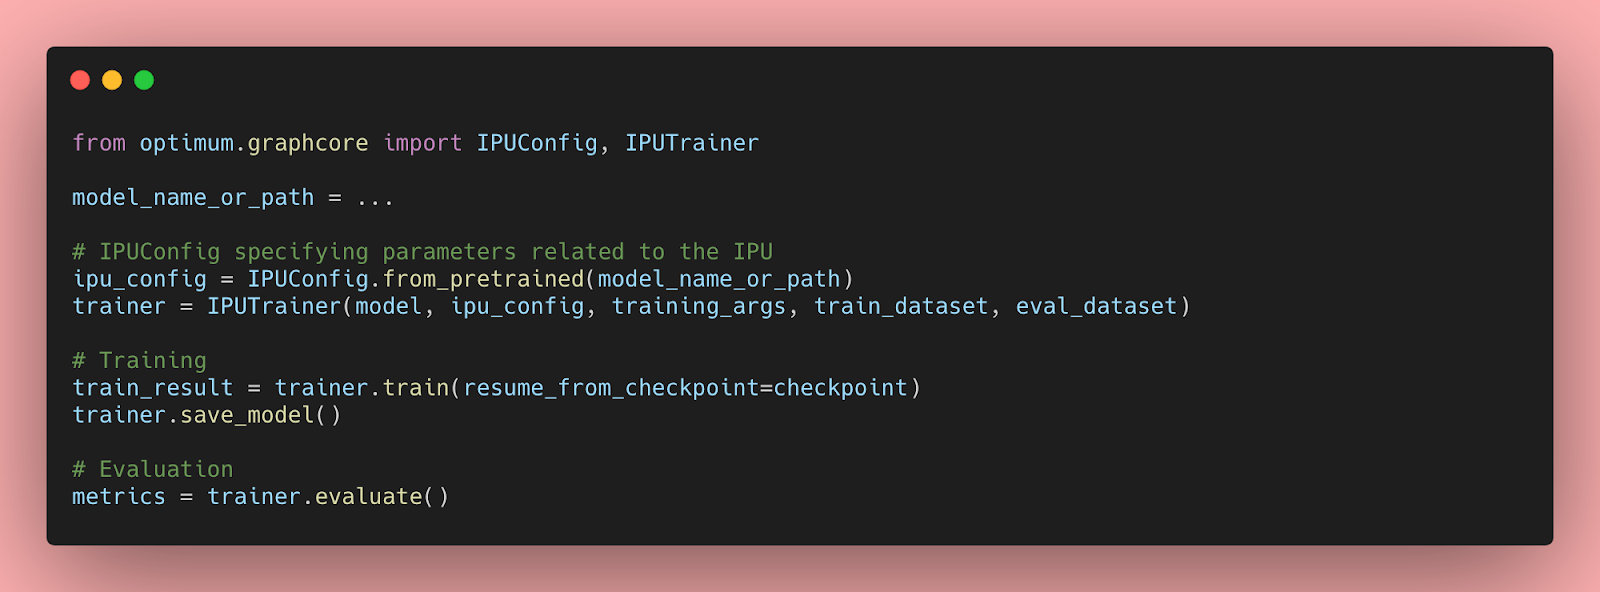
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)