
Math-Verify-ის დანერგვა: ღია LLM ლიდერბორდის რეიტინგების გადაფასება უფრო სამართლიანი შედარებებისთვის
Hugging Face-ის ღია LLM ლიდერბორდმა მნიშვნელოვანი განახლება განიცადა Math-Verify ინსტრუმენტის დანერგვით. ამ ახალმა სისტემამ ხელახლა შეაფასა ყველა 3,751 წარმოდგენილი მოდელი, რამაც გამოასწორა მათემატიკური ამოცანების შეფასების კრიტიკული პრობლემები. შედეგად, ბევრი მოდელის, განსაკუთრებით Qwen-ისა და DeepSeek-ის, ქულები მნიშვნელოვნად გაუმჯობესდა, ხოლო MATH ქვეჯგუფის ტოპ 20 რეიტინგი სრულად გადალაგდა, სადაც Nvidia-ს AceMath მოდელები ახლა დომინირებენ. ეს უზრუნველყოფს მსხვილი ენობრივი მოდელების (LLM) უფრო
Gradio 2.0: Hugging Face-ის მოდელების გამოყენება გრაფიკული ინტერფეისით კოდის მხოლოდ 1 ხაზში
Hugging Face-ის მოდელების ცენტრში ათასობით მანქანური სწავლების მოდელია ხელმისაწვდომი. Gradio-ს ბიბლიოთეკა დეველოპერებს უკვე აძლევდა საშუალებას, მარტივად შეექმნათ დემოები. ახლა, Gradio 2.0-ით, Hugging Face-ის თითქმის ნებისმიერი მოდელის ჩატვირთვა და გრაფიკული ინტერფეისით (GUI) გამოყენება კოდის მხოლოდ 1 ხაზშია შესაძლებელი. ეს სიახლე მნიშვნელოვნად ამარტივებს ხელოვნური ინტელექტის მოდელების ხელმისაწვდომობას როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის და ხსნის ახალ შესაძლებლობებს კომპლექსური
Hugging Face წარმოგიდგენთ TII-ის Falcon 180B-ს: ღია წყაროს მოდელების უახლესი მიღწევა
Hugging Face სიამაყით წარადგენს TII-ის Falcon 180B-ს – ღია წყაროს უდიდეს და უახლესი ტექნოლოგიების მწვერვალზე მდგომ ენობრივ მოდელს. 180 მილიარდი პარამეტრით და 3.5 ტრილიონ ტოკენზე გაწვრთნილი Falcon 180B ლიდერობს ღია წყაროს მოდელებს შორის და კონკურენციას უწევს ისეთ კომერციულ გიგანტებს, როგორიცაა Google-ის PaLM-2. მოდელი უკვე ხელმისაწვდომია Hugging Face Hub-ზე, რაც მაღალი შესაძლებლობის ხელოვნურ ინტელექტს ფართო საზოგადოებისთვის ხელმისაწვდომს ხდის.

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ
Hugging Face-ის გაფართოებული ეკოსისტემა: ახალი პარტნიორები და AI მოდელები ინფერენსისთვის
Hugging Face წარმოგიდგენთ ახალ პარტნიორებსა და ინფერენსის მოდელებს, მათ შორის DeepSeek-R1-სა და Flux.1-ს, რითაც მნიშვნელოვნად აფართოებს ხელმისაწვდომ შესაძლებლობებს AI დეველოპერებისთვის. გაუმჯობესებული ბილინგის სტრუქტურა და PRO მომხმარებლებისთვის განკუთვნილი ყოველთვიური კრედიტები პლატფორმას კიდევ უფრო მიმზიდველს ხდის. სტატიაში მოცემულია მაგალითები და დეტალები მომხმარებლის გამოცდილების შესახებ.

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.

Google-მა PaliGemma 2 Mix გამოუშვა: ახალი ვიზუალური ენის მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა წარადგინა PaliGemma 2 Mix, წინასწარ გაწვრთნილი PaliGemma 2 ვიზუალური ენის მოდელების (VLMs) ახალი ოჯახი, რომელიც დაზუსტებულია სხვადასხვა ვიზუალური ენის ამოცანებისთვის, მათ შორის OCR-ისთვის, მოკლე და გრძელი აღწერისთვის, ობიექტის ამოცნობისა და გამოსახულების სეგმენტაციისთვის. ეს მოდელები, რომლებიც Gemma 2-სა და SigLIP-ზეა დაფუძნებული, შექმნილია შემდგომ ამოცანებზე უკეთესი სწავლისთვის და ხელმისაწვდომია სხვადასხვა ზომისა და რეზოლუციის ვარიანტებში, რაც აჩქარებს დეველოპერებისთვის პროტოტიპების შ
Google-მა PaliGemma 2 mix წარადგინა: ახალი, დახვეწილი ვიზუალურ-ენობრივი მოდელები
გასულ დეკემბერში Google-მა PaliGemma 2-ის წინასწარ გაწვრთნილი (pt) ვიზუალურ-ენობრივი მოდელები (VLM) გამოუშვა, რომლებიც SigLIP-სა და Gemma 2-ზეა დაფუძნებული. დღეს კომპანია წარმოადგენს PaliGemma 2 mix-ს, რომელიც დახვეწილია ვიზუალურ-ენობრივ ამოცანებზე, მათ შორის OCR-ზე (ოპტიკური სიმბოლოების ამოცნობა), გრძელ და მოკლე წარწერების გენერირებაზე და სხვა. ეს მოდელები განკუთვნილია სპეციფიკურ ამოცანებზე ადაპტირებისთვის და გთავაზობთ სხვადასხვა შესაძლებლობებს, როგორიცაა ობიექტის ამოცნობა და სეგმენტაცია, გაუმჯ
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ

Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.
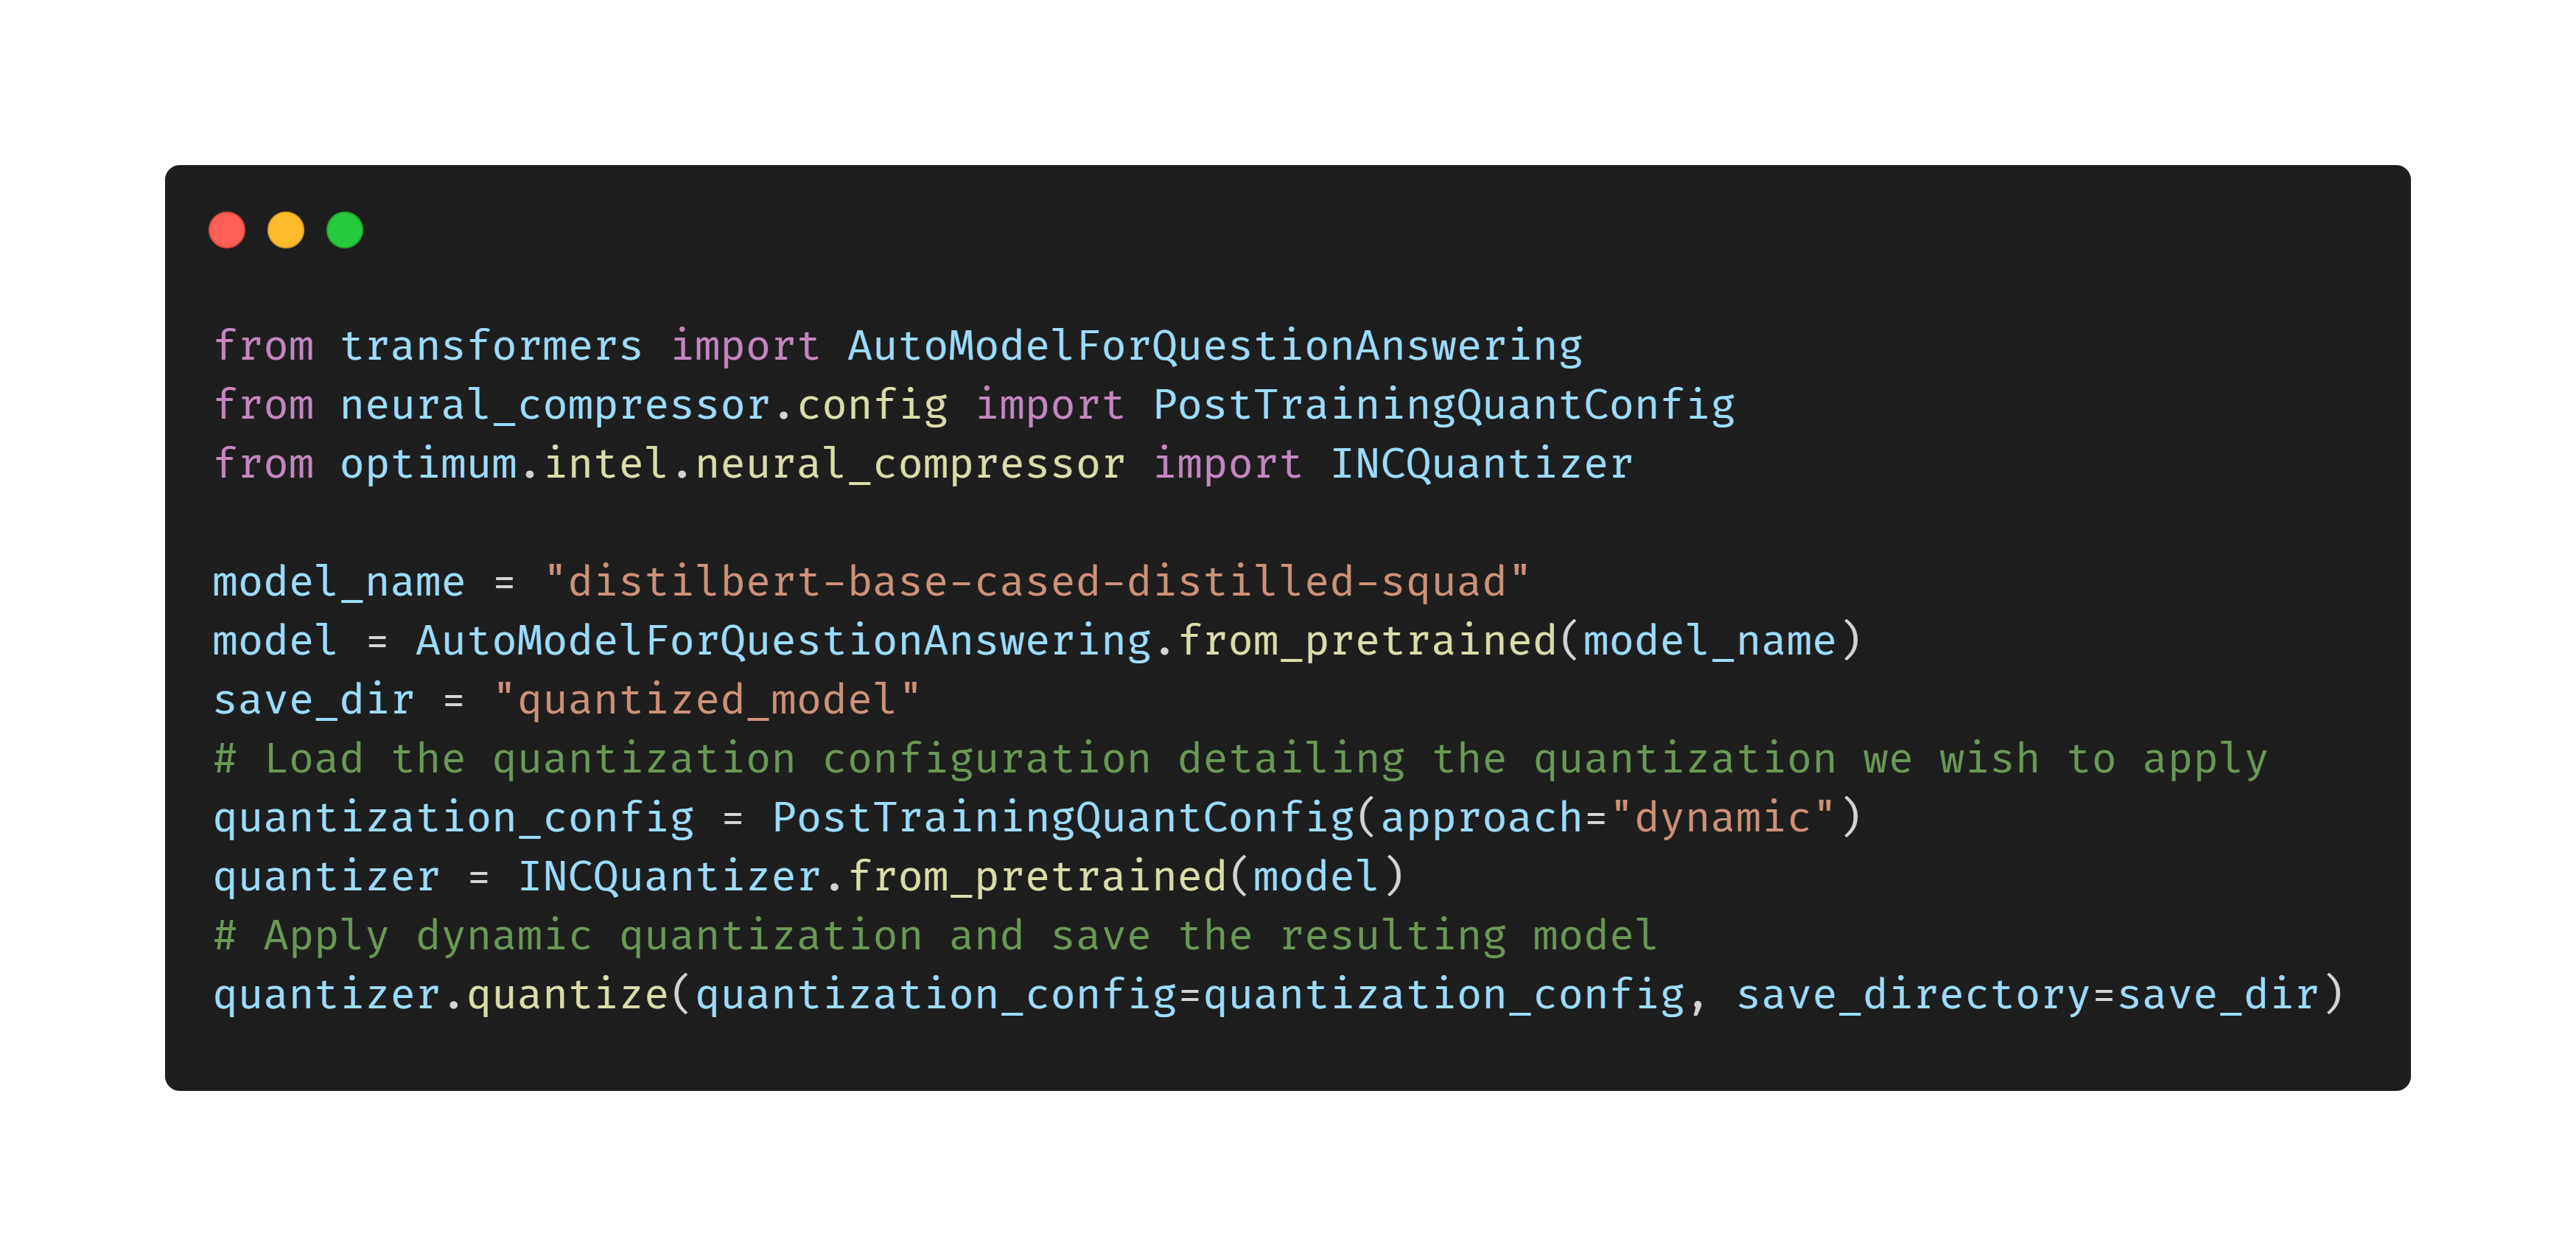
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
LLM-ების ეფექტური განლაგება: გამოთვლითი და მეხსიერების გამოწვევების გადაჭრა
დიდი ენობრივი მოდელები (LLM-ები) სწრაფად იკიდებენ ფეხს ცოდნაზე დაფუძნებულ ინდუსტრიებში, თუმცა მათი რეალურ სამყაროში განლაგება გამოწვევებითაა სავსე, განსაკუთრებით გამოთვლითი რესურსებისა და მეხსიერების კუთხით, ვრცელი შეტანის თანმიმდევრობებთან მუშაობისას. ეს პოსტი მიმოიხილავს ყველაზე ეფექტურ ტექნიკებს LLM-ების ოპტიმიზებული განლაგებისთვის, მათ შორის დაბალ სიზუსტეს (8-ბიტიანი და 4-ბიტიანი), Flash Attention-ს მეხსიერების ეფექტური გამოყენებისთვის და არქიტექტურულ ინოვაციებს, როგორიცაა Alibi, Rotary embe

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
Hugging Face-ი და Graphcore-ი AI-ის ოპტიმიზაციისთვის პარტნიორობენ IPU-ებზე Transformer მოდელების განვითარებით
Hugging Face-ის ახალი აპარატურის პარტნიორის პროგრამა Graphcore-ის სისტემების მომხმარებელ დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ IPU-ებისთვის ოპტიმიზებული უახლესი Transformer მოდელები. ეს თანამშრომლობა მიზნად ისახავს ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას, მაღალი წარმადობისა და ეფექტურობის უზრუნველყოფით ისეთ სფეროებში, როგორიცაა ბუნებრივი ენის დამუშავება (NLP), კომპიუტერული ხედვა და სხვა.
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.