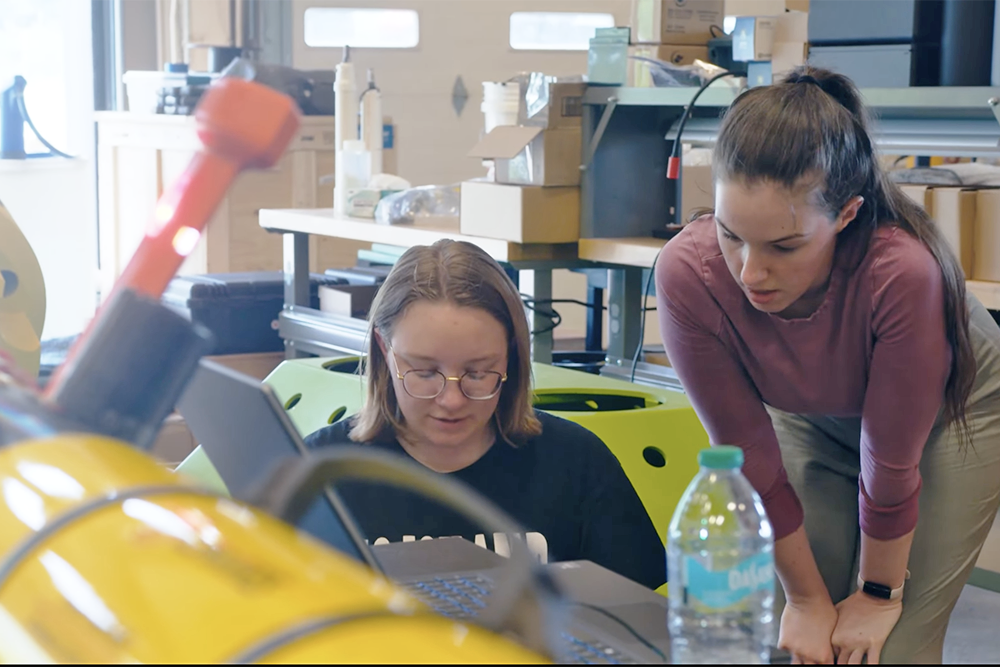
MIT-ის ლინკოლნის ლაბორატორიის სტაჟიორი აივი მანკე წყალქვეშა ნავიგაციის ალგორითმებს ატესტებს
ოლინის საინჟინრო კოლეჯის სტუდენტმა, აივი მანკემ, ზაფხულის სტაჟირება MIT-ის ლინკოლნის ლაბორატორიაში გაიარა, სადაც წყალქვეშა ნავიგაციისთვის განკუთვნილი ალგორითმები პრაქტიკული მეთოდებით შეამოწმა. მან შეიმუშავა და გამოსცადა ალგორითმი, რომელიც ადამიანს და რობოტულ სატრანსპორტო საშუალებას წყალქვეშ ერთობლივ ნავიგაციაში დაეხმარებოდა, მიუხედავად GPS-ის მსგავსი ტრადიციული ლოკალიზაციის საშუალებების არარსებობისა. მისი ნამუშევარი წარმატებით გამოიცადა რეალურ წყალქვეშა გარემოში.
ტვინის მსგავსი კომპიუტერები რთულ მათემატიკურ განტოლებებს ხსნიან: ახალი ნაბიჯი ნეირომორფული სუპერკომპიუტერებისკენ
სანდიას ეროვნული ლაბორატორიების მეცნიერებმა შეიმუშავეს ახალი ალგორითმი, რომელიც ნეირომორფულ აპარატურას (ადამიანის ტვინის სტრუქტურის მიმბაძველ კომპიუტერებს) ნაწილობრივ დიფერენციალური განტოლებების (PDEs) ამოხსნის საშუალებას აძლევს. ეს აღმოჩენა მოულოდნელ ძალას ავლენს ტვინის მსგავს კომპიუტერებში, რომლებიც აქამდე ძირითადად ნიმუშების ამოცნობისთვის გამოიყენებოდა. შედეგები მიუთითებს ენერგოეფექტური ნეირომორფული სუპერკომპიუტერების შექმნის პოტენციალზე, რაც მნიშვნელოვანია ეროვნული უსაფრთხოებისა და სხვა კრიტ
ნეირომორფული კომპიუტერები რთულ მათემატიკურ ამოცანებს წყვეტენ: გზა ენერგოეფექტური სუპერკომპიუტერებისკენ
ადამიანის ტვინის სტრუქტურის მიმბაძველმა ნეირომორფულმა კომპიუტერებმა მოულოდნელი ძალა გამოავლინეს რთული მათემატიკური განტოლებების ამოხსნაში, რომლებიც საფუძვლად უდევს მეცნიერულ და საინჟინრო პრობლემებს. სანდიას ეროვნული ლაბორატორიების მკვლევრებმა, ბრედ თეილმანმა და ბრედ აიმონმა, წარმოადგინეს ახალი ალგორითმი, რომელიც ნეირომორფულ აპარატურას კერძო წარმოებულების დიფერენციალური განტოლებების (კწდგ) ამოხსნის საშუალებას აძლევს. ეს მიღწევა მნიშვნელოვანია ისეთი ფენომენების მოდელირებისთვის, როგორიცაა სითხის დი
AI WebTV: ხელოვნური ინტელექტით შექმნილი ვიდეო კონტენტის ინოვაციური პლატფორმა
AI WebTV წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დემონსტრირებს ღია კოდის ტექსტი-ვიდეოდ გადამყვანი მოდელებით, როგორიცაა Zeroscope და MusicGen, გენერირებულ ვიდეოებს. ის შექმნილია მოკლე, ტექნოლოგიური დემო კლიპების სახით, სადაც დიდი ენობრივი მოდელები (LLM), მაგალითად ChatGPT, გამოიყენება ვიდეო კადრებისთვის მრავალფეროვანი მოთხოვნების შესაქმნელად. სისტემა დანერგილია NodeJS-სა და TypeScript-ში, იყენებს Hugging Face-ის სერვისებს და მოიცავს კადრების გაფართოებას FILM ალგორითმით, ასევე მუსიკის დამატებას
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
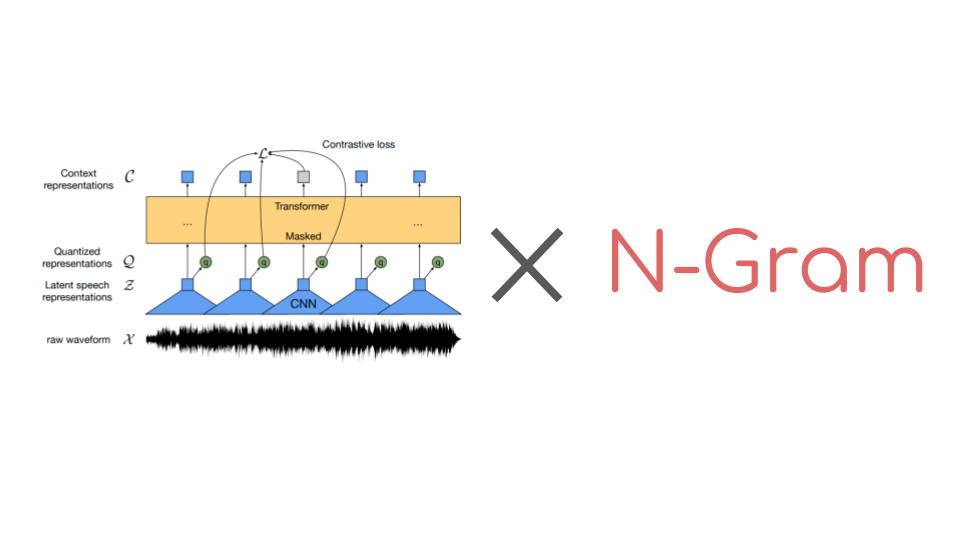
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.
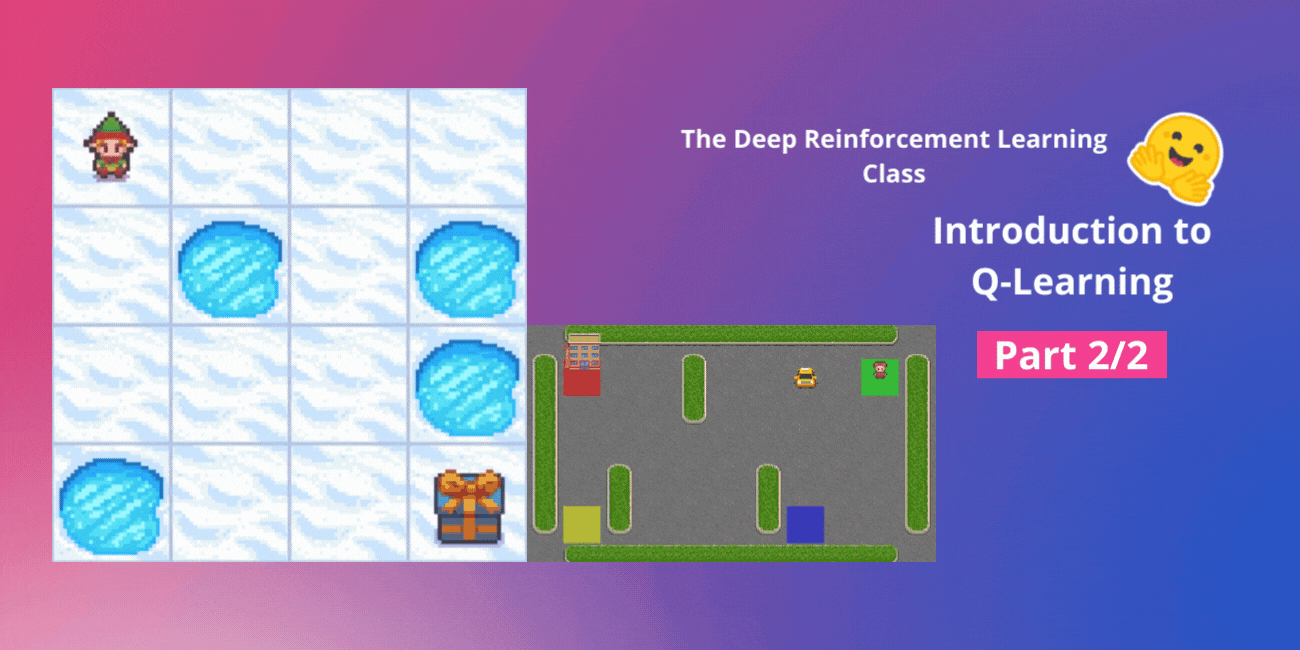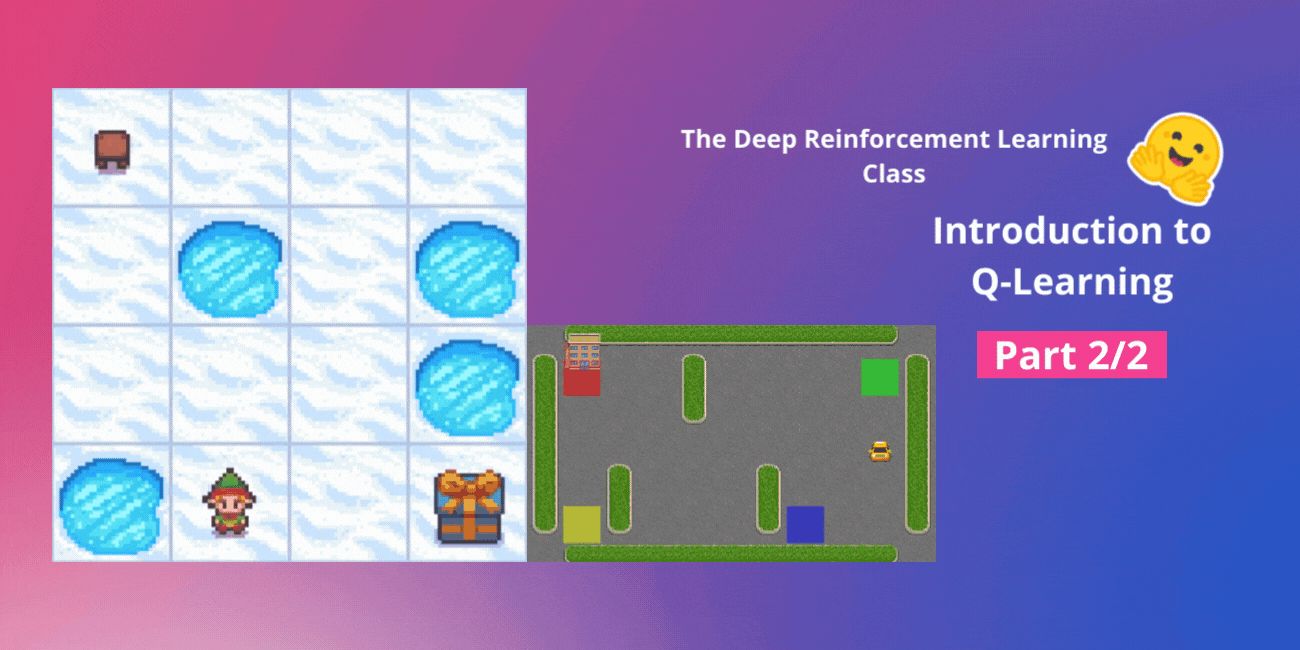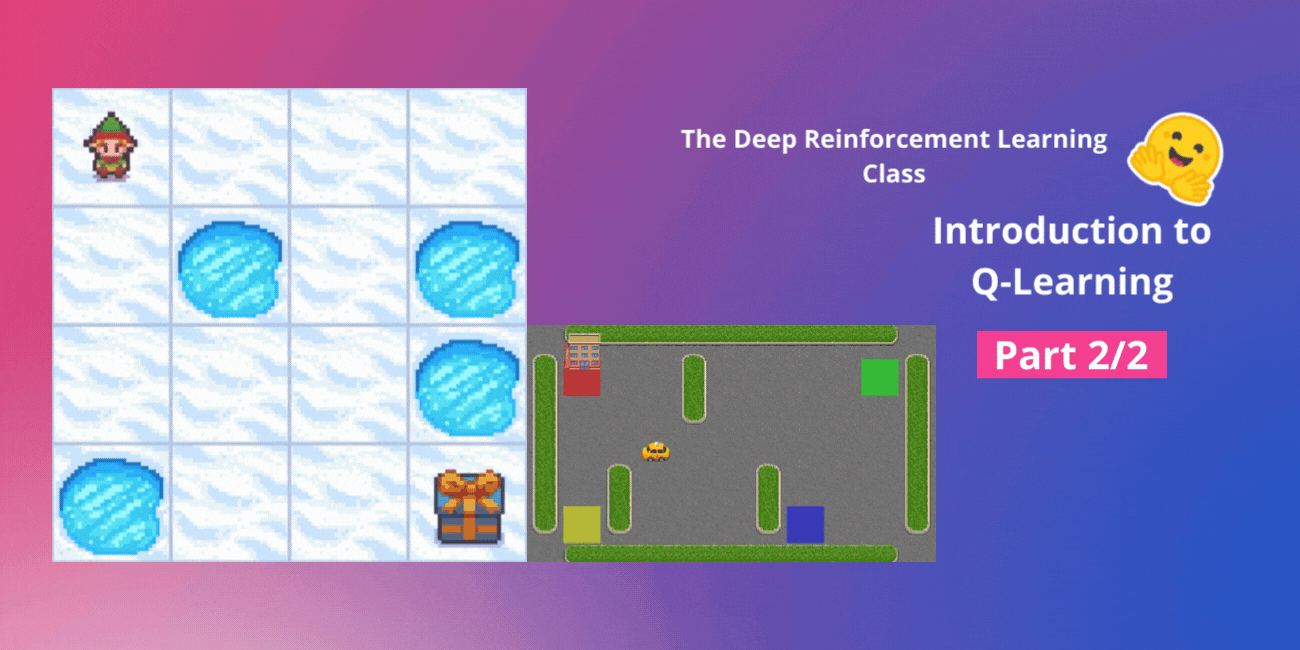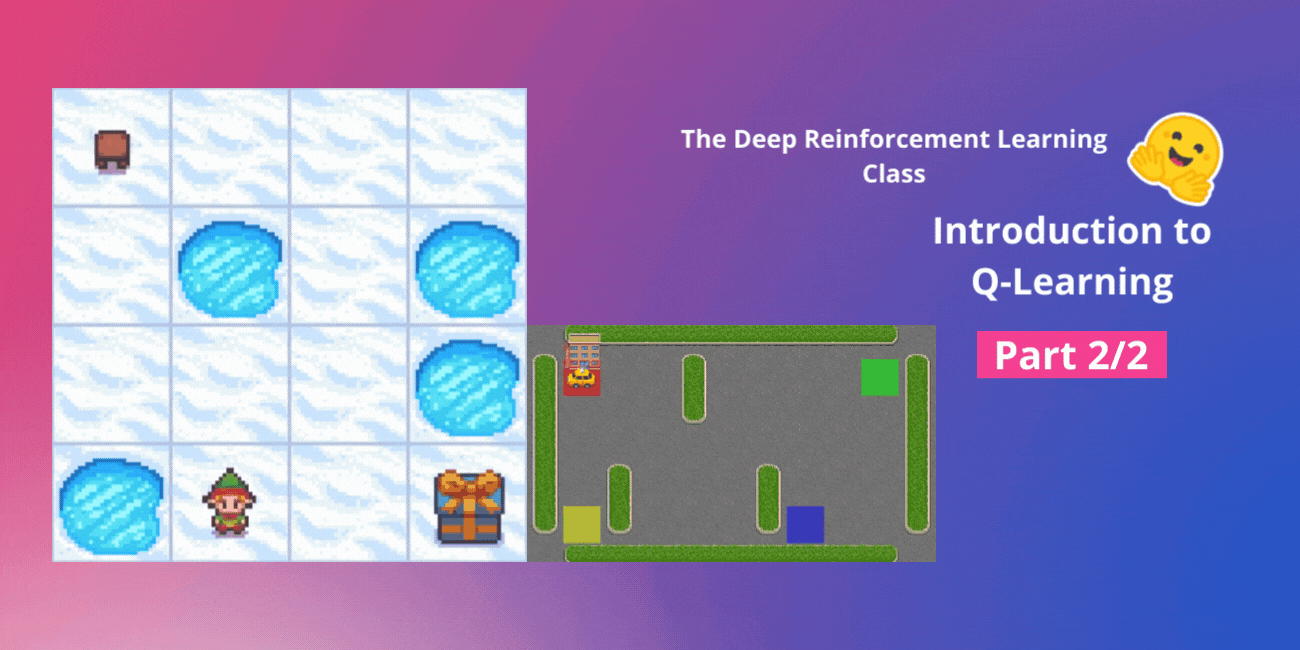
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.