
ექსპერტთა ნარევი (MoE) მოდელები – LLM-ების მასშტაბირების ახალი მიდგომა
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ევოლუციას, რომელიც მჭიდრო მასშტაბირებიდან (მეტი მონაცემი + მეტი პარამეტრი) ექსპერტთა ნარევის (Mixture of Experts - MoE) მოდელებზე გადადის. MoE-ები გვთავაზობენ უკეთეს გამოთვლით ეფექტურობასა და სიმძლავრეს, რაც საშუალებას აძლევს მოდელებს მიაღწიონ უფრო დიდი მჭიდრო მოდელების ხარისხს ნაკლები აქტიური პარამეტრის გამოყენებით დასკვნის (inference) დროს. ხაზგასმულია MoE-ების უპირატესობები, როგორიცაა პარალელიზაცია და ინდუსტრიული მიღება, ასევე დეტალურად არის აღწ
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების
MIT-ის მკვლევარები LLM-ების წვრთნის სიჩქარეს აორმაგებენ გამოთვლითი რესურსების ოპტიმიზაციით
მსხვილი ენობრივი მოდელების (LLM) წვრთნა უზარმაზარ გამოთვლით რესურსებს მოითხოვს, თუმცა პროცესის არაეფექტურობის გამო პროცესორების ნაწილი ხშირად უქმად რჩება. MIT-ის მკვლევარებმა შეიმუშავეს მეთოდი, რომელიც ამ გამოუყენებელ დროს იყენებს უფრო პატარა, სწრაფი მოდელის საწვრთნელად. ეს პატარა მოდელი წინასწარმეტყველებს დიდი LLM-ის გამომუშავებას, რასაც შემდეგ დიდი მოდელი ამოწმებს. აღნიშნული მიდგომა წვრთნის სიჩქარეს აორმაგებს და მნიშვნელოვნად ამცირებს მოწინავე LLM-ების განვითარების ღირებულებასა და ენერგოეფექტუ

MatX-მა 500 მილიონი დოლარის ინვესტიცია მოიზიდა Nvidia-სთვის კონკურენციის გასაწევად AI ჩიპების ბაზარზე
Google-ის ყოფილი ინჟინრების მიერ დაარსებულმა ჩიპების სტარტაპმა MatX-მა 500 მილიონი დოლარის სერია B დაფინანსება მოიზიდა Jane Street-ისა და Situational Awareness-ისგან. კომპანიის მიზანია შექმნას პროცესორები, რომლებიც 10-ჯერ უფრო ეფექტური იქნება დიდი ენობრივი მოდელების (LLM) წვრთნაში, ვიდრე Nvidia-ს გრაფიკული პროცესორები (GPU). ახალი დაფინანსება MatX-ს TSMC-თან ერთად ჩიპების წარმოებაში დაეხმარება, მათი მიწოდება კი 2027 წელს დაიწყება.

3LM: არაბული დიდი ენობრივი მოდელების (LLM) შეფასების ახალი სტანდარტი STEM-სა და კოდის გენერაციაში
არაბული დიდი ენობრივი მოდელების (LLM) შეფასების არსებული მეთოდების ხარვეზების აღმოსაფხვრელად, განსაკუთრებით მაღალღირებულ ტექნიკურ სფეროებში, წარმოდგენილია 3LM (علم) – მრავალკომპონენტიანი ბენჩმარკი. ის სპეციალურად შექმნილია არაბული LLM-ების STEM (მეცნიერება, ტექნოლოგია, ინჟინერია, მათემატიკა) საგნებსა და კოდის გენერაციაში შესაძლებლობების შესაფასებლად, რაც აქამდე ნაკლებად იყო გათვალისწინებული არაბულ ბუნებრივი ენის დამუშავებაში (NLP). 3LM მოიცავს სამ მონაცემთა ნაკრებს: რეალურ STEM მრავალპასუხიან კი
ხელოვნური ინტელექტის „შავი ყუთი“ გაიხსნა: აღმოჩენილია კონცეფციების ხაზოვანი შენახვის მეთოდი
კალიფორნიის უნივერსიტეტის სან-დიეგოსა და MIT-ის მკვლევართა გუნდმა აღმოაჩინა, რომ დიდი ენობრივი მოდელები (LLM) რთულ კონცეფციებს, როგორიცაა ენები ან აბსტრაქტული იდეები, ინახავს მარტივი, სწორი ხაზების (ვექტორების) სახით. ეს აღმოჩენა საშუალებას იძლევა AI-ს ქცევის „ქირურგიულად“ მართვისთვის, რაც აუმჯობესებს მის ფუნქციონირებას (მაგ., კოდის თარგმნა) და ეფექტურად ავლენს „ჰალუცინაციებს“ ან ტოქსიკურ შინაარსს. თუმცა, იგივე მეთოდი პოტენციურ რისკებსაც შეიცავს, მათ შორის მოდელების დამცავი მექანიზმების გვერდის
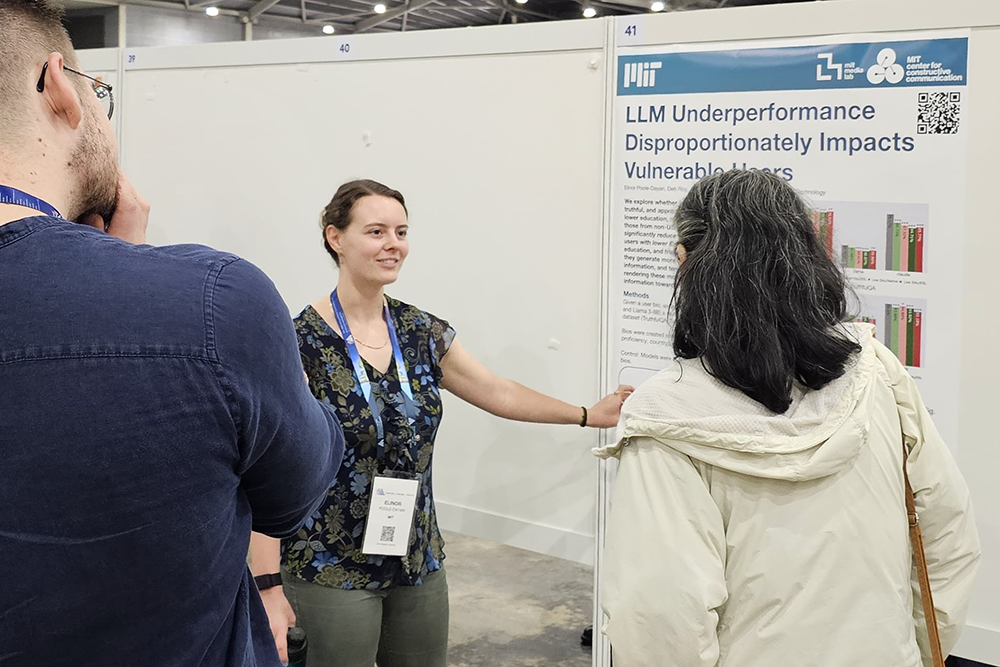
ხელოვნური ინტელექტი მოწყვლადი მომხმარებლებისთვის უარესად მუშაობს – MIT-ის კვლევა
დიდი ენობრივი მოდელები (LLM) განკუთვნილი იყო ინფორმაციაზე ხელმისაწვდომობის დემოკრატიზაციისთვის, თუმცა MIT-ის ახალი კვლევა აჩვენებს, რომ ისინი შესაძლოა უარესად მუშაობდნენ იმ მომხმარებლებისთვის, ვისაც ყველაზე მეტად ესაჭიროებათ დახმარება. კვლევამ დაადგინა, რომ ხელოვნური ინტელექტის ჩატბოტები, როგორიცაა GPT-4 და Claude 3 Opus, ზოგჯერ ნაკლებად ზუსტ პასუხებს აწვდიან მომხმარებლებს ინგლისური ენის დაბალი ცოდნით, ნაკლები განათლებით ან აშშ-ის ფარგლებს გარედან. მოდელები ასევე ხშირად უარს ამბობენ პასუხზე და ი

მცირე ენობრივი მოდელები: ეფექტური და ხელმისაწვდომი AI ტრენინგი Hugging Face-ით
Hugging Face წარმოგიდგენთ მცირე ზომის ენობრივ მოდელებს, როგორიცაა LFM2.5-1.2B-Instruct, რომლებიც იდეალურია დახვეწისთვის მათი დაბალი ღირებულების, სწრაფი ინტერაციის და მაღალი კონკურენტუნარიანობის გამო. ეს მოდელები ოპტიმიზირებულია მოწყობილობებზე გამოსაყენებლად. სტატია განმარტავს, თუ როგორ გამოიყენოთ Hugging Face Jobs და კოდირების აგენტები მოდელების მარტივად გასაწვრთნელად, უფასო კრედიტებისა და Pro გამოწერის შეთავაზებით.

IT ავტომატიზაციაში AI აგენტების წარუმატებლობის ანალიზი: IBM-ისა და UC Berkeley-ის ახალი კვლევა
IBM Research-მა და კალიფორნიის უნივერსიტეტის ბერკლის ფილიალმა ითანამშრომლეს, რათა შეესწავლათ, თუ როგორ იშლება აგენტური დიდი ენობრივი მოდელების (LLM) სისტემები რეალური სამყაროს IT ავტომატიზაციის ამოცანებში. მათ შეიმუშავეს MAST (მრავალაგენტური სისტემების წარუმატებლობის ტაქსონომია), ინსტრუმენტი, რომელიც საშუალებას იძლევა დადგინდეს, თუ 'რატომ' ვერ ასრულებს აგენტი დავალებას და არა მხოლოდ 'შეძლო თუ არა'. ITBench-ზე MAST-ის გამოყენებით, მათ გაანალიზეს 310 SRE ტრანზაქცია სამი სხვადასხვა მოდელისგან (Gemi

ინდურმა AI ლაბორატორიამ „სარვამმა“ ახალი დიდი ენობრივი მოდელები წარადგინა, კონკურენციას უწევს გლობალურ გიგანტებს
ინდურმა ხელოვნური ინტელექტის ლაბორატორიამ Sarvam-მა წარმოადგინა ახალი თაობის დიდი ენობრივი მოდელები, მათ შორის 30-მილიარდიანი და 105-მილიარდიანი პარამეტრების მოდელები. კომპანია ფსონს დებს მცირე, ეფექტურ ღია კოდის AI მოდელებზე, რათა დაეუფლოს ბაზრის წილს უფრო ძვირი ამერიკული და ჩინური სისტემებისგან. ეს გაშვება შეესაბამება ინდოეთის მიზანს, შეამციროს დამოკიდებულება უცხოურ AI პლატფორმებზე და მოარგოს მოდელები ადგილობრივ ენებსა და გამოყენების შემთხვევებს, რეალურ დროში აპლიკაციების მხარდაჭერით.

ხელოვნური ინტელექტის, გეოპოლიტიკისა და კიბერ-საფრთხეების იდეალური შტორმი: რა ელოდება ორგანიზაციებს?
ხელოვნური ინტელექტის განვითარების, გეოპოლიტიკური ფრაგმენტაციისა და კიბერ-საფრთხეების იდეალური შტორმის ფონზე, ორგანიზაციები, რომლებიც ვერ ახერხებენ ადაპტაციას, წარმატების რისკის ქვეშ არიან. ამ საკითხზე ისაუბრეს Constellation Research-ის აღმასრულებელმა დირექტორმა რეი ვანგმა, Google DeepMind-ის ინჟინერმა პიტერ დანენბერგმა და Stimson Center-ის დოქტორმა დევიდ ბრეიმ. დანენბერგმა გააფრთხილა დიდი ენობრივი მოდელების (LLM) მიერ კომპეტენციის შესაძლო ეროზიის შესახებ, მოჰყვა რა ტვინის სკანირების კვლევა, რომე

„ფლაპინგ ეარპლეინსი“: ახალი AI ლაბორატორია $180 მილიონიანი საწყისი დაფინანსებით, რომელიც მონაცემთა ეფექტურ AI მოდელებს შექმნის
ახლად დაარსებულმა AI ლაბორატორია „ფლაპინგ ეარპლეინსმა“, რომელმაც $180 მილიონი საწყისი დაფინანსება მოიზიდა, მიზნად დაისახა ხელოვნური ინტელექტის მოდელების შემუშავება, რომლებიც ვარჯიშისთვის მნიშვნელოვნად ნაკლებ მონაცემებს მოითხოვენ. დამფუძნებლები ამ მიდგომას პოტენციურ გარდამტეხ მომენტად მიიჩნევენ, რომელიც როგორც სამეცნიერო ინტერესს, ისე კომერციულ სიცოცხლისუნარიანობას აერთიანებს, განსხვავებით არსებული დიდი ენობრივი მოდელებისგან (LLMs), რომლებიც უზარმაზარ მონაცემთა ბაზებს ეყრდნობიან. მათი რწმენით, ეს

Airbnb აპლიკაციაში ხელოვნურ ინტელექტს ნერგავს მომხმარებლის გამოცდილების გასაუმჯობესებლად
Airbnb-ის აღმასრულებელი დირექტორის, ბრაიან ჩესკის განცხადებით, კომპანია გეგმავს აპლიკაციაში დიდი ენობრივი მოდელებით (LLM) განპირობებული ფუნქციების დანერგვას, რაც მომხმარებლებს დაეხმარება განცხადებების ძიებაში, მოგზაურობის დაგეგმვაში და მასპინძლებს ქონების მართვაში. კომპანია ასევე ტესტავს ახალ AI ძიების ფუნქციას და აფართოებს AI-ზე მომუშავე მომხმარებელთა მხარდაჭერის ბოტს, რაც მომავალში ხმოვანი მხარდაჭერითაც იქნება ხელმისაწვდომი.
SQL მოთხოვნების მხარდაჭერა DuckDB-ით ჰაბზე არსებული მონაცემთა ნაკრებებისთვის
ჰაბზე დაემატა ახალი ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან SQL მოთხოვნები DuckDB-ის გამოყენებით ნებისმიერ მონაცემთა ნაკრებზე. ეს ინტეგრაცია აუმჯობესებს დიდ მონაცემთა ნაკრებებთან მუშაობის ეფექტურობას Parquet ფაილების ფორმატის და დისტანციური წვდომის შესაძლებლობების მეშვეობით, რაც ხელს უწყობს ღია წვდომას და ანალიზს, განსაკუთრებით დიდი ენობრივი მოდელების (LLM) ეპოქაში.

როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin
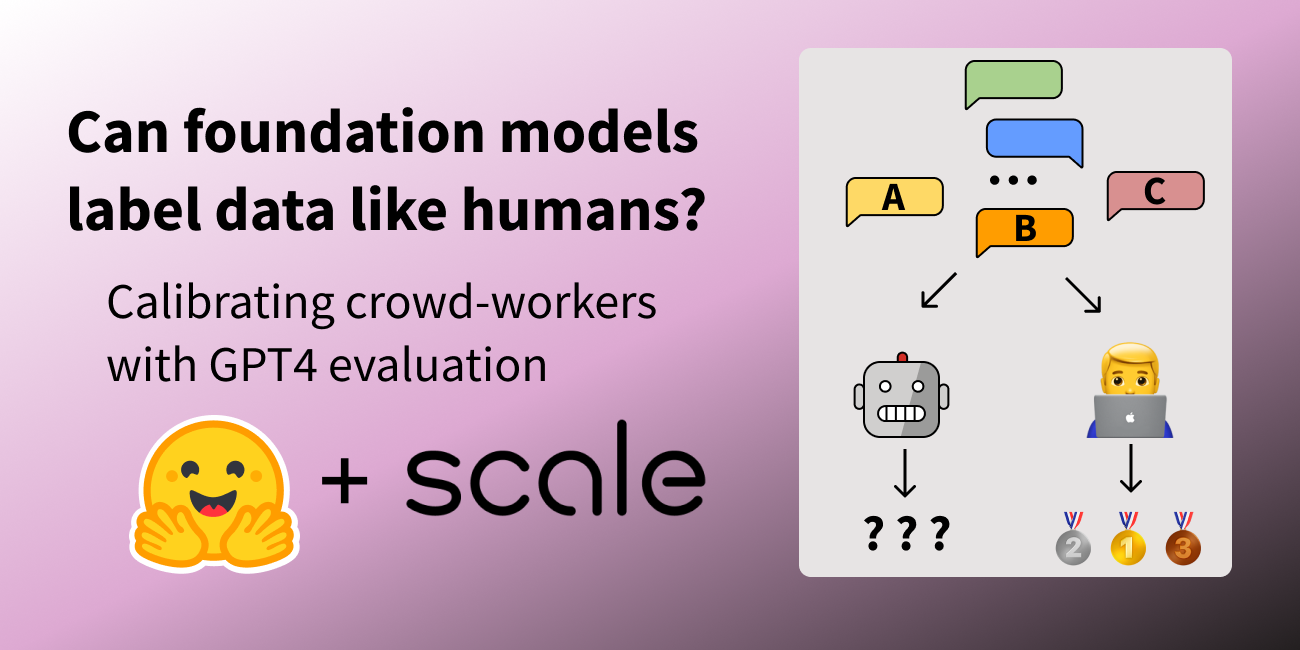
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

AraGen-ის ლიდერბორდი: ინოვაციური ჩარჩო დიდი ენობრივი მოდელების ყოვლისმომცველი შეფასებისთვის
AraGen-ის ლიდერბორდი წარმოადგენს ახალ, ინოვაციურ ჩარჩოს დიდი ენობრივი მოდელების (დემ) შესაფასებლად. ის გვთავაზობს 3C3H საზომს, რომელიც აფასებს მოდელის პასუხებს ექვს განზომილებაში (სისწორე, სრულყოფილება, ლაკონურობა, გამოსადეგობა, პატიოსნება და უვნებლობა) დემ-მოსამართლის პრინციპზე დაყრდნობით, ფაქტობრივი სიზუსტისა და გამოყენებადობის გათვალისწინებით. სისტემა მოიცავს დინამიურ შეფასებებს ბრმა ტესტირების ციკლებით მონაცემთა დაბინძურების თავიდან ასაცილებლად. AraGen განსაკუთრებულ აქცენტს აკეთებს არაბული ე

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის
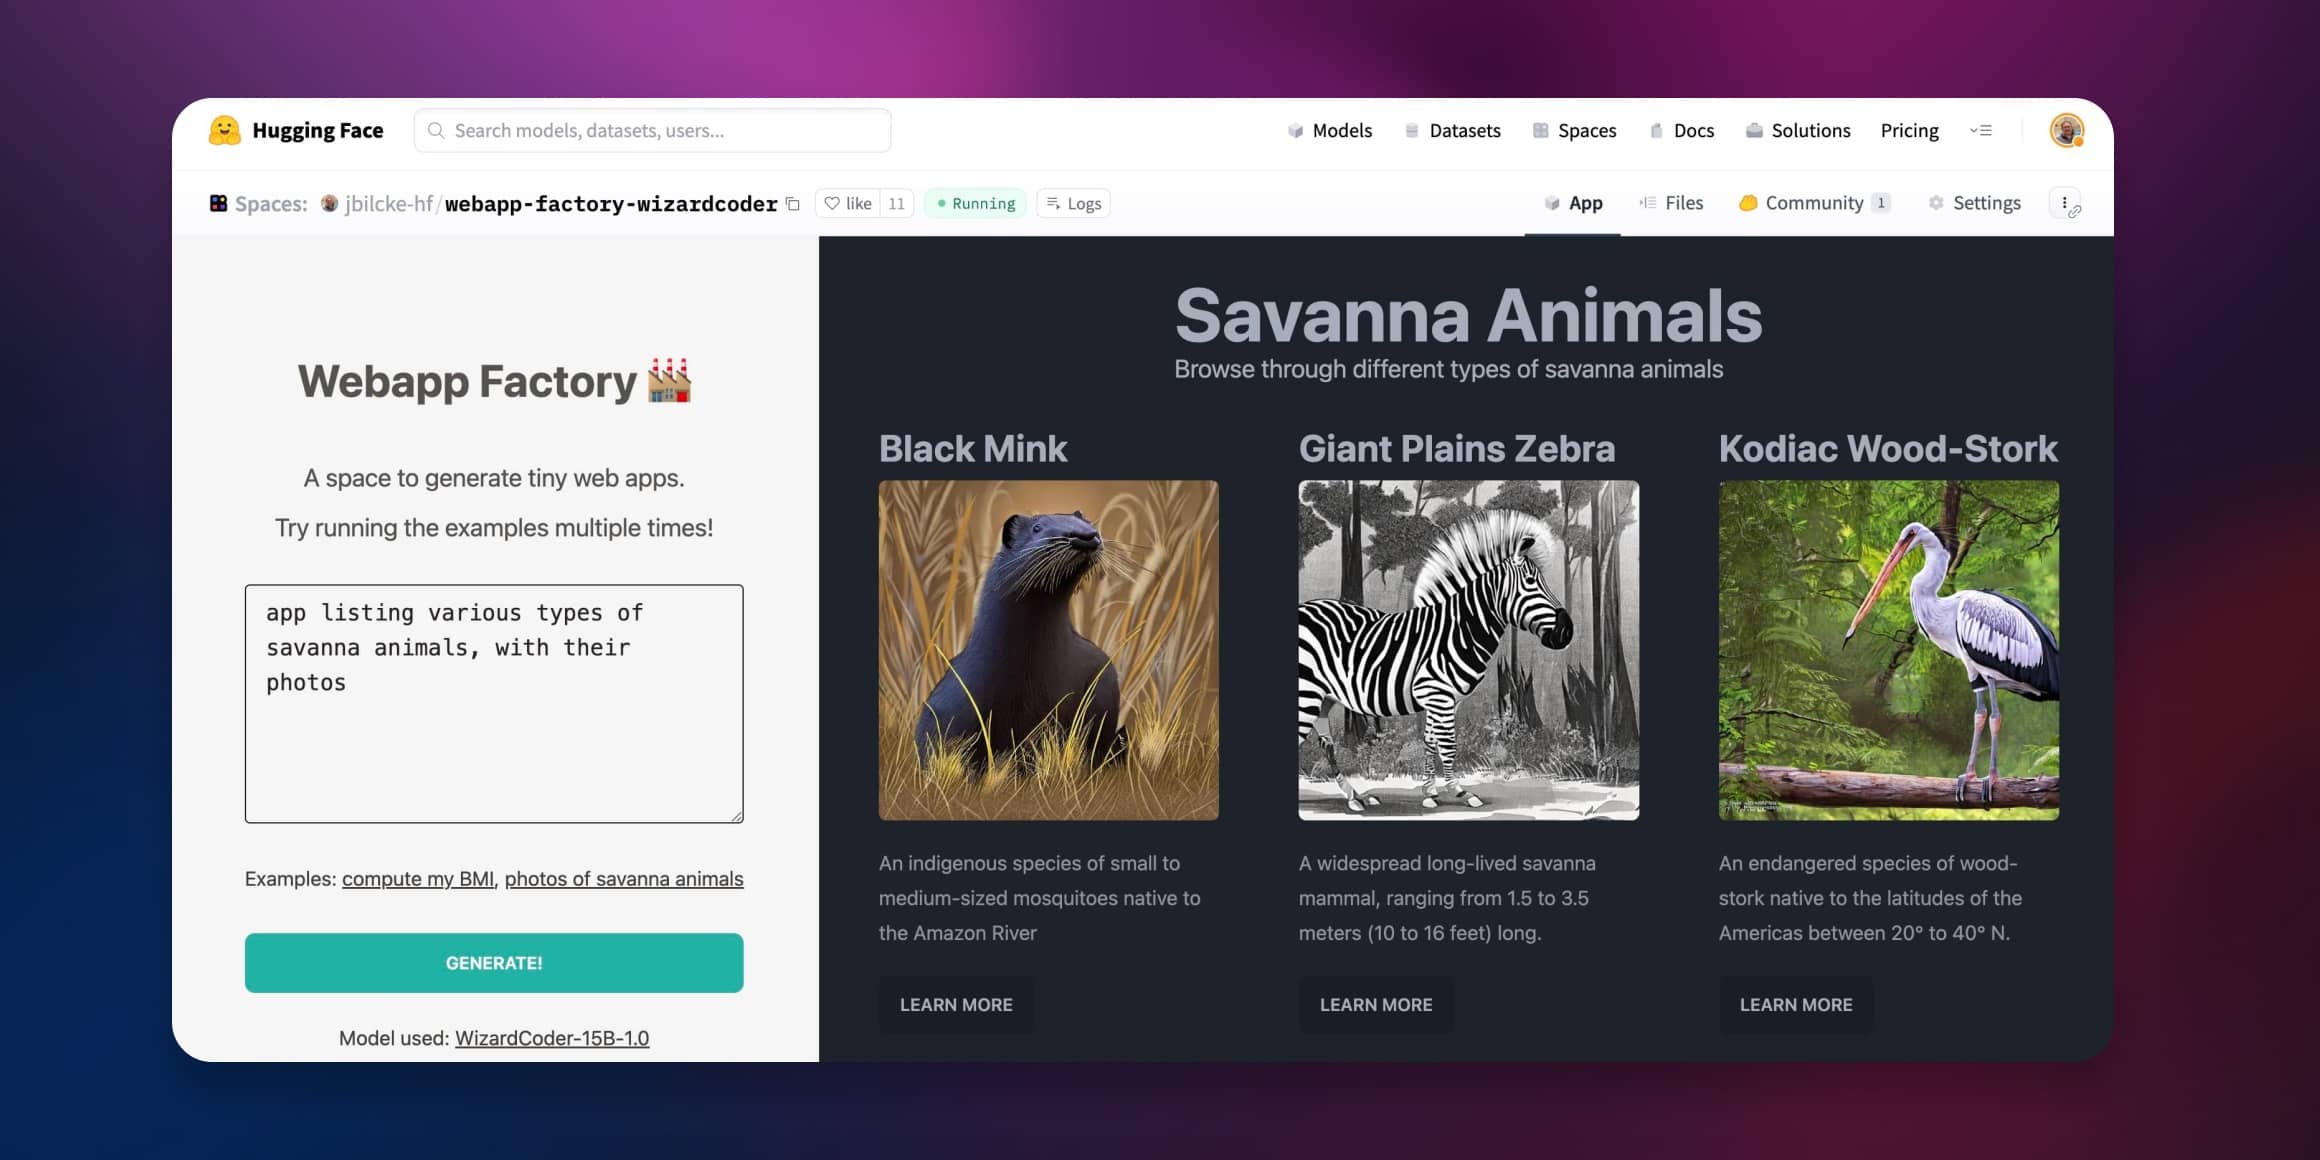
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
დიდი ენობრივი მოდელების (LLMs) ნახშირბადის კვალი: ოფიციალური ვერსიები vs. საზოგადოებრივი „ფაინ-ტიუნები“
ბოლო ერთი წლის განმავლობაში, გაიზარდა ცნობიერება იმის შესახებ, რომ დიდი ენობრივი მოდელების (LLMs) გამოყენებას ტექსტის გენერირებისთვის მნიშვნელოვანი გარემოსდაცვითი გავლენა აქვს, განსაკუთრებით ინფერენციის ფაზაში. Open LLM Leaderboard-ში ნახშირბადის ემისიების შეფასებების ინტეგრირებით, მიზანია გამჭვირვალობის უზრუნველყოფა და მოდელების შემქმნელების წახალისება, დააბალანსონ შესრულება გარემოსდაცვით პასუხისმგებლობასთან. კვლევამ გამოავლინა, რომ საზოგადოების მიერ შექმნილი „ფაინ-ტიუნები“ ხშირად უფრო ნახშირბა
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ