
ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები

Hugging Face და NVIDIA AI კვლევისთვის GPU რესურსებს ხელმისაწვდომს ხდიან „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) მეშვეობით
Hugging Face და NVIDIA აცხადებენ თანამშრომლობის შესახებ და წარმოადგენენ „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) ინიციატივას. ეს პლატფორმა მიზნად ისახავს AI-ის მკვლევრებისთვის და ორგანიზაციებისთვის GPU კლასტერებზე ხელმისაწვდომობის გაფართოებას, რათა მათ შეძლონ ხელოვნური ინტელექტის მოდელების ეფექტურად მომზადება. სერვისი გთავაზობთ მოქნილ გადახდის მოდელს, რაც რესურსების მოთხოვნისამებრ გამოყენების საშუალებას იძლევა და ამცირებს „გამოთვლითი რესურსების ხარვეზს“.
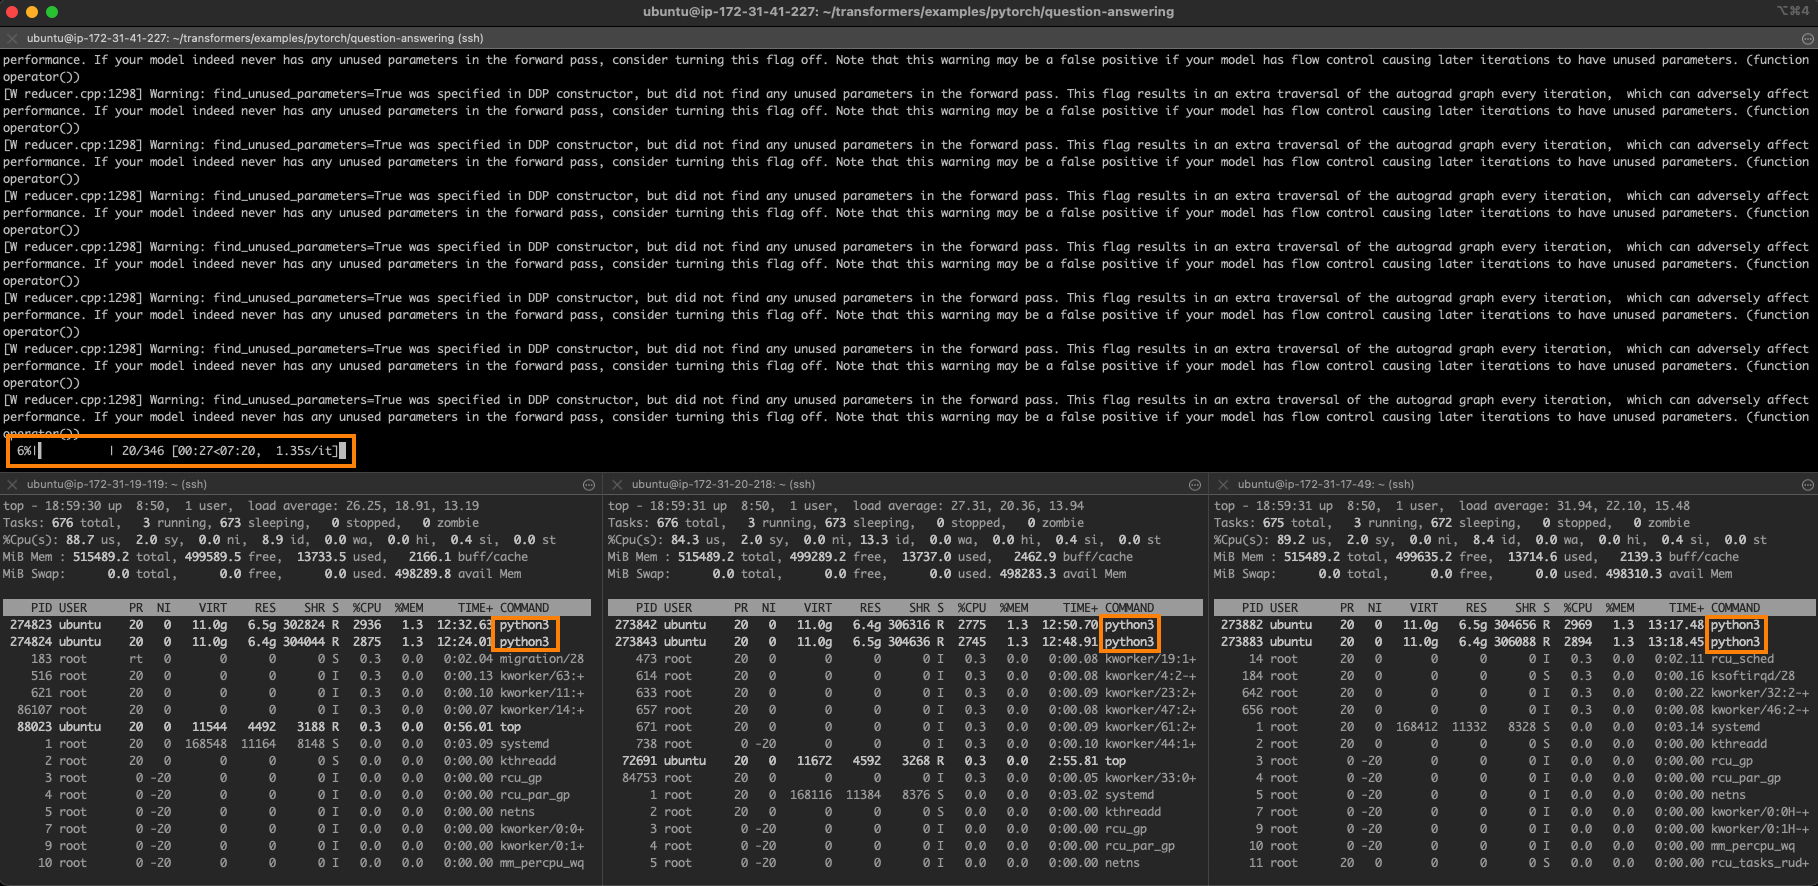
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების