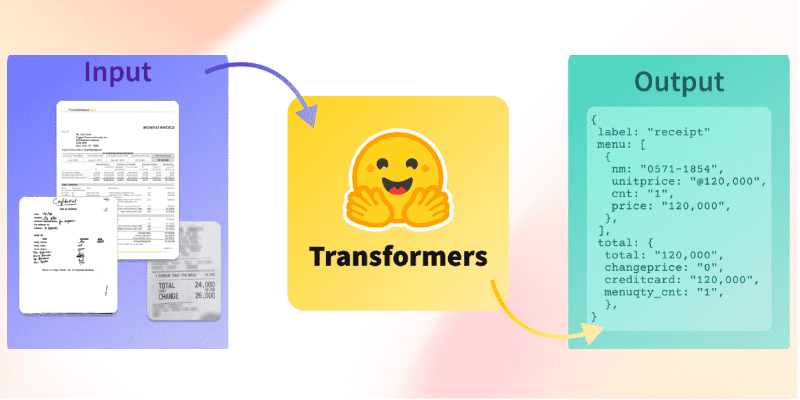
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

ამაზონი AI კონტენტის ლიცენზირების ბაზარზე შემოდის: გამომცემლებისთვის ახალი შემოსავლის წყარო?
ხელოვნური ინტელექტის (AI) ინდუსტრიაში საავტორო უფლებებთან დაკავშირებული გამოწვევების ფონზე, ამაზონი (Amazon), სავარაუდოდ, გეგმავს პლატფორმის შექმნას, სადაც გამომცემლებს შეეძლებათ თავიანთი კონტენტის AI კომპანიებისთვის ლიცენზირება. ეს ინიციატივა, რომელიც მიკროსოფტის (Microsoft) მსგავს ნაბიჯებს მიჰყვება, მიზნად ისახავს AI მოდელების სავარჯიშო მონაცემებზე (training data) წვდომის ლეგალიზებას და გამომცემლებისთვის ახალი შემოსავლის გზების გახსნას.