
დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
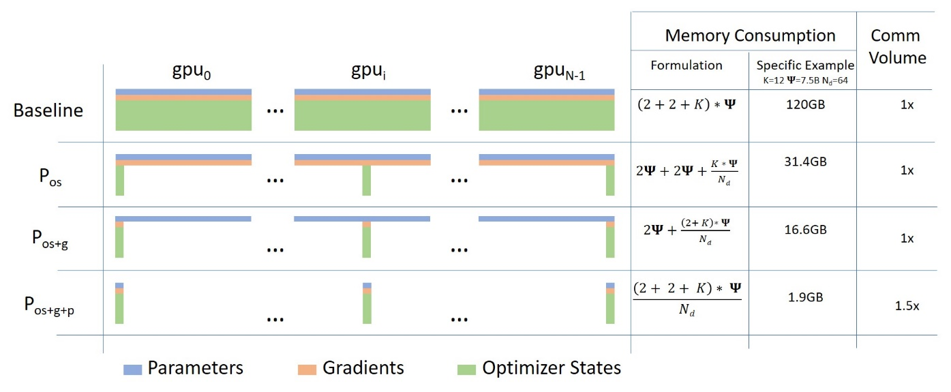
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
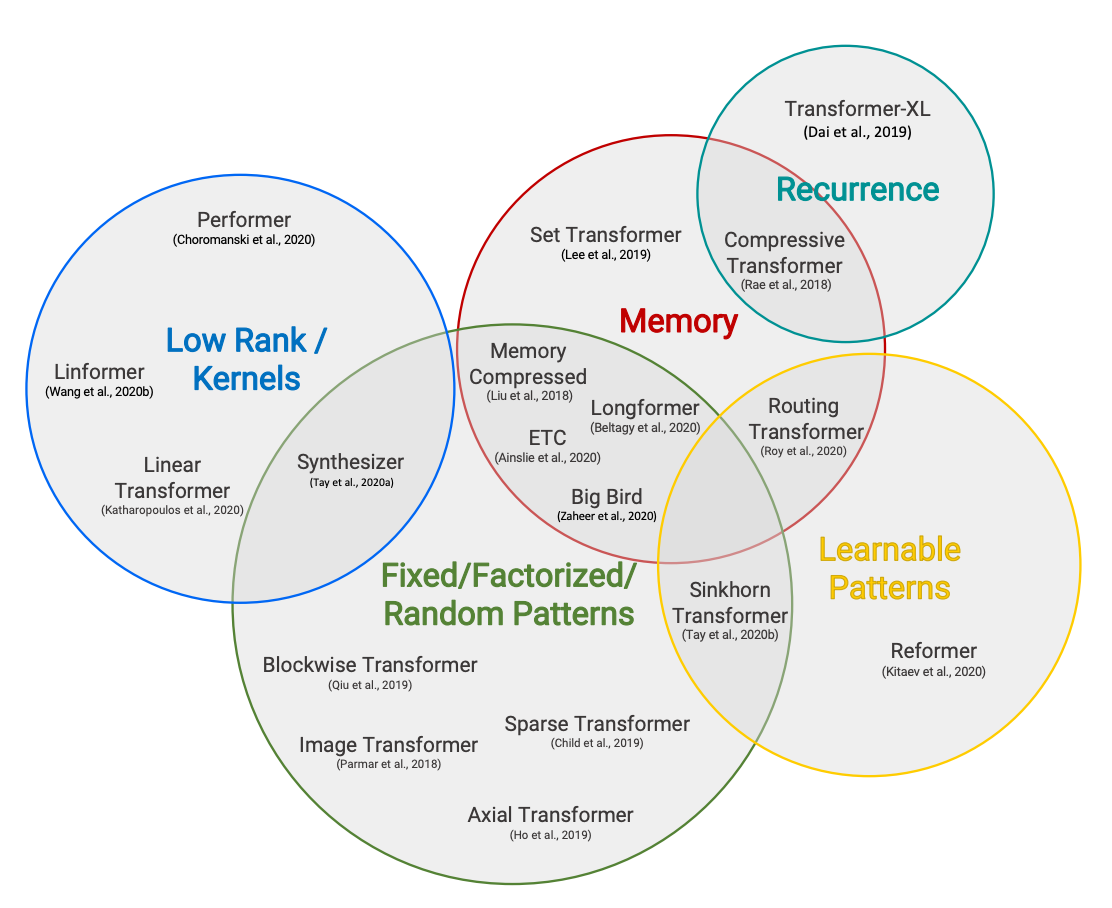
ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.

კვანტიზაციის ბეკენდები Hugging Face Diffusers-ში: მეხსიერების ოპტიმიზაცია და ხელმისაწვდომობა
ეს სტატია იკვლევს კვანტიზაციის სხვადასხვა ბეკენდს (მაგ., bitsandbytes, GGUF, torchao, Quanto, FP8) Hugging Face Diffusers-ში, რომლებიც დიდ ხელოვნური ინტელექტის მოდელებს უფრო ხელმისაწვდომს ხდის მეხსიერების მოხმარების მნიშვნელოვანი შემცირებით. ის წარმოადგენს აღქმის ტესტს, სადაც მომხმარებლებს შეუძლიათ შეადარონ ორიგინალური და კვანტიზებული მოდელების გამომუშავება განსხვავებების იდენტიფიცირებისთვის, რომლებიც ხშირად უმნიშვნელოა, განსაკუთრებით 8-ბიტიანი კვანტიზაციის დროს. სტატია ასევე დეტალურად აღწერს მე
Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.