
Sophia Space 10 მილიონ დოლარს იზიდავს კოსმოსური კომპიუტერების გაგრილების რევოლუციური მეთოდისთვის
სტატიაში განხილულია კოსმოსში მაღალეფექტური პროცესორების გაგრილების გამოწვევა ჰაერის ნაკადის არარსებობის გამო. Sophia Space-მა 10 მილიონი დოლარი მოიზიდა, რათა განავითაროს და გამოსცადოს პასიური გაგრილების ახალი მეთოდი, რომელიც იყენებს მოდულურ სერვერის თაროებს, სახელწოდებით TILES. ეს ტექნოლოგია, რომელიც თავდაპირველად Caltech-ში მზის ენერგიის პროგრამის ფარგლებში შეიქმნა, მიზნად ისახავს ორბიტაზე გამოთვლითი სიმძლავრის ეფექტურობის მნიშვნელოვან გაუმჯობესებას სხვადასხვა სატელიტური აპლიკაციებისთვის, 2030-
MIT-ის მკვლევარები LLM-ების წვრთნის სიჩქარეს აორმაგებენ გამოთვლითი რესურსების ოპტიმიზაციით
მსხვილი ენობრივი მოდელების (LLM) წვრთნა უზარმაზარ გამოთვლით რესურსებს მოითხოვს, თუმცა პროცესის არაეფექტურობის გამო პროცესორების ნაწილი ხშირად უქმად რჩება. MIT-ის მკვლევარებმა შეიმუშავეს მეთოდი, რომელიც ამ გამოუყენებელ დროს იყენებს უფრო პატარა, სწრაფი მოდელის საწვრთნელად. ეს პატარა მოდელი წინასწარმეტყველებს დიდი LLM-ის გამომუშავებას, რასაც შემდეგ დიდი მოდელი ამოწმებს. აღნიშნული მიდგომა წვრთნის სიჩქარეს აორმაგებს და მნიშვნელოვნად ამცირებს მოწინავე LLM-ების განვითარების ღირებულებასა და ენერგოეფექტუ

MatX-მა 500 მილიონი დოლარის ინვესტიცია მოიზიდა Nvidia-სთვის კონკურენციის გასაწევად AI ჩიპების ბაზარზე
Google-ის ყოფილი ინჟინრების მიერ დაარსებულმა ჩიპების სტარტაპმა MatX-მა 500 მილიონი დოლარის სერია B დაფინანსება მოიზიდა Jane Street-ისა და Situational Awareness-ისგან. კომპანიის მიზანია შექმნას პროცესორები, რომლებიც 10-ჯერ უფრო ეფექტური იქნება დიდი ენობრივი მოდელების (LLM) წვრთნაში, ვიდრე Nvidia-ს გრაფიკული პროცესორები (GPU). ახალი დაფინანსება MatX-ს TSMC-თან ერთად ჩიპების წარმოებაში დაეხმარება, მათი მიწოდება კი 2027 წელს დაიწყება.

ZDNET-ის რეკომენდაციები და System76 Thelio-ს მიმოხილვა: რატომ ავირჩიე AMD Intel-ის ნაცვლად
ZDNET-ის სტატია განმარტავს სარედაქციო პოლიტიკას, ტესტირების პროცესს და დამოუკიდებელ შეფასებებს, რომლებიც საფუძვლად უდევს მათ რეკომენდაციებს, ხაზს უსვამს რეკლამირებისგან დამოუკიდებლობას. ამასთანავე, წარმოდგენილია System76-ის კომპიუტერების, კერძოდ Thelio ხაზის, პირადი მიმოხილვა, რომელიც მოიცავს 2013 წლიდან დაწყებულ გამოცდილებას, მათ შორის Intel-ის პროცესორებიდან AMD Ryzen-ზე გადასვლას და ახალი მოდელის გაუმჯობესებულ მახასიათებლებსა და შესრულებას.

Samsung Unpacked: რას უნდა ველოდოთ Galaxy S26 სერიისგან?
Samsung Unpacked-ის ღონისძიება 25 თებერვალს სან-ფრანცისკოში გაიმართება, სადაც Galaxy S26 სერიის პრეზენტაცია შედგება. მოსალოდნელია Galaxy S26 Ultra-ს, S26-ისა და S26 Plus/Edge-ის გამოშვება, განახლებული კამერებით, გაუმჯობესებული დიზაინით, M14 OLED ეკრანით, ახალი კონფიდენციალურობის ფუნქციებითა და რეგიონალური პროცესორებით (Qualcomm Snapdragon 8 Elite Gen 5 ან Exynos 2600). ასევე, წარმოდგენილი იქნება One UI 8.5.

ლოგიტების დამუშავება: უპრეცედენტო კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვახდინოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერაციის პროცესზე, პროგნოზირების ქულების მოდიფიკაციის გზით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo – მოდულური პროცესორების კრებული, რომელიც შექმნილია სპეციფიკური ამოცანებისთვის, მაგალითად, თანმიმდევრობის სიგრძის კონტროლისთვის ან საკვანძო ფრაზების დაწესებისთვის. ეს ინოვაცია მნიშვნელოვნად აფართოებს ხელოვნ
ლოგიტების დამუშავება: გაუმჯობესებული კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვიპოვოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერირების პროცესზე ალბათური განაწილების პირდაპირი მოდიფიცირებით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo — მოდულური ლოგიტების პროცესორების კოლექცია, რომელიც განკუთვნილია სპეციფიკური ამოცანებისთვის, როგორიცაა თანმიმდევრობის სიგრძის კონტროლი ან საკვანძო ფრაზების დაწესება. სტატია განმარტავს, თუ როგორ აუმჯობე
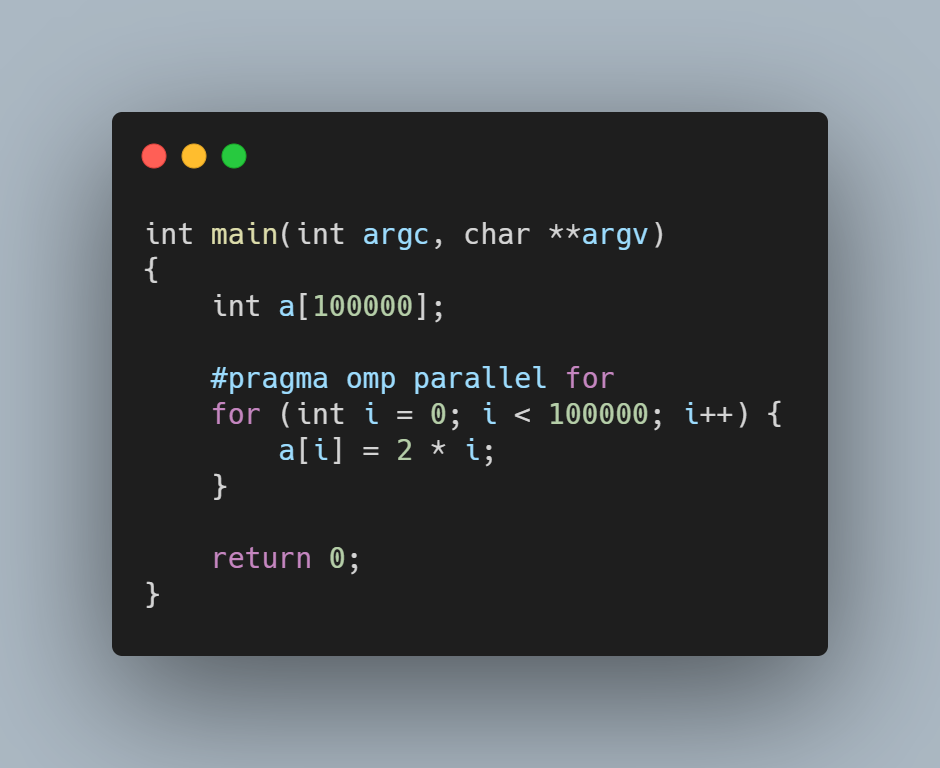
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
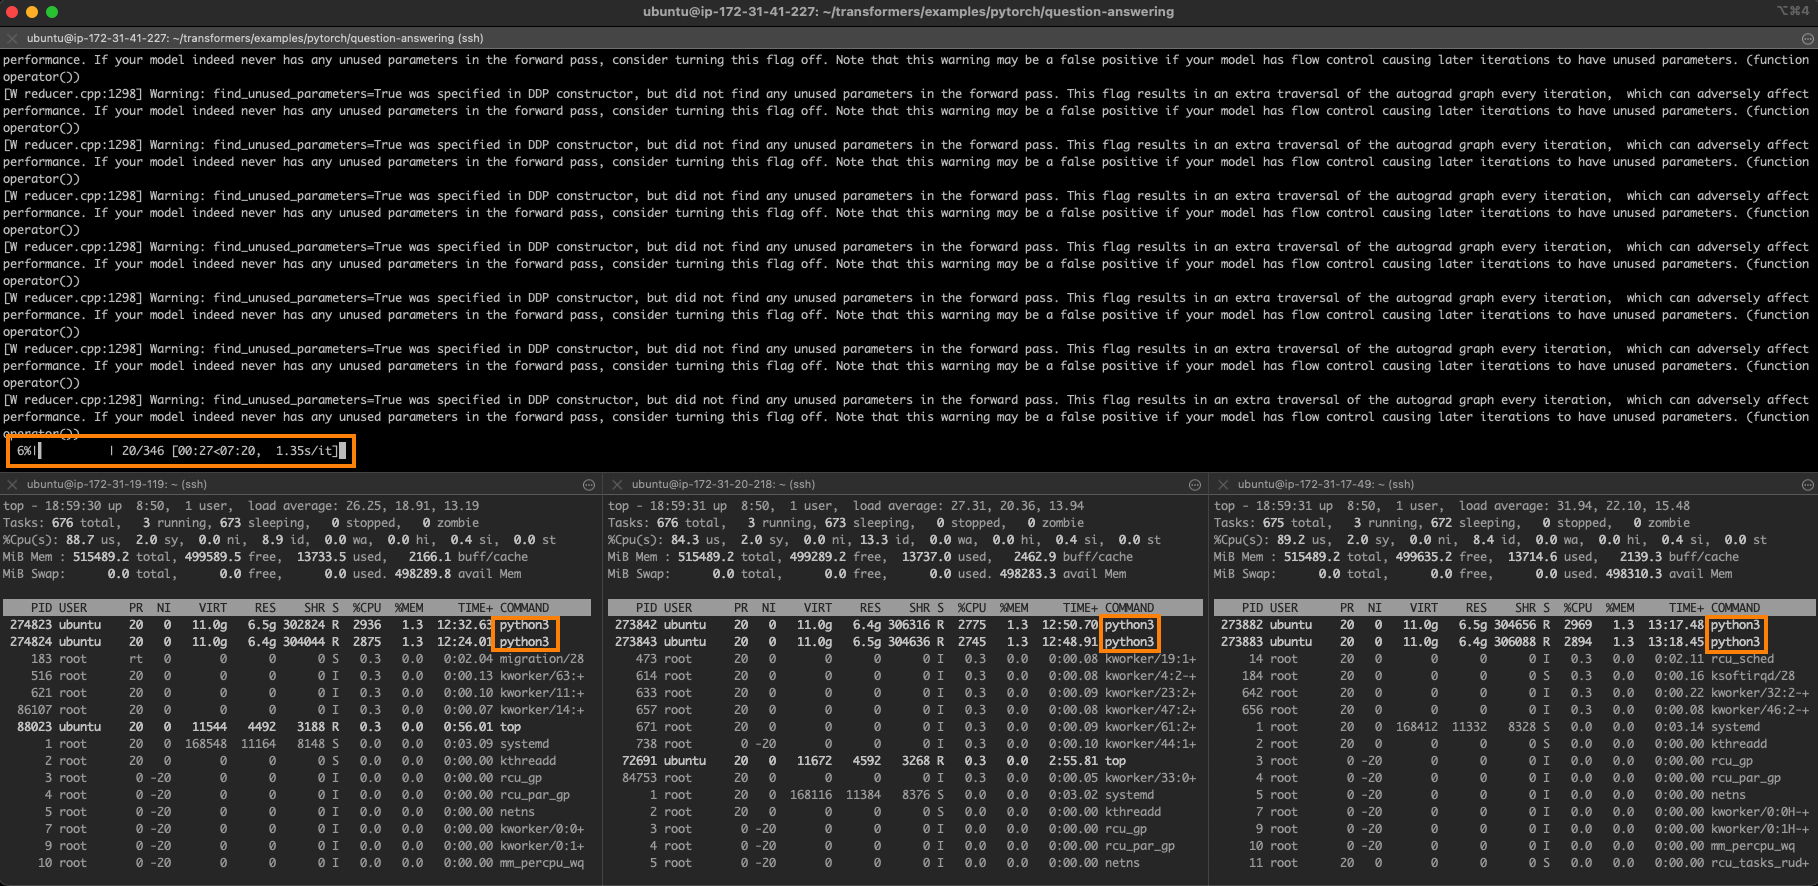
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო