Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
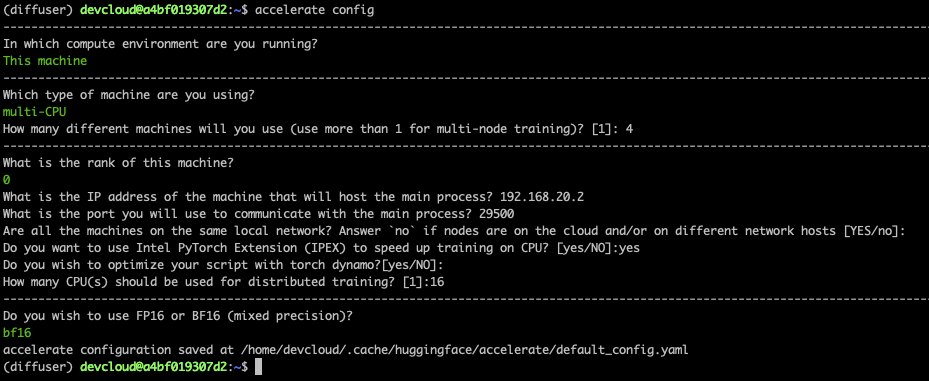
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ

Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
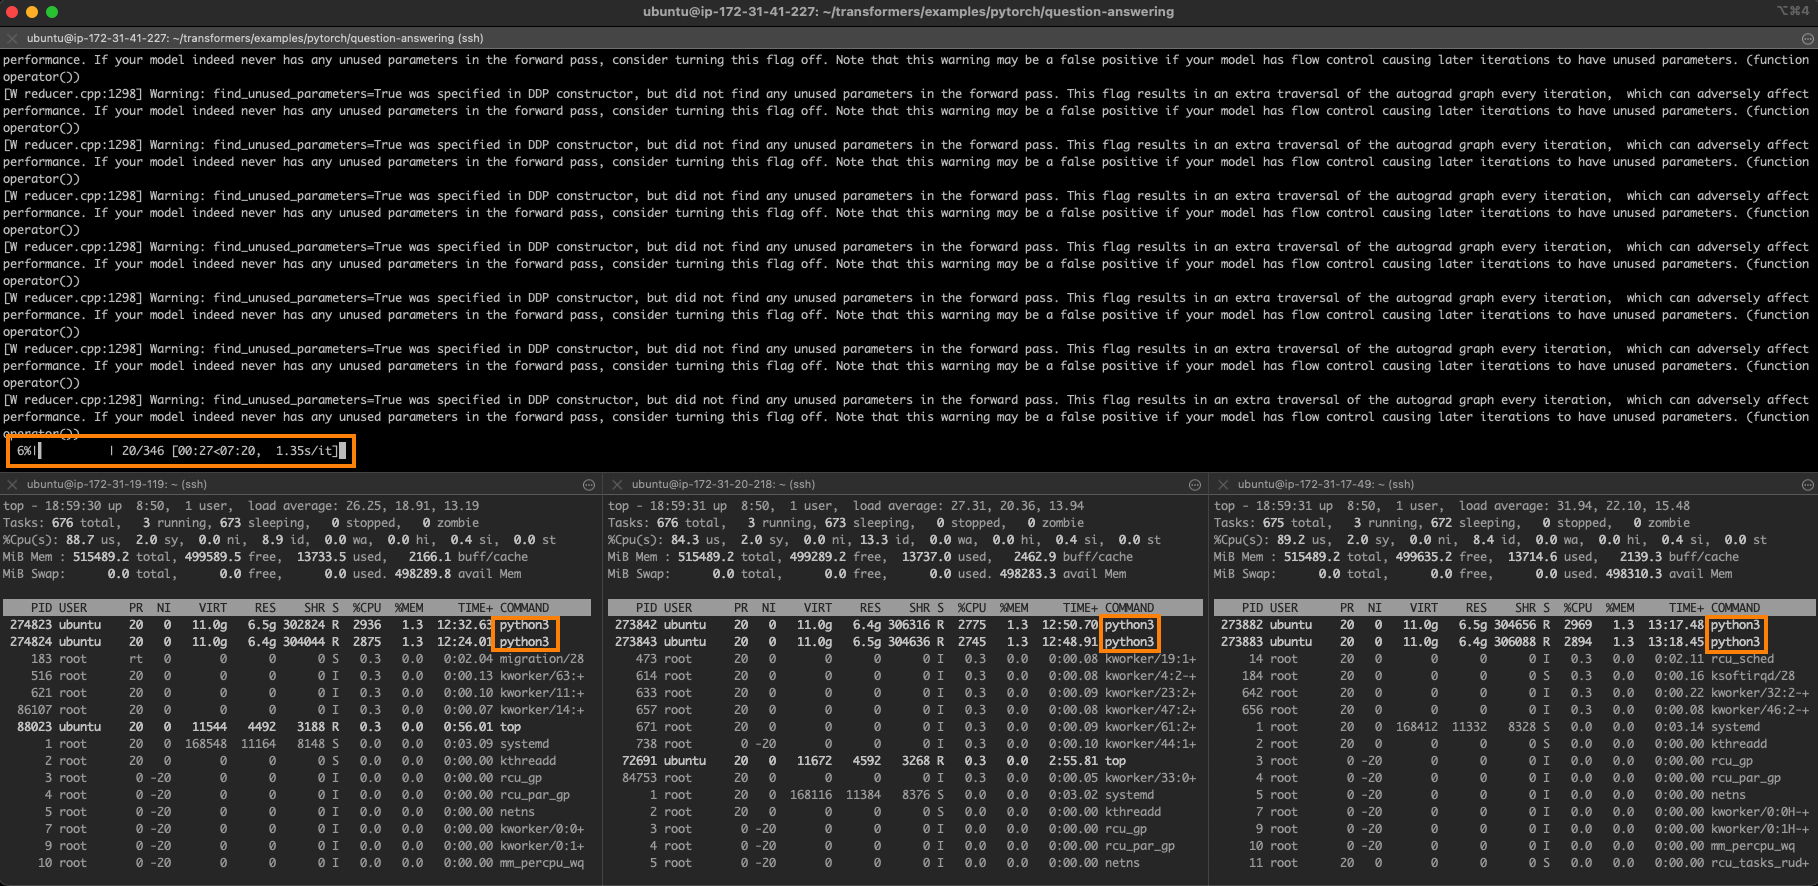
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების