TimmWrapper: PyTorch-ის გამოსახულების მოდელების ინტეგრაცია Hugging Face Transformers-თან
TimmWrapper წარმოადგენს ინსტრუმენტს, რომელიც აერთიანებს PyTorch Image Models (timm) ბიბლიოთეკას Hugging Face transformers-თან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს გამოიყენონ timm-ის თანამედროვე კომპიუტერული ხედვის მოდელების ფართო კოლექცია transformers-ის ეკოსისტემაში. ის უზრუნველყოფს ისეთ ფუნქციებს, როგორიცაა pipeline API-ის გამოყენება, Auto Classes, კვანტიზაცია და მოქნილი წვრილი მორგება (LoRA-ს ჩათვლით) ნაცნობი Trainer API-ის მეშვეობით. TimmWrapper ავსებს ამ ორ მძლავრ ბიბლიოთეკას შორი
მოწინავე ჰიპერპარამეტრების ოპტიმიზაცია Hugging Face Transformers-თან და Ray Tune-თან ერთად
მანქანური სწავლების მოდელების ეფექტურობის გასაუმჯობესებლად აუცილებელია ჰიპერპარამეტრების დარეგულირება, თუმცა ხშირად მას სათანადო ყურადღება არ ექცევა. Hugging Face Transformers-ის 3.1 ვერსიაში Hugging Face Transformers-მა და Ray Tune-მა გააერთიანეს ძალები, რათა შემოგვთავაზონ მარტივი, მაგრამ მძლავრი ინტეგრაცია. ეს გადაწყვეტა უზრუნველყოფს მოწინავე ოპტიმიზაციის ალგორითმებზე მარტივ წვდომას, როგორიცაა PBT, HyperBand და ბაიესური ოპტიმიზაცია, რაც მნიშვნელოვნად აუმჯობესებს მოდელების მუშაობას და ინარჩუნებ
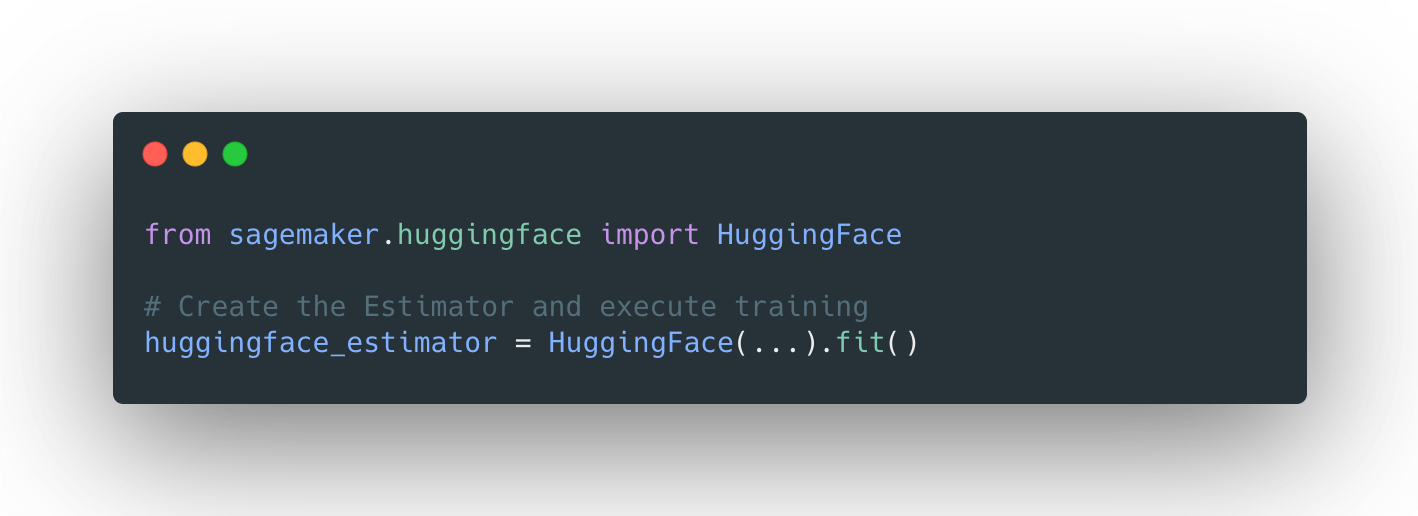
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ
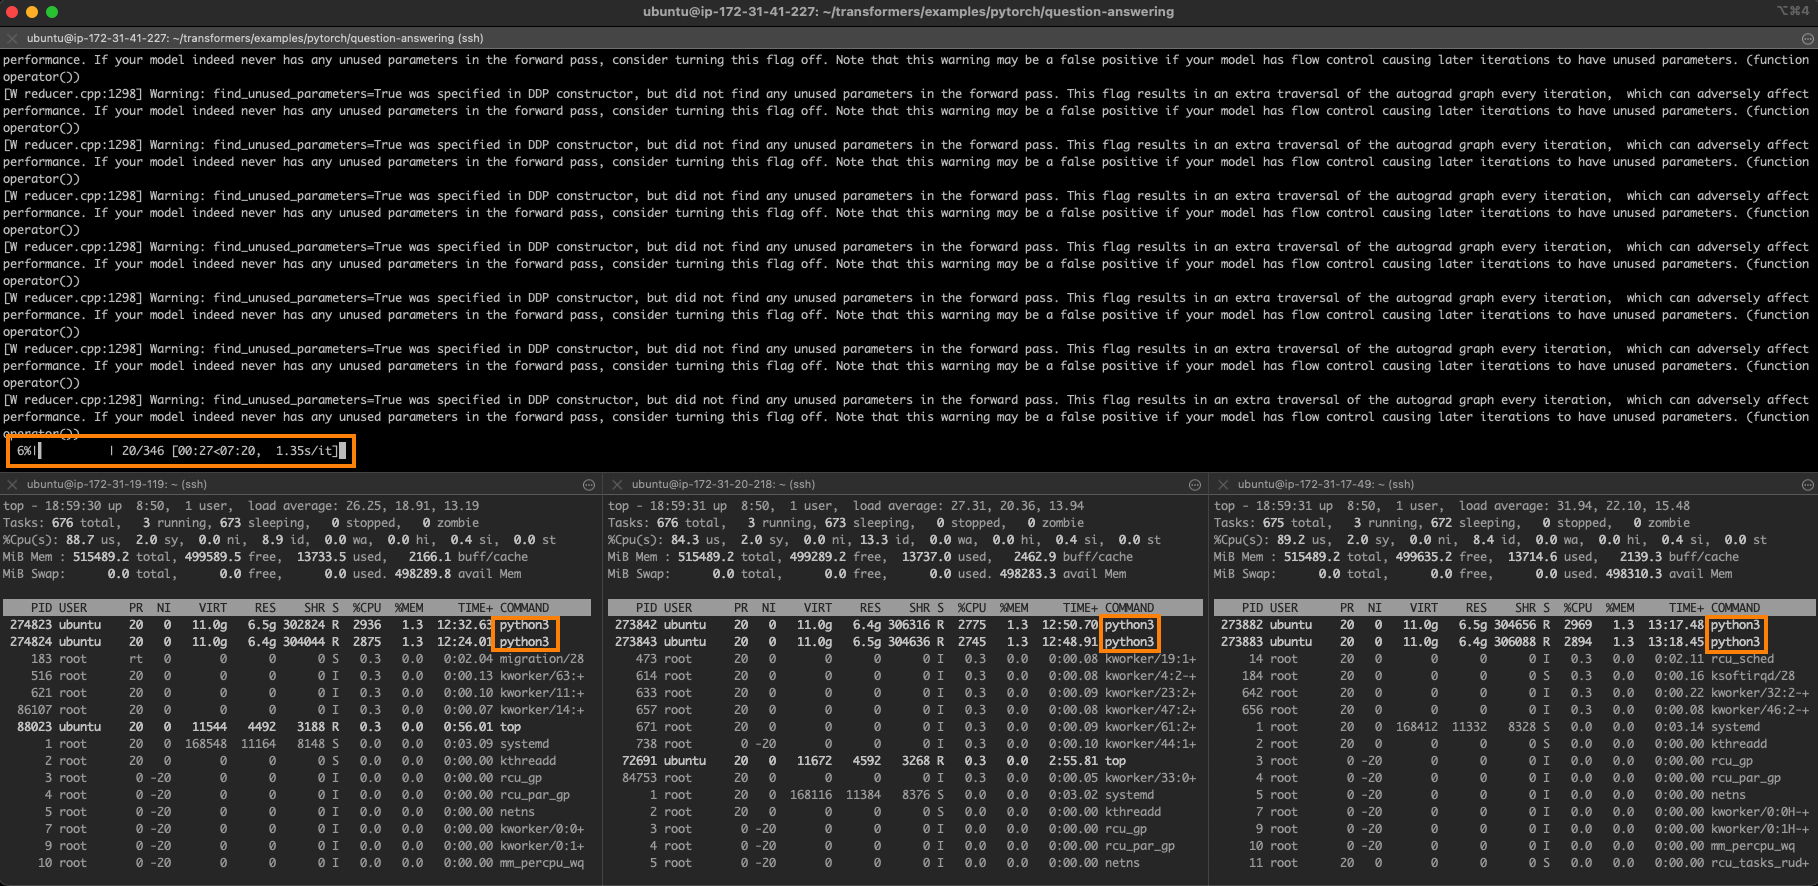
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო