
ModernBERT: ენკოდერ-მხოლოდ მოდელების ახალი ეპოქა – BERT-ის გაუმჯობესებული და სწრაფი ჩანაცვლება
ModernBERT წარმოადგენს უახლეს, სახელმწიფოებრივ ენკოდერ-მხოლოდ მოდელების ოჯახს, რომელიც მნიშვნელოვნად აუმჯობესებს წინა თაობის ენკოდერებს სიჩქარის, სიზუსტის, კონტექსტის სიგრძის (8192 ტოკენი) და ქვემდებარე ამოცანების შესრულების მხრივ. ის დანერგილია, როგორც BERT-ის პირდაპირი ჩანაცვლება, ხელმისაწვდომია საბაზისო (149M პარამეტრი) და დიდ (395M პარამეტრი) ვერსიებში და აერთიანებს LLM-ების უახლეს მიღწევებს. ModernBERT მიზნად ისახავს გახდეს ახალი სტანდარტი პრაქტიკულ გამოყენებებში, როგორიცაა RAG სისტემები, კ
EsperBERTo: ხელოვნური ინტელექტის მოდელის შექმნა და ტრენინგი ესპერანტოზე
ამ პოსტში წარმოდგენილია, თუ როგორ ხდება ხელოვნური ინტელექტის მცირე ენობრივი მოდელის, EsperBERTo-ს, შექმნა და ტრენინგი ესპერანტოზე. მოდელი, რომელიც ზომით DistilBERT-ის მსგავსია, იყენებს სპეციალურად ოპტიმიზებულ ტოკენიზატორს და შემდგომში ადაპტირდება სიტყვის ნაწილების ამოცნობის ამოცანისთვის. ესპერანტო, როგორც ხელოვნური და ადვილად სასწავლი ენა, შერჩეულია დემონსტრაციისთვის, რათა ნათლად გამოჩნდეს მოდელის შესაძლებლობები.
Reformer მოდელი: მეხსიერება-ეფექტური ტრანსფორმერული არქიტექტურა გრძელი მიმდევრობების მოდელირებისთვის
კიტაევის, კაიზერისა და სხვების (2020) მიერ შემოთავაზებული Reformer მოდელი წარმოადგენს ერთ-ერთ ყველაზე მეხსიერება-ეფექტურ ტრანსფორმერულ არქიტექტურას გრძელი მიმდევრობების მოდელირებისთვის. NLP ამოცანების (მაგ. რეფერირება, კითხვა-პასუხის სისტემები) მზარდი მოთხოვნების დასაკმაყოფილებლად, Reformer-ს შეუძლია ნახევარ მილიონამდე ტოკენის დამუშავება, მაშინ როცა სტანდარტული BERT მოდელები 512 ტოკენით შემოიფარგლებიან. მისი არქიტექტურის თითოეული ნაწილი გადაკეთებულია მინიმალური მეხსიერების მოთხოვნილების ოპტიმიზა
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
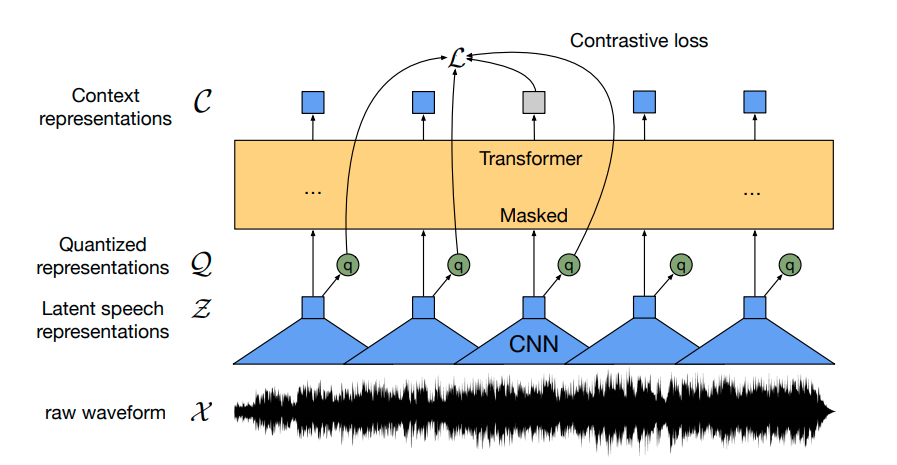
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
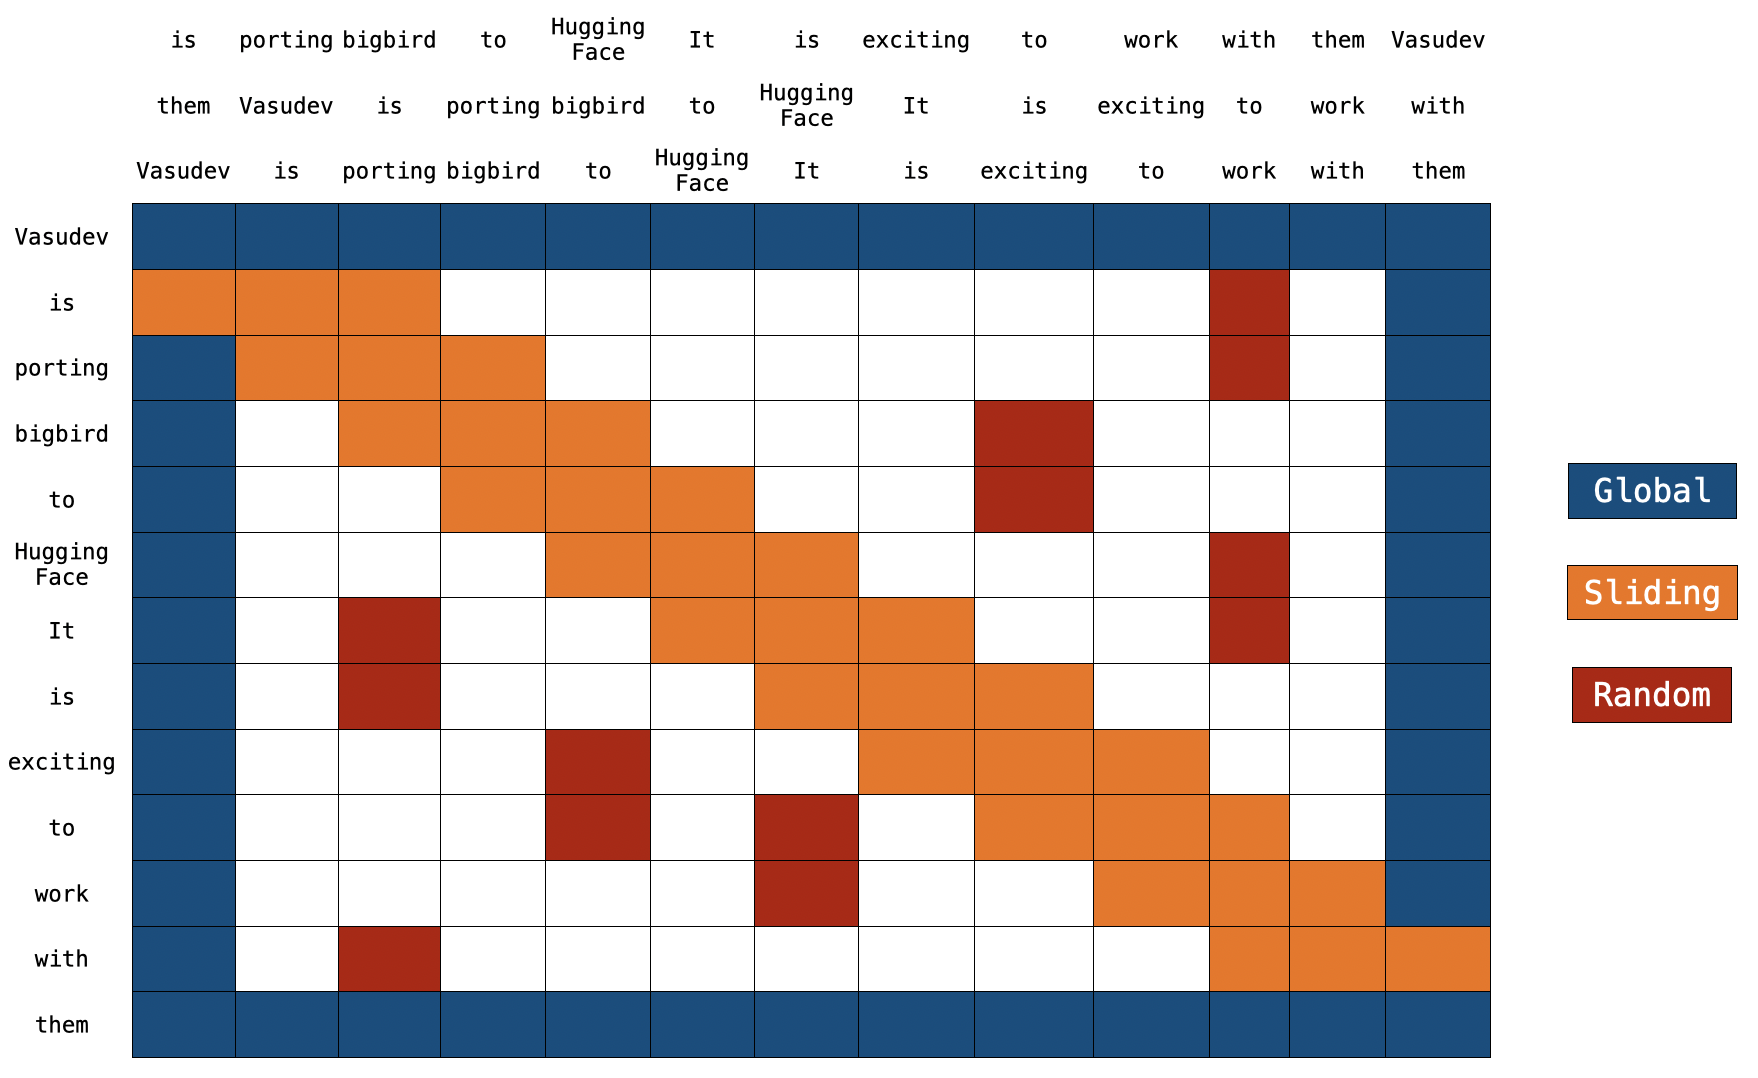
BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ
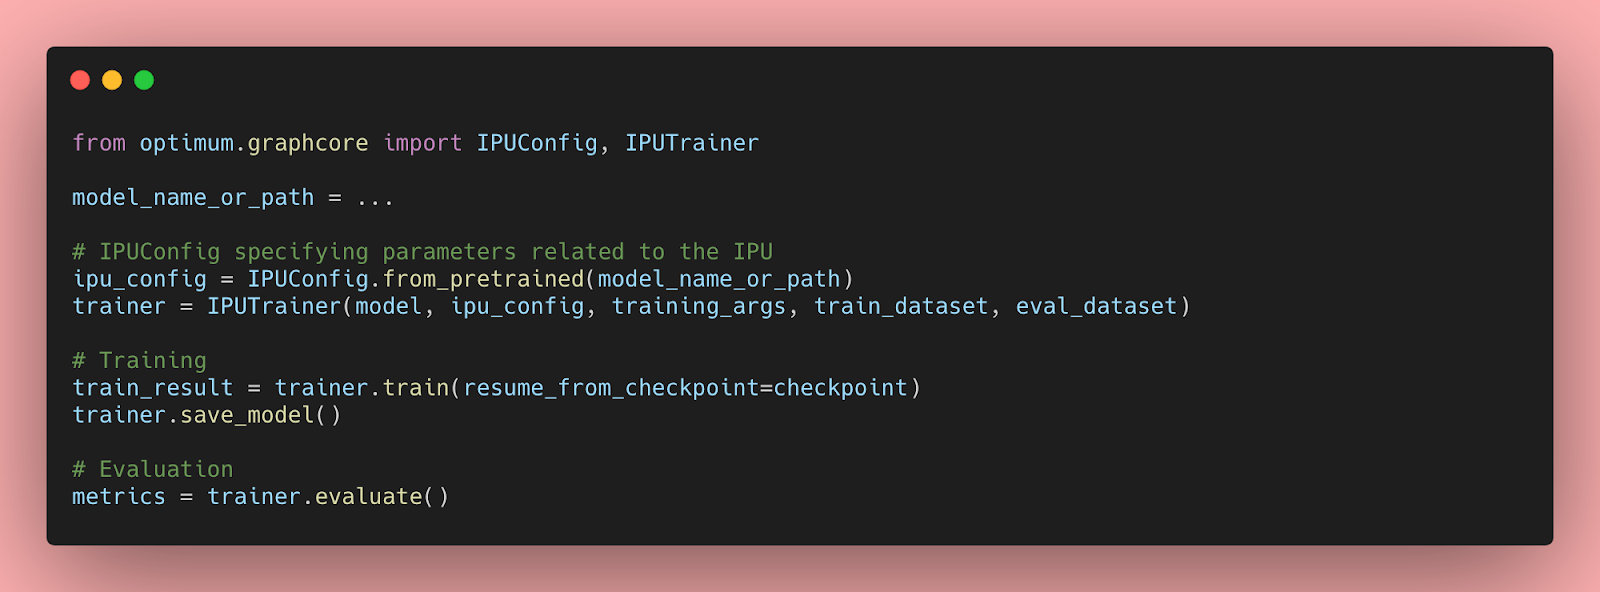
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ
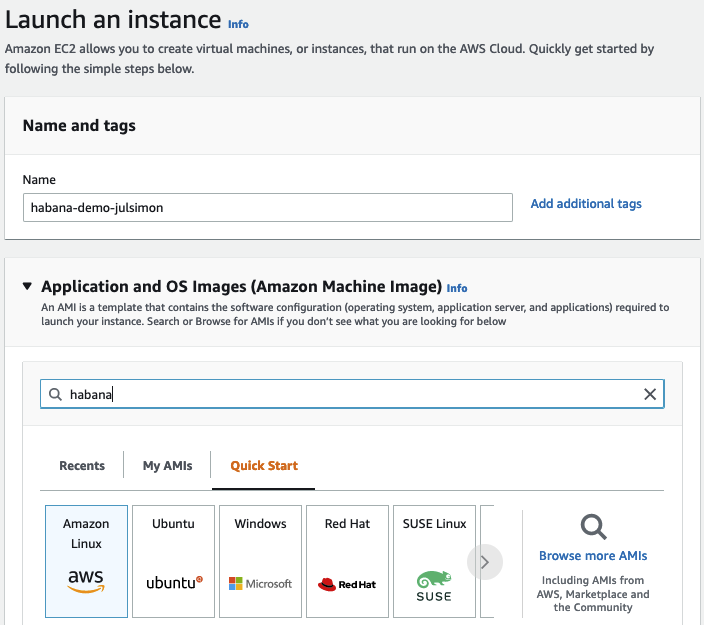
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა