
ZDNET-ის მიმოხილვა: Lenovo ThinkPad P1 (მე-8 თაობა) - პროფესიონალური სამუშაო სადგურის ეტალონი
ZDNET მკითხველებს სთავაზობს დამოუკიდებელ, ტესტირებასა და კვლევაზე დაფუძნებულ რეკომენდაციებს, მკაცრი სარედაქციო სტანდარტებით, რათა დაეხმაროს მათ ჭკვიანი შესყიდვების მიღებაში. ამ სტატიაში განხილულია Lenovo ThinkPad P1-ის მე-8 თაობა, მძლავრი და პორტატული სამუშაო სადგური, რომელიც აღჭურვილია Intel Core Ultra 9 255H CPU-ით, Nvidia RTX PRO 2000 GPU-ით და ინოვაციური LPCAMM2 მეხსიერებით. P1-მა მიიღო ZDNET-ის რედაქტორის არჩევანის ჯილდო თავისი 16-ინჩიანი OLED დისპლეის, მძლავრი აპარატურის, საწარმოსთვის განკ

მეტა $100 მილიარდ დოლარამდე ღირებულების AMD-ის ჩიპებს შეიძენს ხელოვნური ინტელექტის ინფრასტრუქტურისთვის
ტექნოლოგიურმა გიგანტმა „მეტამ“ და „AMD“-მ მრავალწლიანი შეთანხმება გააფორმეს, რომლის ფარგლებშიც „მეტა“ $100 მილიარდ დოლარამდე ღირებულების „AMD“-ის ჩიპებს შეიძენს. ეს შესყიდვა, რომელიც MI540 სერიის GPU-ებსა და უახლესი თაობის CPU-ებს მოიცავს, მიზნად ისახავს „მეტას“ ხელოვნური ინტელექტის მონაცემთა ცენტრების გაძლიერებას და „Nvidia“-ზე დამოკიდებულების შემცირებას. შეთანხმება ასევე მოიცავს „AMD“-ის აქციების 160 მილიონამდე წილის შეძენის ვარანტს.

ZDNET-ის მიმოხილვა: Lenovo LOQ 15 - ხელმისაწვდომი სათამაშო ლეპტოპი
ZDNET-ის რეკომენდაციები ეფუძნება საათობით ტესტირებას, კვლევასა და პროდუქტების შედარებას, რათა მკითხველს მიაწოდოს ზუსტი და სანდო ინფორმაცია ჭკვიანი შესყიდვების გასაკეთებლად. სტატია აფასებს Lenovo LOQ 15 ლეპტოპს, რომელიც წარმოადგენს საშუალო კლასის, ბიუჯეტურ სათამაშო მოწყობილობას AMD Ryzen 7 CPU-ით, RTX 5050 GPU-ით, 16GB RAM-ით და 1TB მეხსიერებით. მიუხედავად იმისა, რომ ლეპტოპი არ არის მაღალი კლასის მოდელი და აქვს შედარებით თავშეკავებული დიზაინი, ის მაინც უზრუნველყოფს საიმედო შესრულებას ყოველდღიური
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის
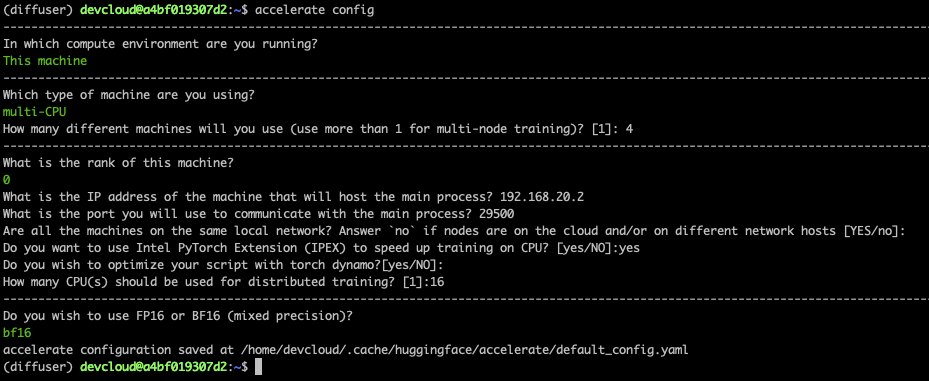
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
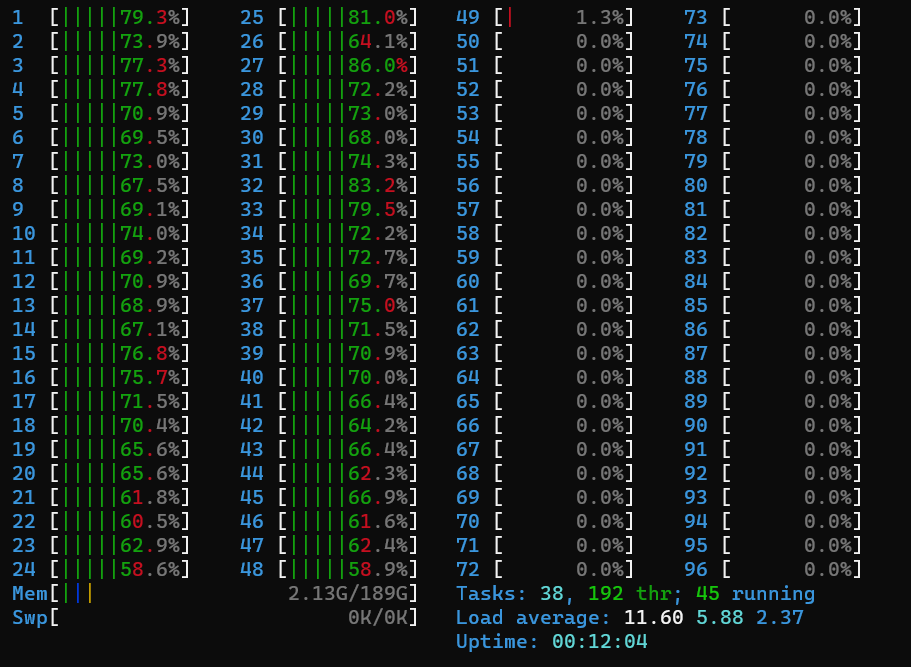
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ
SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.

Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug
Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.