
ZDNET-ის მიმოხილვა: Lenovo ThinkPad P1 (მე-8 თაობა) - პროფესიონალური სამუშაო სადგურის ეტალონი
ZDNET მკითხველებს სთავაზობს დამოუკიდებელ, ტესტირებასა და კვლევაზე დაფუძნებულ რეკომენდაციებს, მკაცრი სარედაქციო სტანდარტებით, რათა დაეხმაროს მათ ჭკვიანი შესყიდვების მიღებაში. ამ სტატიაში განხილულია Lenovo ThinkPad P1-ის მე-8 თაობა, მძლავრი და პორტატული სამუშაო სადგური, რომელიც აღჭურვილია Intel Core Ultra 9 255H CPU-ით, Nvidia RTX PRO 2000 GPU-ით და ინოვაციური LPCAMM2 მეხსიერებით. P1-მა მიიღო ZDNET-ის რედაქტორის არჩევანის ჯილდო თავისი 16-ინჩიანი OLED დისპლეის, მძლავრი აპარატურის, საწარმოსთვის განკ

GNOME 50: ნელი ევოლუცია და მნიშვნელოვანი სიახლეები 'კაპოტის ქვეშ'
GNOME-ის ევოლუცია ნელი, თუმცა თანმიმდევრული პროცესია. GNOME 50-ის უახლესი ვერსია დრამატული ინტერფეისის ცვლილებების ნაცვლად, მნიშვნელოვან შიდა გაუმჯობესებებს გვთავაზობს. ძირითადი სიახლეები მოიცავს X11-ის ოფიციალურ ჩანაცვლებას Wayland-ით, ფრაქციულ სკალირებას, GPU-ს გაუმჯობესებულ დეტექციას, Orca ეკრანის წამკითხველის განახლებებს და systemd-homed-ის დანერგვას. გამოცემის ფილოსოფია არსებულის დახვეწასა და ძირითადი ფუნქციების გაუმჯობესებაზეა ორიენტირებული, რათა უზრუნველყოფილი იყოს უკეთესი წარმადობა, უსაფ

Nvidia-მ რეკორდული მოგება დააფიქსირა ხელოვნური ინტელექტის მოთხოვნის მკვეთრი ზრდის ფონზე
ჩიპების გიგანტმა Nvidia-მ ბოლო კვარტალში რეკორდული მოგება და შემოსავლები დააფიქსირა, რაც ხელოვნური ინტელექტის გამოთვლით სიმძლავრეებზე უპრეცედენტო მოთხოვნით არის განპირობებული. კომპანიის აღმასრულებელმა დირექტორმა, ჯენსენ ჰუანგმა, აღნიშნა „ტოკენებზე“ ექსპონენციალური ზრდა და ხაზი გაუსვა, რომ მათი GPU-ები სრულად მოხმარებულია. Nvidia-მ ასევე განიხილა OpenAI-ში მოსალოდნელი ინვესტიცია და ჩინეთში ექსპორტის შეზღუდვებთან დაკავშირებული გამოწვევები.

MatX-მა 500 მილიონი დოლარის ინვესტიცია მოიზიდა Nvidia-სთვის კონკურენციის გასაწევად AI ჩიპების ბაზარზე
Google-ის ყოფილი ინჟინრების მიერ დაარსებულმა ჩიპების სტარტაპმა MatX-მა 500 მილიონი დოლარის სერია B დაფინანსება მოიზიდა Jane Street-ისა და Situational Awareness-ისგან. კომპანიის მიზანია შექმნას პროცესორები, რომლებიც 10-ჯერ უფრო ეფექტური იქნება დიდი ენობრივი მოდელების (LLM) წვრთნაში, ვიდრე Nvidia-ს გრაფიკული პროცესორები (GPU). ახალი დაფინანსება MatX-ს TSMC-თან ერთად ჩიპების წარმოებაში დაეხმარება, მათი მიწოდება კი 2027 წელს დაიწყება.

მეტა $100 მილიარდ დოლარამდე ღირებულების AMD-ის ჩიპებს შეიძენს ხელოვნური ინტელექტის ინფრასტრუქტურისთვის
ტექნოლოგიურმა გიგანტმა „მეტამ“ და „AMD“-მ მრავალწლიანი შეთანხმება გააფორმეს, რომლის ფარგლებშიც „მეტა“ $100 მილიარდ დოლარამდე ღირებულების „AMD“-ის ჩიპებს შეიძენს. ეს შესყიდვა, რომელიც MI540 სერიის GPU-ებსა და უახლესი თაობის CPU-ებს მოიცავს, მიზნად ისახავს „მეტას“ ხელოვნური ინტელექტის მონაცემთა ცენტრების გაძლიერებას და „Nvidia“-ზე დამოკიდებულების შემცირებას. შეთანხმება ასევე მოიცავს „AMD“-ის აქციების 160 მილიონამდე წილის შეძენის ვარანტს.

ZDNET-ის მიმოხილვა: Samsung Galaxy Book6 Ultra – გაუმჯობესება თუ იმედგაცრუება?
ZDNET-ის სარედაქციო გუნდი წარმოგიდგენთ Samsung-ის უახლესი ფლაგმანი ლეპტოპის, Galaxy Book6 Ultra-ს დეტალურ მიმოხილვას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და კვლევაზე. სტატია განმარტავს ZDNET-ის მიუკერძოებელ სარედაქციო პრინციპებს და შემდეგ აფასებს Galaxy Book6 Ultra-ს, ხაზს უსვამს მის გაუმჯობესებულ მახასიათებლებს, როგორიცაა Intel-ის უახლესი პროცესორი, RTX 5070 GPU, განახლებული აუდიო სისტემა და შესანიშნავი AMOLED 3K დისპლეი, რომელიც წინა ვერსიიდან გადმოვიდა. მიუხედავად იმისა, რომ ლეპტოპ

ZDNET-ის მიმოხილვა: Lenovo LOQ 15 - ხელმისაწვდომი სათამაშო ლეპტოპი
ZDNET-ის რეკომენდაციები ეფუძნება საათობით ტესტირებას, კვლევასა და პროდუქტების შედარებას, რათა მკითხველს მიაწოდოს ზუსტი და სანდო ინფორმაცია ჭკვიანი შესყიდვების გასაკეთებლად. სტატია აფასებს Lenovo LOQ 15 ლეპტოპს, რომელიც წარმოადგენს საშუალო კლასის, ბიუჯეტურ სათამაშო მოწყობილობას AMD Ryzen 7 CPU-ით, RTX 5050 GPU-ით, 16GB RAM-ით და 1TB მეხსიერებით. მიუხედავად იმისა, რომ ლეპტოპი არ არის მაღალი კლასის მოდელი და აქვს შედარებით თავშეკავებული დიზაინი, ის მაინც უზრუნველყოფს საიმედო შესრულებას ყოველდღიური

AI ინფრასტრუქტურის ფარული ხარჯი: მეხსიერების გაზრდილი როლი და სირთულე
AI ინფრასტრუქტურის ხარჯებზე საუბრისას ძირითადად Nvidia-სა და GPU-ებზეა ფოკუსირება, თუმცა მეხსიერება სულ უფრო მნიშვნელოვანი ნაწილი ხდება. DRAM ჩიპების ფასი ბოლო წელს დაახლოებით 7-ჯერ გაიზარდა. მეხსიერების ეფექტური მართვა გადამწყვეტია AI მოდელებისთვის, რადგან ის საშუალებას აძლევს კომპანიებს, შეამცირონ ტოკენების გამოყენება და ოპერაციული ხარჯები. ის, ვინც ამ სფეროს დაეუფლება, მნიშვნელოვან უპირატესობას მოიპოვებს.

ინდურმა AI სტარტაპმა Neysa-მ Blackstone-ისგან 600 მილიონი დოლარის ინვესტიცია მოიზიდა
ინდურმა ხელოვნური ინტელექტის (AI) ინფრასტრუქტურის სტარტაპმა Neysa-მ აშშ-ის კერძო საინვესტიციო ფირმა Blackstone-ისა და სხვა თანაინვესტორებისგან 600 მილიონ დოლარამდე ძირითადი კაპიტალის ინვესტიცია მოიზიდა, რის შედეგადაც Blackstone-მა კომპანიაში უმრავლესი წილი მოიპოვა. ეს დაფინანსება Neysa-ს საშუალებას მისცემს სწრაფად გააფართოოს თავისი GPU-ზე დაფუძნებული გამოთვლითი სიმძლავრეები ინდოეთში, რითაც უპასუხებს ხელოვნური ინტელექტის გამოთვლებზე გლობალურ მზარდ მოთხოვნას და მხარს დაუჭერს ინდოეთის ამბიციას, გან

ხელოვნურმა ინტელექტმა CUDA ქერნელების წერა ისწავლა: ახალი უნარი GPU პროგრამირებას ამარტივებს
შემუშავდა ხელოვნური ინტელექტის აგენტის ახალი უნარი, რომელიც კოდირების აგენტებს ასწავლის საწარმოო დონის CUDA ქერნელების შექმნას. ამ უნარის გამოყენებით, Claude-მა და Codex-მა წარმატებით დაწერეს ფუნქციური ქერნელები diffusers-ის კონვეიერისა და transformers-ის მოდელისთვის, მოახდინეს მათი სწორი ინტეგრაცია PyTorch-თან და ჩაატარეს წარმადობის ტესტები, რაც ადასტურებს პროცესის სრულ ავტომატიზაციას.
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
Hugging Face და FriendliAI AI მოდელების განთავსების გასაუმჯობესებლად პარტნიორობენ
Hugging Face და FriendliAI აცხადებენ სტრატეგიული პარტნიორობის შესახებ, რომელიც მიზნად ისახავს დეველოპერებისთვის AI მოდელების განთავსებისა და მართვის პროცესის გამარტივებას. ინტეგრაცია FriendliAI Endpoints-ს Hugging Face Hub-ში აერთიანებს, რაც უზრუნველყოფს მაღალეფექტურ, ეკონომიურ ინფერენციის ინფრასტრუქტურას. ეს ნაბიჯი AI ინოვაციებს უფრო ხელმისაწვდომსა და ეფექტურს გახდის მსოფლიოს მასშტაბით, ოპტიმიზებული GPU გამოყენებით და ინფრასტრუქტურის მართვის სირთულეების შემცირებით.
Stable Diffusion XL სამომხმარებლო აპარატურაზე: მოდელის ზომისა და მუშაობის ოპტიმიზაციის ახალი გზები
Stable Diffusion XL (SDXL) დიდი ზომის მოდელია, თუმცა მისი გაშვება უკვე შესაძლებელია 16 GB GPU RAM-ის მქონე CUDA აპარატურაზე, მათ შორის Colab-ის უფასო ვერსიაზეც. ბოლო თვეებში გაიზარდა ინტერესი ML მოდელების ადგილობრივად გაშვების მიმართ, რაც განპირობებულია კონფიდენციალურობითა და მოხერხებულობით. Apple-მა და Hugging Face-მა წარმოადგინეს SDXL-ის Core ML ვერსია, რომელიც ღია წყაროა. ნერგდება ახალი ტექნიკა – შერეული ბიტის პალეტიზაცია (mixed-bit palettization), რომელიც მნიშვნელოვნად ამცირებს მოდელის ზომას
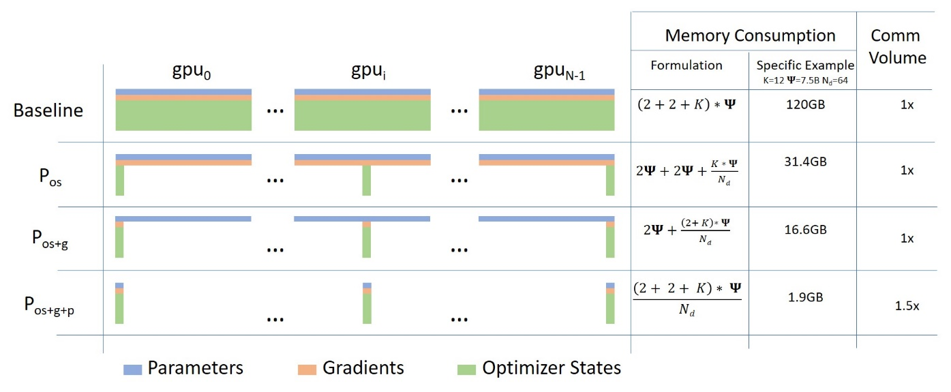
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
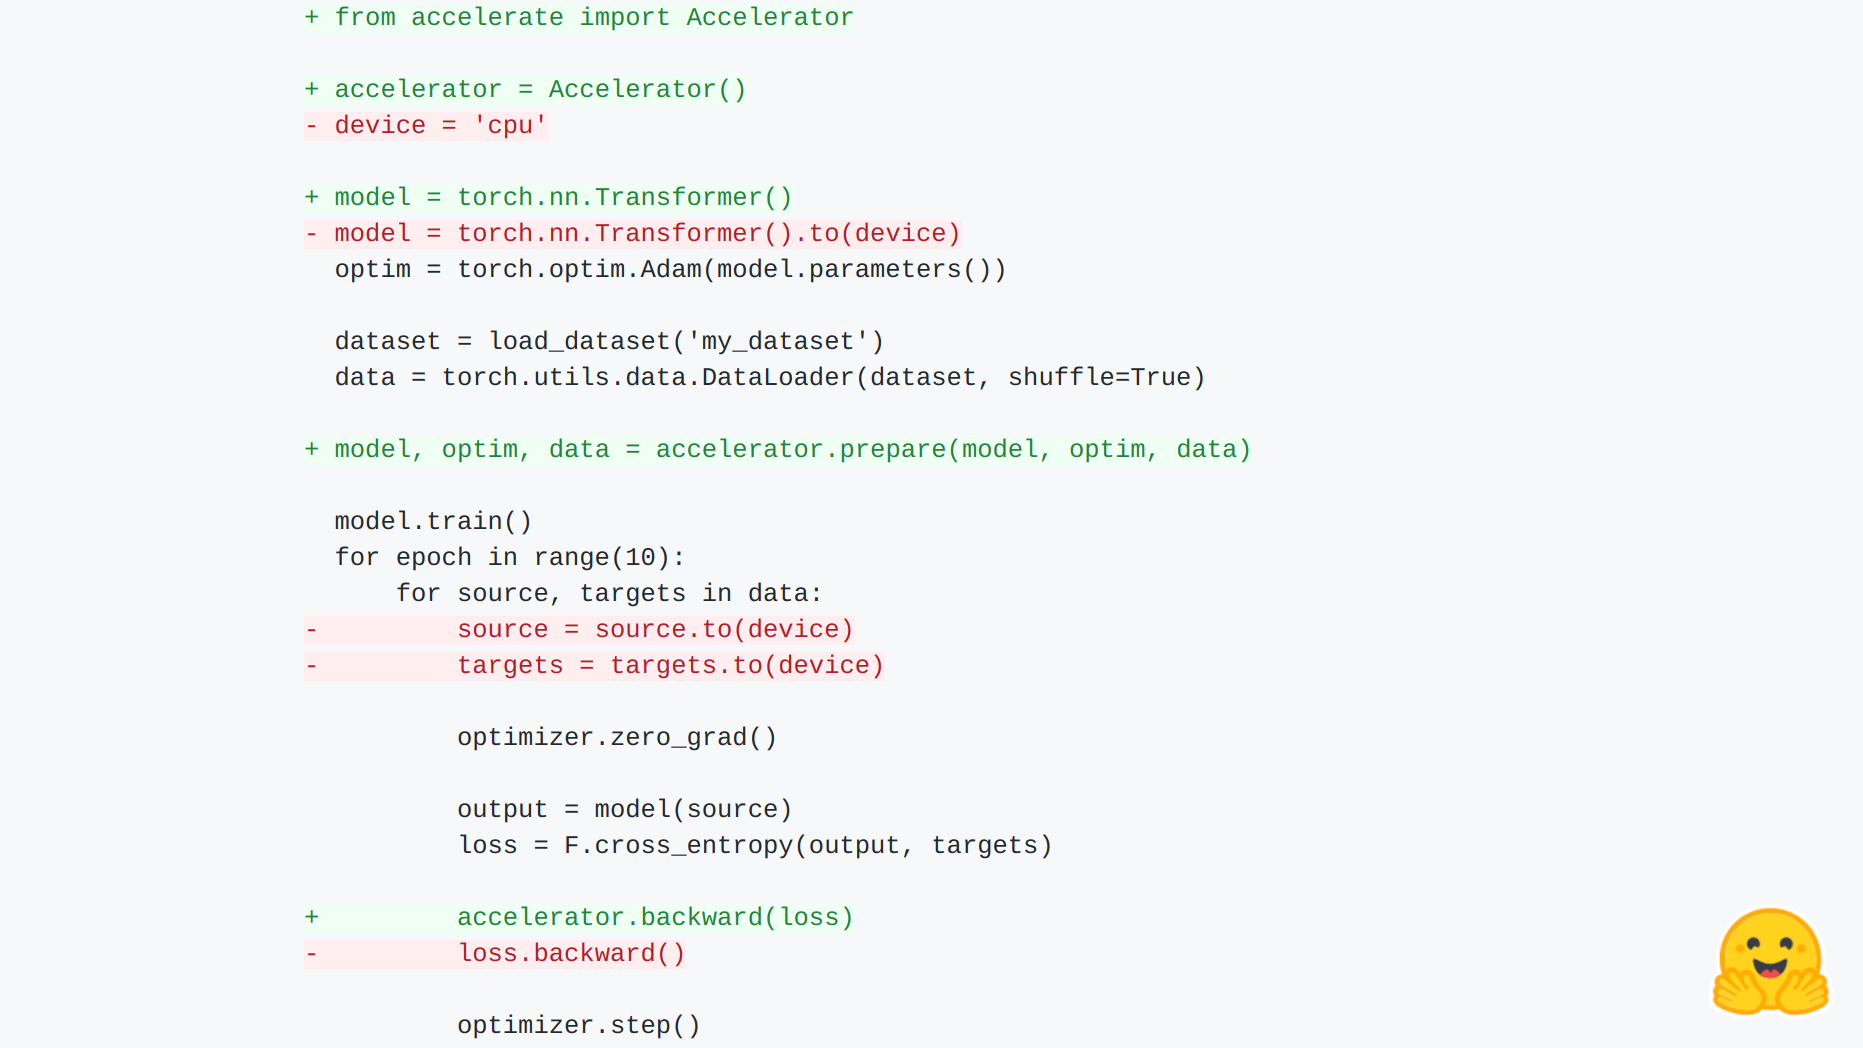
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ
SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.