კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო
Stable Diffusion-ისა და SDXL-ის რევოლუციური დაჩქარება LCM LoRA-ს მეშვეობით
დღეს წარმოდგენილია ინოვაციური მეთოდი, LCM LoRA, რომელიც მნიშვნელოვნად აჩქარებს Stable Diffusion-ისა და SDXL მოდელების გამოსახულების გენერირების პროცესს. ეს სიახლე მათ თითქოს LCM დისტილაციის პროცესით დამუშავებულს ხდის და საშუალებას აძლევს SDXL მოდელებს იმუშაონ დაახლოებით 1 წამში (3090 GPU-ზე, 7 წამის ნაცვლად) ან 10-ჯერ უფრო სწრაფად Mac-ზე, რაც ხსნის ახალ შესაძლებლობებს რეალურ დროში აპლიკაციებისთვის და გამოსახულების გენერირების სამუშაო პროცესებისთვის.
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.
Unsloth: დააჩქარეთ LLM მოდელების დახვეწა Hugging Face-ის ეკოსისტემაში
Unsloth არის მსუბუქი ბიბლიოთეკა, რომელიც შექმნილია დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესის დასაჩქარებლად. ის სრულად თავსებადია Hugging Face-ის ეკოსისტემასთან და აქტიურად ვითარდება Unsloth-ის გუნდისა და ღია წყაროს საზოგადოების მიერ. ბიბლიოთეკა მხარს უჭერს NVIDIA GPU-ებს, Llama-სა და Mistral-ის არქიტექტურებს, რაც უზრუნველყოფს მნიშვნელოვნად უფრო სწრაფ დახვეწას და მეხსიერების ნაკლებ გამოყენებას სტანდარტულ QLoRA-სთან შედარებით, სიზუსტის დაკარგვის გარეშე.
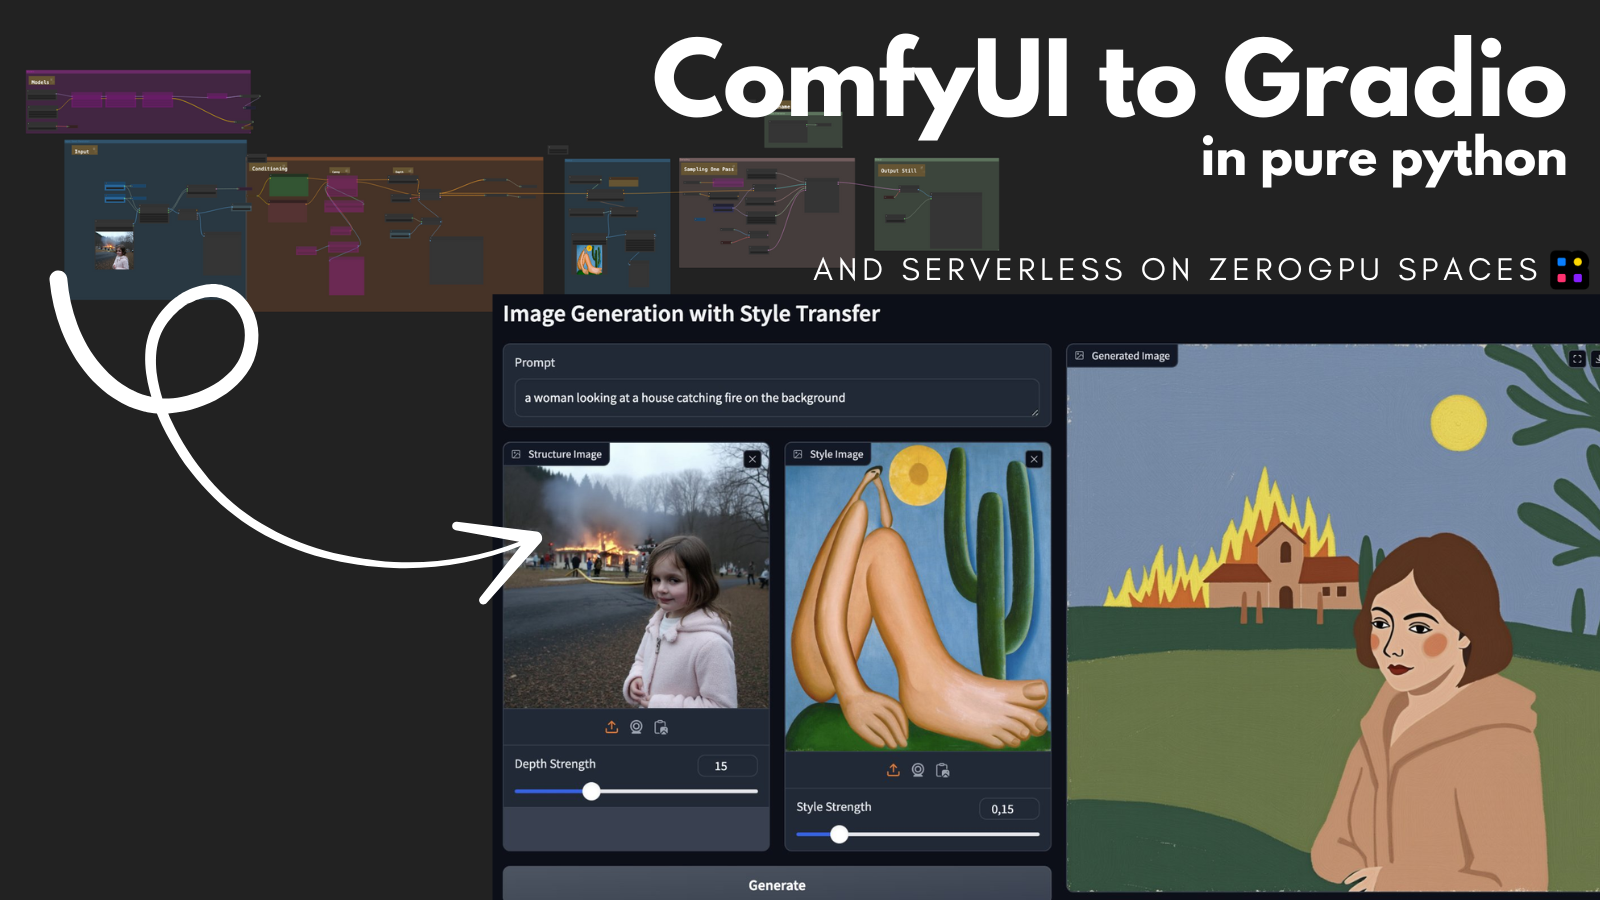
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI
ONNX Runtime მნიშვნელოვნად აჩქარებს SD Turbo-სა და SDXL Turbo-ს NVIDIA GPU-ებზე
SD Turbo და SDXL Turbo, Stable Diffusion-ის სწრაფი, გენერაციული ტექსტიდან გამოსახულების მოდელები, რომლებსაც შეუძლიათ გამოსაყენებელი სურათების გენერირება ერთ ნაბიჯში, ახლა ONNX Runtime-ის მეშვეობით კიდევ უფრო სწრაფი ხდება. ONNX Runtime-ის CUDA და TensorRT შესრულების პროვაიდერებში ოპტიმიზაციებმა გამოიწვია გამტარუნარიანობის 229%-მდე ზრდა SDXL Turbo-სთვის და 120%-მდე SD Turbo-სთვის NVIDIA GPU-ებზე, რაც მნიშვნელოვნად აღემატება PyTorch-ის მაჩვენებლებს. ეს გაუმჯობესება, გარდა შესრულების უპირატესობებისა

Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.
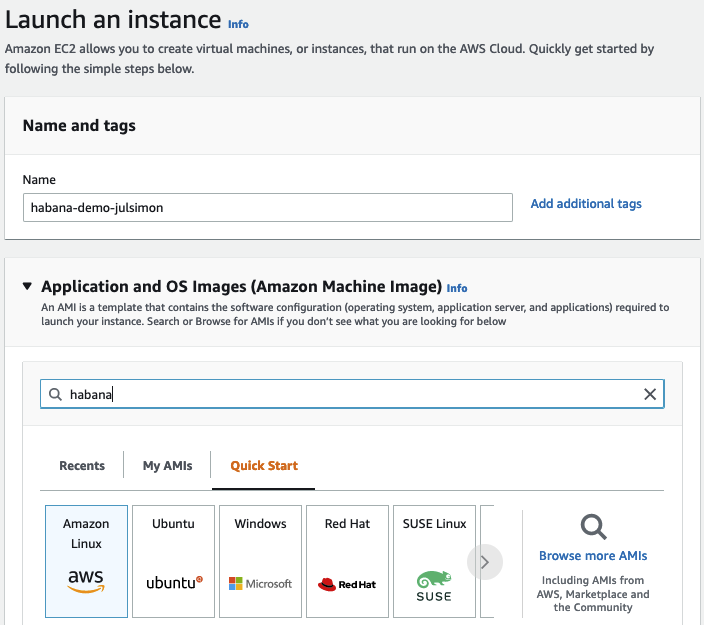
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
კონსტიტუციური ხელოვნური ინტელექტი: ღია მოდელების თვითგასწორება და ახალი ინსტრუმენტი „llm-swarm“
Anthropic-ის მიერ შემოთავაზებული კონსტიტუციური ხელოვნური ინტელექტის (CAI) ტექნიკა LLM-ებს აძლევს საშუალებას, თავად შეაფასონ და გააუმჯობესონ საკუთარი გამომუშავება მომხმარებლის მიერ განსაზღვრული პრინციპების მიხედვით. ეს მიდგომა მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. მოცემულ ნაშრომში აღწერილია კონსტიტუციური AI-ის სრულყოფილი განხორციელების რეცეპტი ღია მოდელებით, ასევე წარმოდგენილია ახალი ინსტრუმენტი „llm-swarm“, რომელიც GPU Slurm კლასტერებს იყენებს სკალირებადი სინთე

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug

Hugging Face და NVIDIA AI კვლევისთვის GPU რესურსებს ხელმისაწვდომს ხდიან „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) მეშვეობით
Hugging Face და NVIDIA აცხადებენ თანამშრომლობის შესახებ და წარმოადგენენ „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) ინიციატივას. ეს პლატფორმა მიზნად ისახავს AI-ის მკვლევრებისთვის და ორგანიზაციებისთვის GPU კლასტერებზე ხელმისაწვდომობის გაფართოებას, რათა მათ შეძლონ ხელოვნური ინტელექტის მოდელების ეფექტურად მომზადება. სერვისი გთავაზობთ მოქნილ გადახდის მოდელს, რაც რესურსების მოთხოვნისამებრ გამოყენების საშუალებას იძლევა და ამცირებს „გამოთვლითი რესურსების ხარვეზს“.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ