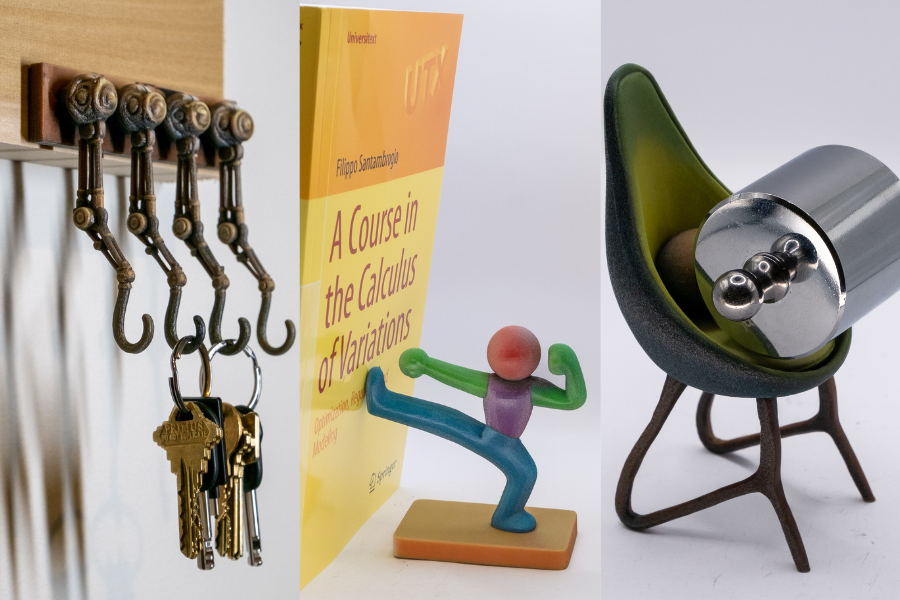
MIT-ის ახალი სისტემა გენერაციული AI-ის დიზაინს რეალურ სამყაროში ხდის გამოსაყენებელს
გენერაციული ხელოვნური ინტელექტის (GenAI) მიერ შექმნილი 3D დიზაინები ხშირად არამდგრადია რეალურ სამყაროში ფიზიკის გაგების ნაკლებობის გამო. მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) კომპიუტერული მეცნიერებისა და ხელოვნური ინტელექტის ლაბორატორიის (CSAIL) მკვლევრებმა შექმნეს სისტემა სახელწოდებით „PhysiOpt“, რომელიც გენერაციულ AI მოდელებს ფიზიკურ სიმულაციებს უმატებს. ეს უზრუნველყოფს, რომ 3D დაბეჭდილი ობიექტები, როგორიცაა ჭიქები და გასაღების დამჭერები, ფუნქციონალური და სტრუქტურულად გამართული იყოს, ავტო
„PhysiOpt“: MIT-ის სისტემა, რომელიც გენერაციულ ხელოვნურ ინტელექტს 3D დიზაინის ფიზიკურ რეალობასთან აახლოებს
გენერაციული ხელოვნური ინტელექტი ხშირად ქმნის დახვეწილ 3D დიზაინებს, რომლებიც ფიზიკის გაგების ნაკლებობის გამო რეალურ სამყაროში არაფუნქციურია. MIT-ის კომპიუტერული მეცნიერების და ხელოვნური ინტელექტის ლაბორატორიის (CSAIL) მკვლევრებმა შეიმუშავეს სისტემა „PhysiOpt“, რომელიც ამ პრობლემას ფიზიკის სიმულაციების დიზაინის პროცესში ინტეგრირებით აგვარებს. ეს უზრუნველყოფს, რომ 3D დასაბეჭდი ობიექტები, როგორიცაა ჭიქები ან გასაღების საკიდები, იყოს სტრუქტურულად მყარი და ფუნქციური ყოველდღიური გამოყენებისთვის, დამატ

SpaceX-ის ყოფილი ინჟინრების სტარტაპი Mesh Optical Technologies $50 მილიონს იზიდავს AI მონაცემთა ცენტრებისთვის ოპტიკური გადამცემების წარმოებისთვის
ლოს-ანჯელესში დაფუძნებულმა სტარტაპმა Mesh Optical Technologies, რომლის დამფუძნებლები SpaceX-ის ყოფილი ინჟინრები ტრევის ბრეშერი, კამერონ რამოსი და სერენა გროუნ-ჰებერლი არიან, Thrive Capital-ის მიერ ლიდერობით A სერიის დაფინანსების ფარგლებში $50 მილიონი მოიზიდა. კომპანიის მიზანია ოპტიკური გადამცემების მასობრივი წარმოება, რომლებიც გადამწყვეტია ხელოვნური ინტელექტის მსგავსი გამოთვლითი რესურსებით მდიდარი აპლიკაციებისთვის. სტარტაპი ბაზარზე არსებული შეზღუდვების დაძლევას ისახავს მიზნად და ეროვნული უსაფრთხ
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
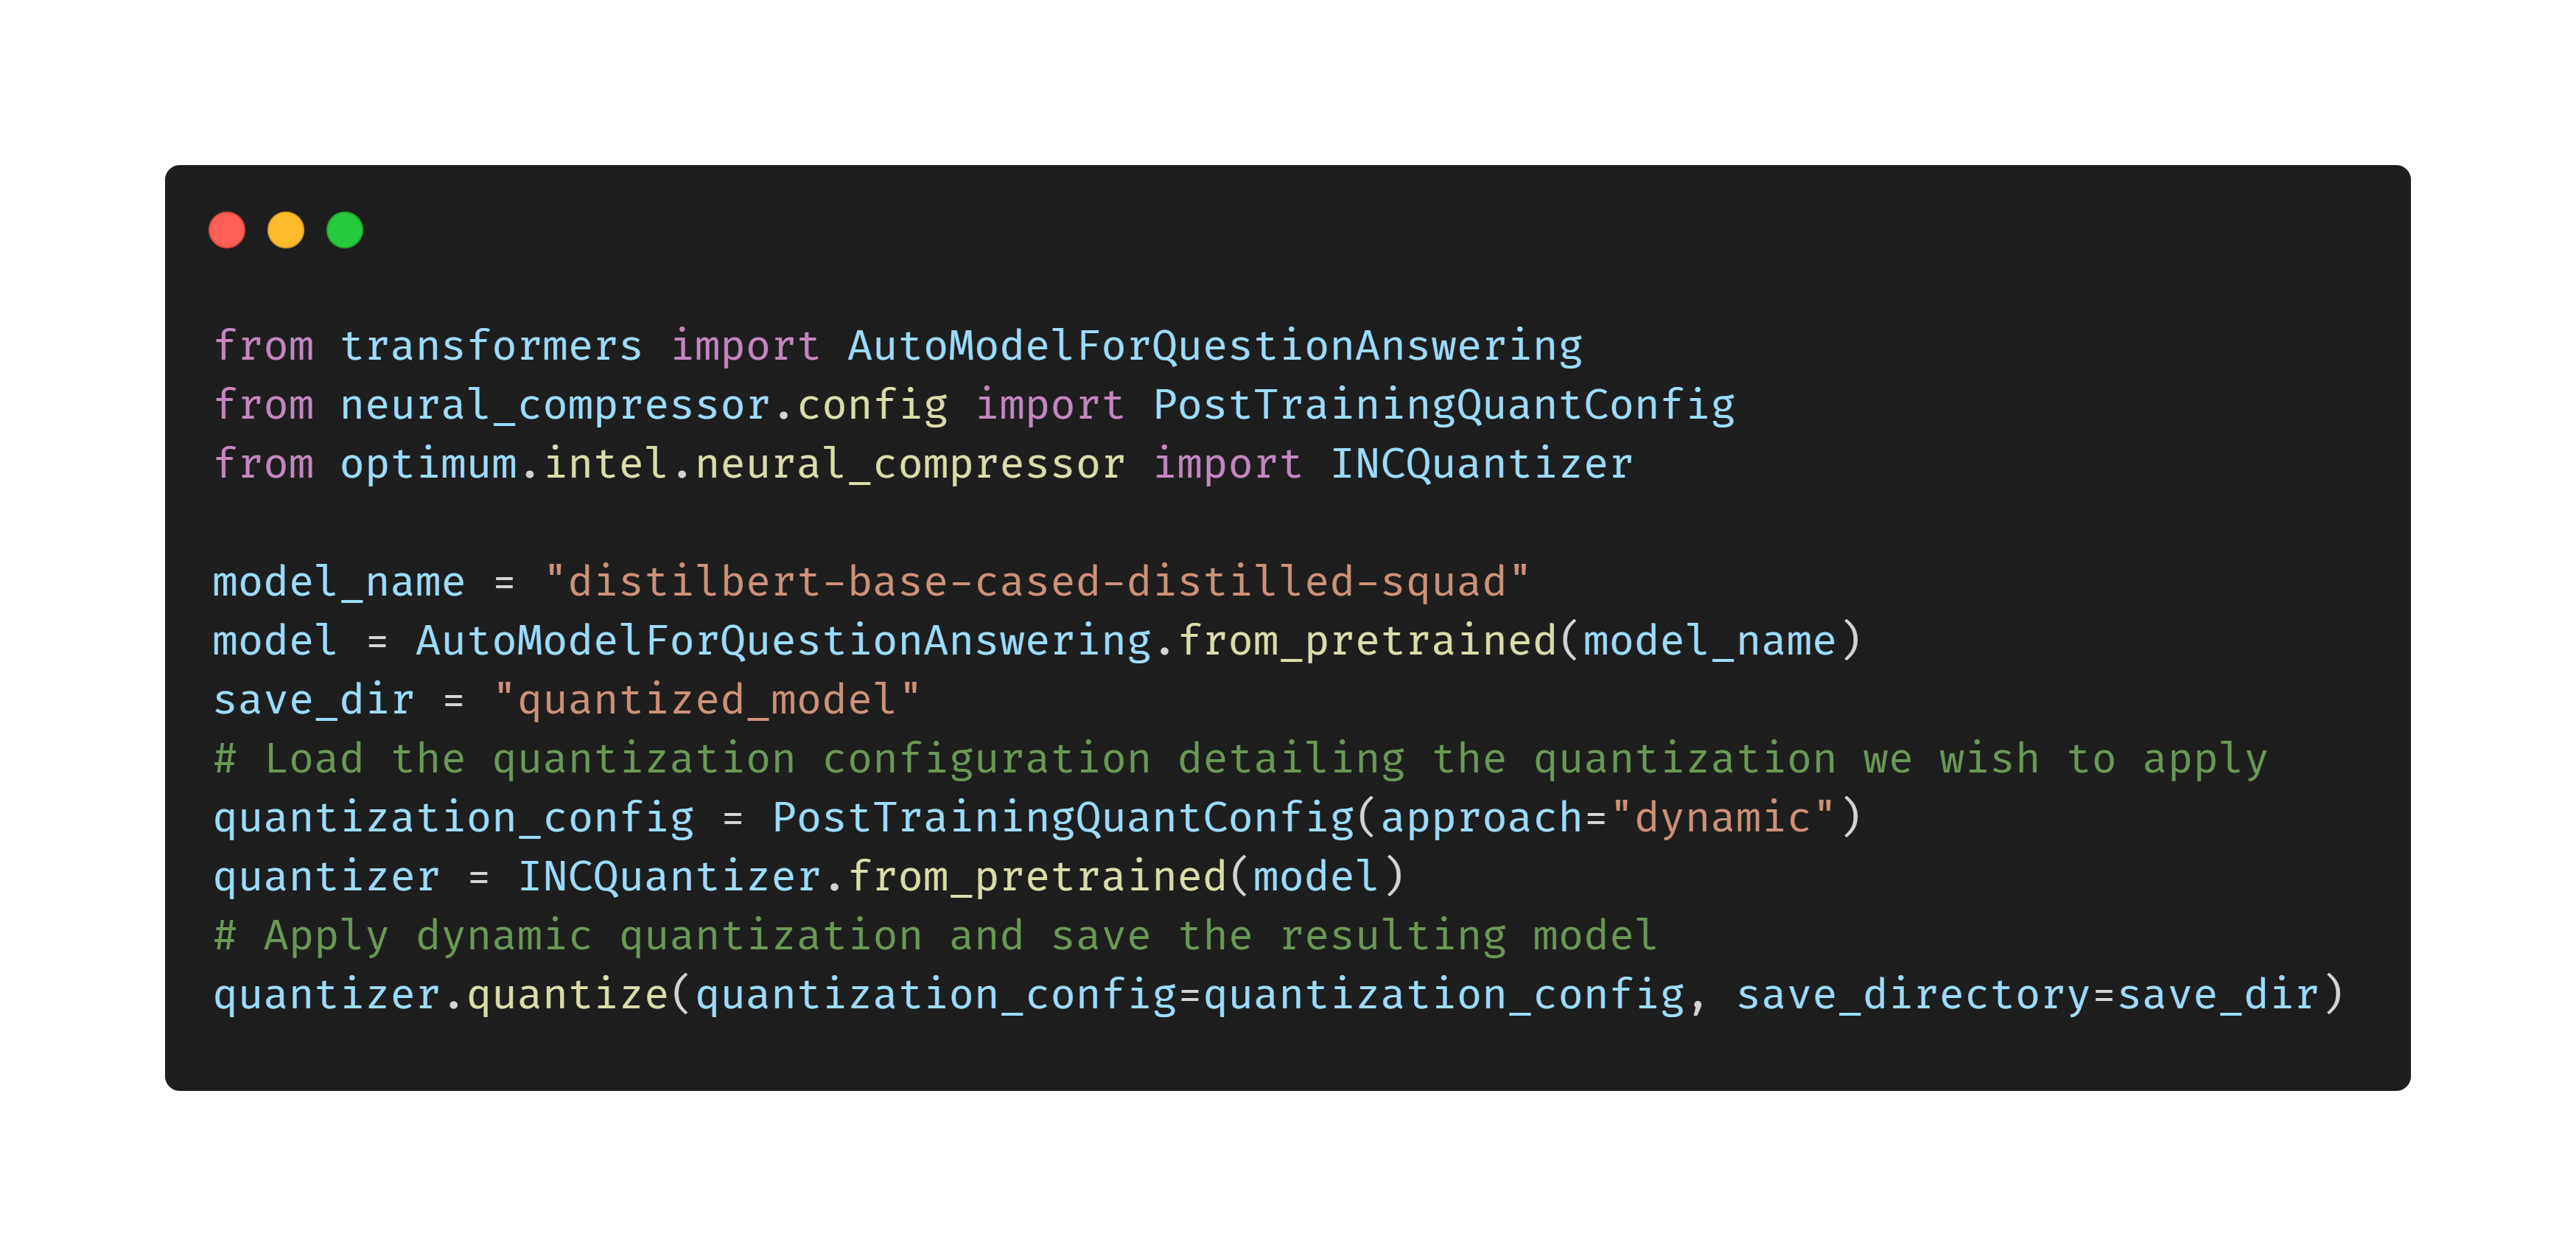
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე
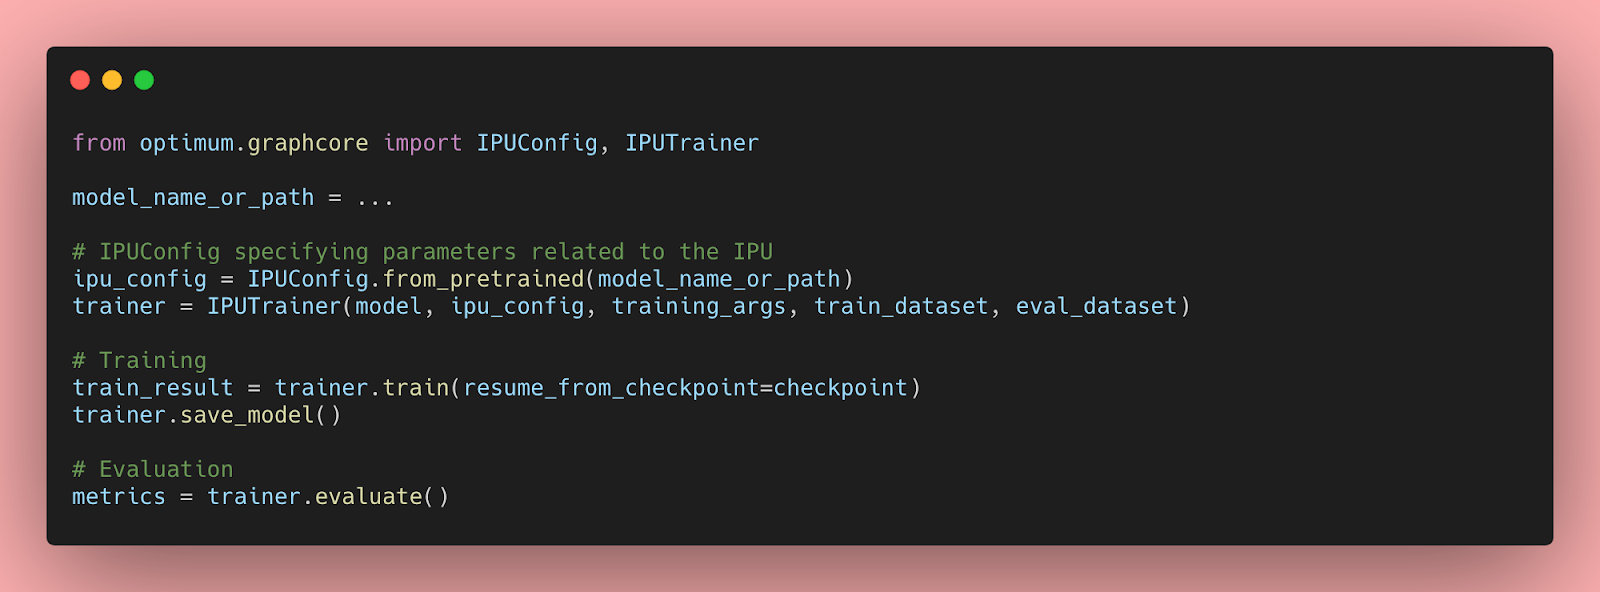
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ
რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.
Intel-ი Hugging Face-ის აპარატურის პარტნიორთა პროგრამას უერთდება ტრანსფორმერების მოდელების ოპტიმიზაციისთვის
Hugging Face-ის მისიაა მანქანური სწავლების დემოკრატიზაცია და მისი დადებითი გავლენის მაქსიმიზაცია. ამ მიზნით, Intel-ი ოფიციალურად შეუერთდა Hugging Face-ის აპარატურის პარტნიორთა პროგრამას. Optimum-ის ღია კოდის ბიბლიოთეკის წყალობით, Intel-ი და Hugging Face-ი ითანამშრომლებენ უახლესი აპარატურული აჩქარების შესაქმნელად ტრანსფორმერების მოდელების წვრთნის, დაზუსტებისა და პროგნოზირებისთვის. ეს პარტნიორობა მიზნად ისახავს დიდი და კომპლექსური ტრანსფორმერების მოდელების გამოწვევების გადაჭრას, განსაკუთრებით შეყო
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ
წარდგენა Quanto-სი: PyTorch-ის კვანტიზაციის ახალი ბეკენდი ხელოვნური ინტელექტის მოდელების ეფექტურობისთვის
Hugging Face წარმოგიდგენთ „quanto“-ს, PyTorch-ის კვანტიზაციის ახალ ბეკენდს Optimum-ისთვის, რომელიც შექმნილია ღრმა სწავლების მოდელების კვანტიზაციის გასამარტივებლად და სტანდარტიზებისთვის. Quanto მიზნად ისახავს მსხვილი ენობრივი მოდელების (LLM) უფრო ეფექტურს გახადოს სამომხმარებლო მოწყობილობებისთვის მეხსიერების შემცირებით და სპეციალიზებული აპარატურის ოპტიმიზაციების ჩართვით, გთავაზობთ მრავალმხრივ და მოწყობილობისგან დამოუკიდებელ გადაწყვეტას.

როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა