
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.

NVIDIA-მ 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრები და Nemotron Nano 2 9B გამოუშვა
NVIDIA განაგრძობს ღია ეკოსისტემის მხარდაჭერას 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრების გამოშვებით, რომელიც ხუთ ენაზეა ნათარგმნი. ამასთან ერთად, წარდგენილია Nemotron Nano 2 9B მოდელი, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს გაუმჯობესებული არქიტექტურითა და კონფიგურირებადი შესრულებით ზღვრულ მოწყობილობებზე აფართოებს. ეს ნაბიჯი ხაზს უსვამს კომპანიის ერთგულებას მოდელების განვითარებაში ღიაობისა და გამჭვირვალობის მიმართ.
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.

Google-მა გამოუშვა EmbeddingGemma: უახლესი მულტილინგვური ჩაშენების მოდელი მოწყობილობებისთვის
Google-მა წარადგინა EmbeddingGemma, უახლესი მულტილინგვური ჩაშენების მოდელი, რომელიც ოპტიმიზებულია მოწყობილობებზე გამოსაყენებლად. 308 მილიონი პარამეტრით და 2K კონტექსტური ფანჯრით, ის მხარს უჭერს 100-ზე მეტ ენას და MTEB ბენჩმარკზე 500M-ზე ნაკლებ მოდელებს შორის ყველაზე მაღალრეიტინგულია. მოდელი შექმნილია სიჩქარისა და ეფექტურობისთვის, მნიშვნელოვნად აფართოებს მობილური RAG კონვეიერების შესაძლებლობებს და ინტეგრირებულია პოპულარულ AI ხელსაწყოებთან.
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ
Intel-ი და Hugging Face-ი Optimum Intel-ში OpenVINO-ს ინტეგრაციას აცხადებენ ტრანსფორმერული მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა OpenVINO ინტეგრირეს Optimum Intel-ში, რაც დეველოპერებს საშუალებას აძლევს, მარტივად დააჩქარონ ტრანსფორმერული მოდელები Intel-ის სხვადასხვა პროცესორზე. ეს ინტეგრაცია უზრუნველყოფს ეფექტურ ინფერენსსა და კვანტიზაციას OpenVINO ნერვული ქსელების შეკუმშვის ფრეიმვორკის (NNCF) გამოყენებით, მნიშვნელოვნად ამცირებს მოდელის ზომასა და შეყოვნებას სიზუსტის მინიმალური დაკარგვით.

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
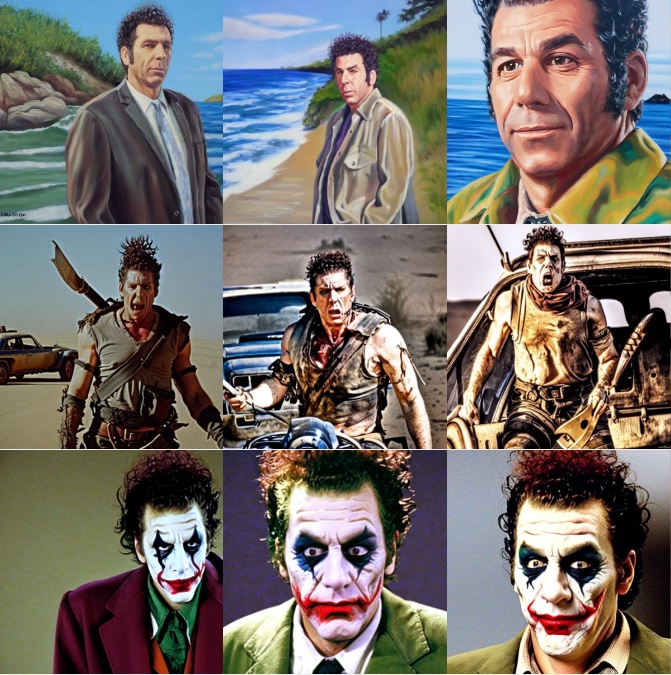
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.
ჰომომორფული დაშიფვრა მოქმედებაში: სენტიმენტების ანალიზი დაშიფრულ მონაცემებზე Concrete-ML-ით
ახალი ტექნოლოგიური მიღწევა მონაცემთა კონფიდენციალურობის სფეროში: სტატია იკვლევს ჰომომორფულ დაშიფრვას (FHE), რომელიც იძლევა დაშიფრულ მონაცემებზე გამოთვლების საშუალებას მათი გაშიფვრის გარეშე. Concrete-ML ბიბლიოთეკის დახმარებით, მონაცემთა მეცნიერებს შეუძლიათ შექმნან მანქანური სწავლების მოდელები FHE გარემოში კრიპტოგრაფიის ცოდნის გარეშე. გთავაზობთ პრაქტიკულ სახელმძღვანელოს დაშიფრულ მონაცემებზე სენტიმენტების ანალიზის მოდელის შესაქმნელად, დემო ვერსიით Hugging Face Spaces-ზე.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.

ციფრული ინტერაქციის მომავალი: GUI ავტომატიზაცია ხედვა-ენის მოდელებით
ეს ბლოგ-პოსტი წარმოგიდგენთ მრავალფაზიან სტრატეგიას ხედვა-ენის მოდელების გასაწვრთნელად, რათა მიღწეულ იქნას გრაფიკული ინტერფეისის (GUI) ავტომატიზაცია. განხილულია, თუ როგორ შეიძლება მოდელების ტრანსფორმაცია, საწყისი დამიწების შესაძლებლობების გარეშე, აგენტურ კოდერებად, რომლებსაც შეუძლიათ ინტერფეისების გაგება და მათთან ურთიერთობა. ხაზგასმულია მონაცემთა დამუშავებიდან მოდელის ტრენინგამდე მიმავალი ყოვლისმომცველი პროცესი. მიდგომა ეფუძნება SmolVLM2-2.2B-Instruct მოდელს და მოიცავს მონაცემთა გაერთიანების პაი

Stability AI-მ Stable Diffusion 3 Medium წარადგინა: ახალი 2-მილიარდპარამეტრიანი მოდელი გაუმჯობესებული არქიტექტურითა და წარმადობით
Stability AI-მ გამოუშვა Stable Diffusion 3 Medium (SD3), 2 მილიარდი პარამეტრიანი ლატენტური დიფუზიური მოდელი, რომელიც განკუთვნილია ტექსტიდან გამოსახულების სინთეზისთვის. ის მოიცავს ინოვაციურ მულტიმოდალურ დიფუზიურ ტრანსფორმატორს (MMDiT) და სამ ტექსტის ენკოდერს, მათ შორის T5-v1.1-XXL-ს. SD3 იყენებს პირობითი ნაკადის შესატყვისობის ობიექტივს სწავლებისთვის და წარმოგიდგენთ ახალ FlowMatchEulerDiscreteScheduler-ს ინფერენსისთვის. Diffusers-ის ინტეგრაცია მოიცავს მეხსიერების ოპტიმიზაციებს, რაც მოდელს უფრო ფარ
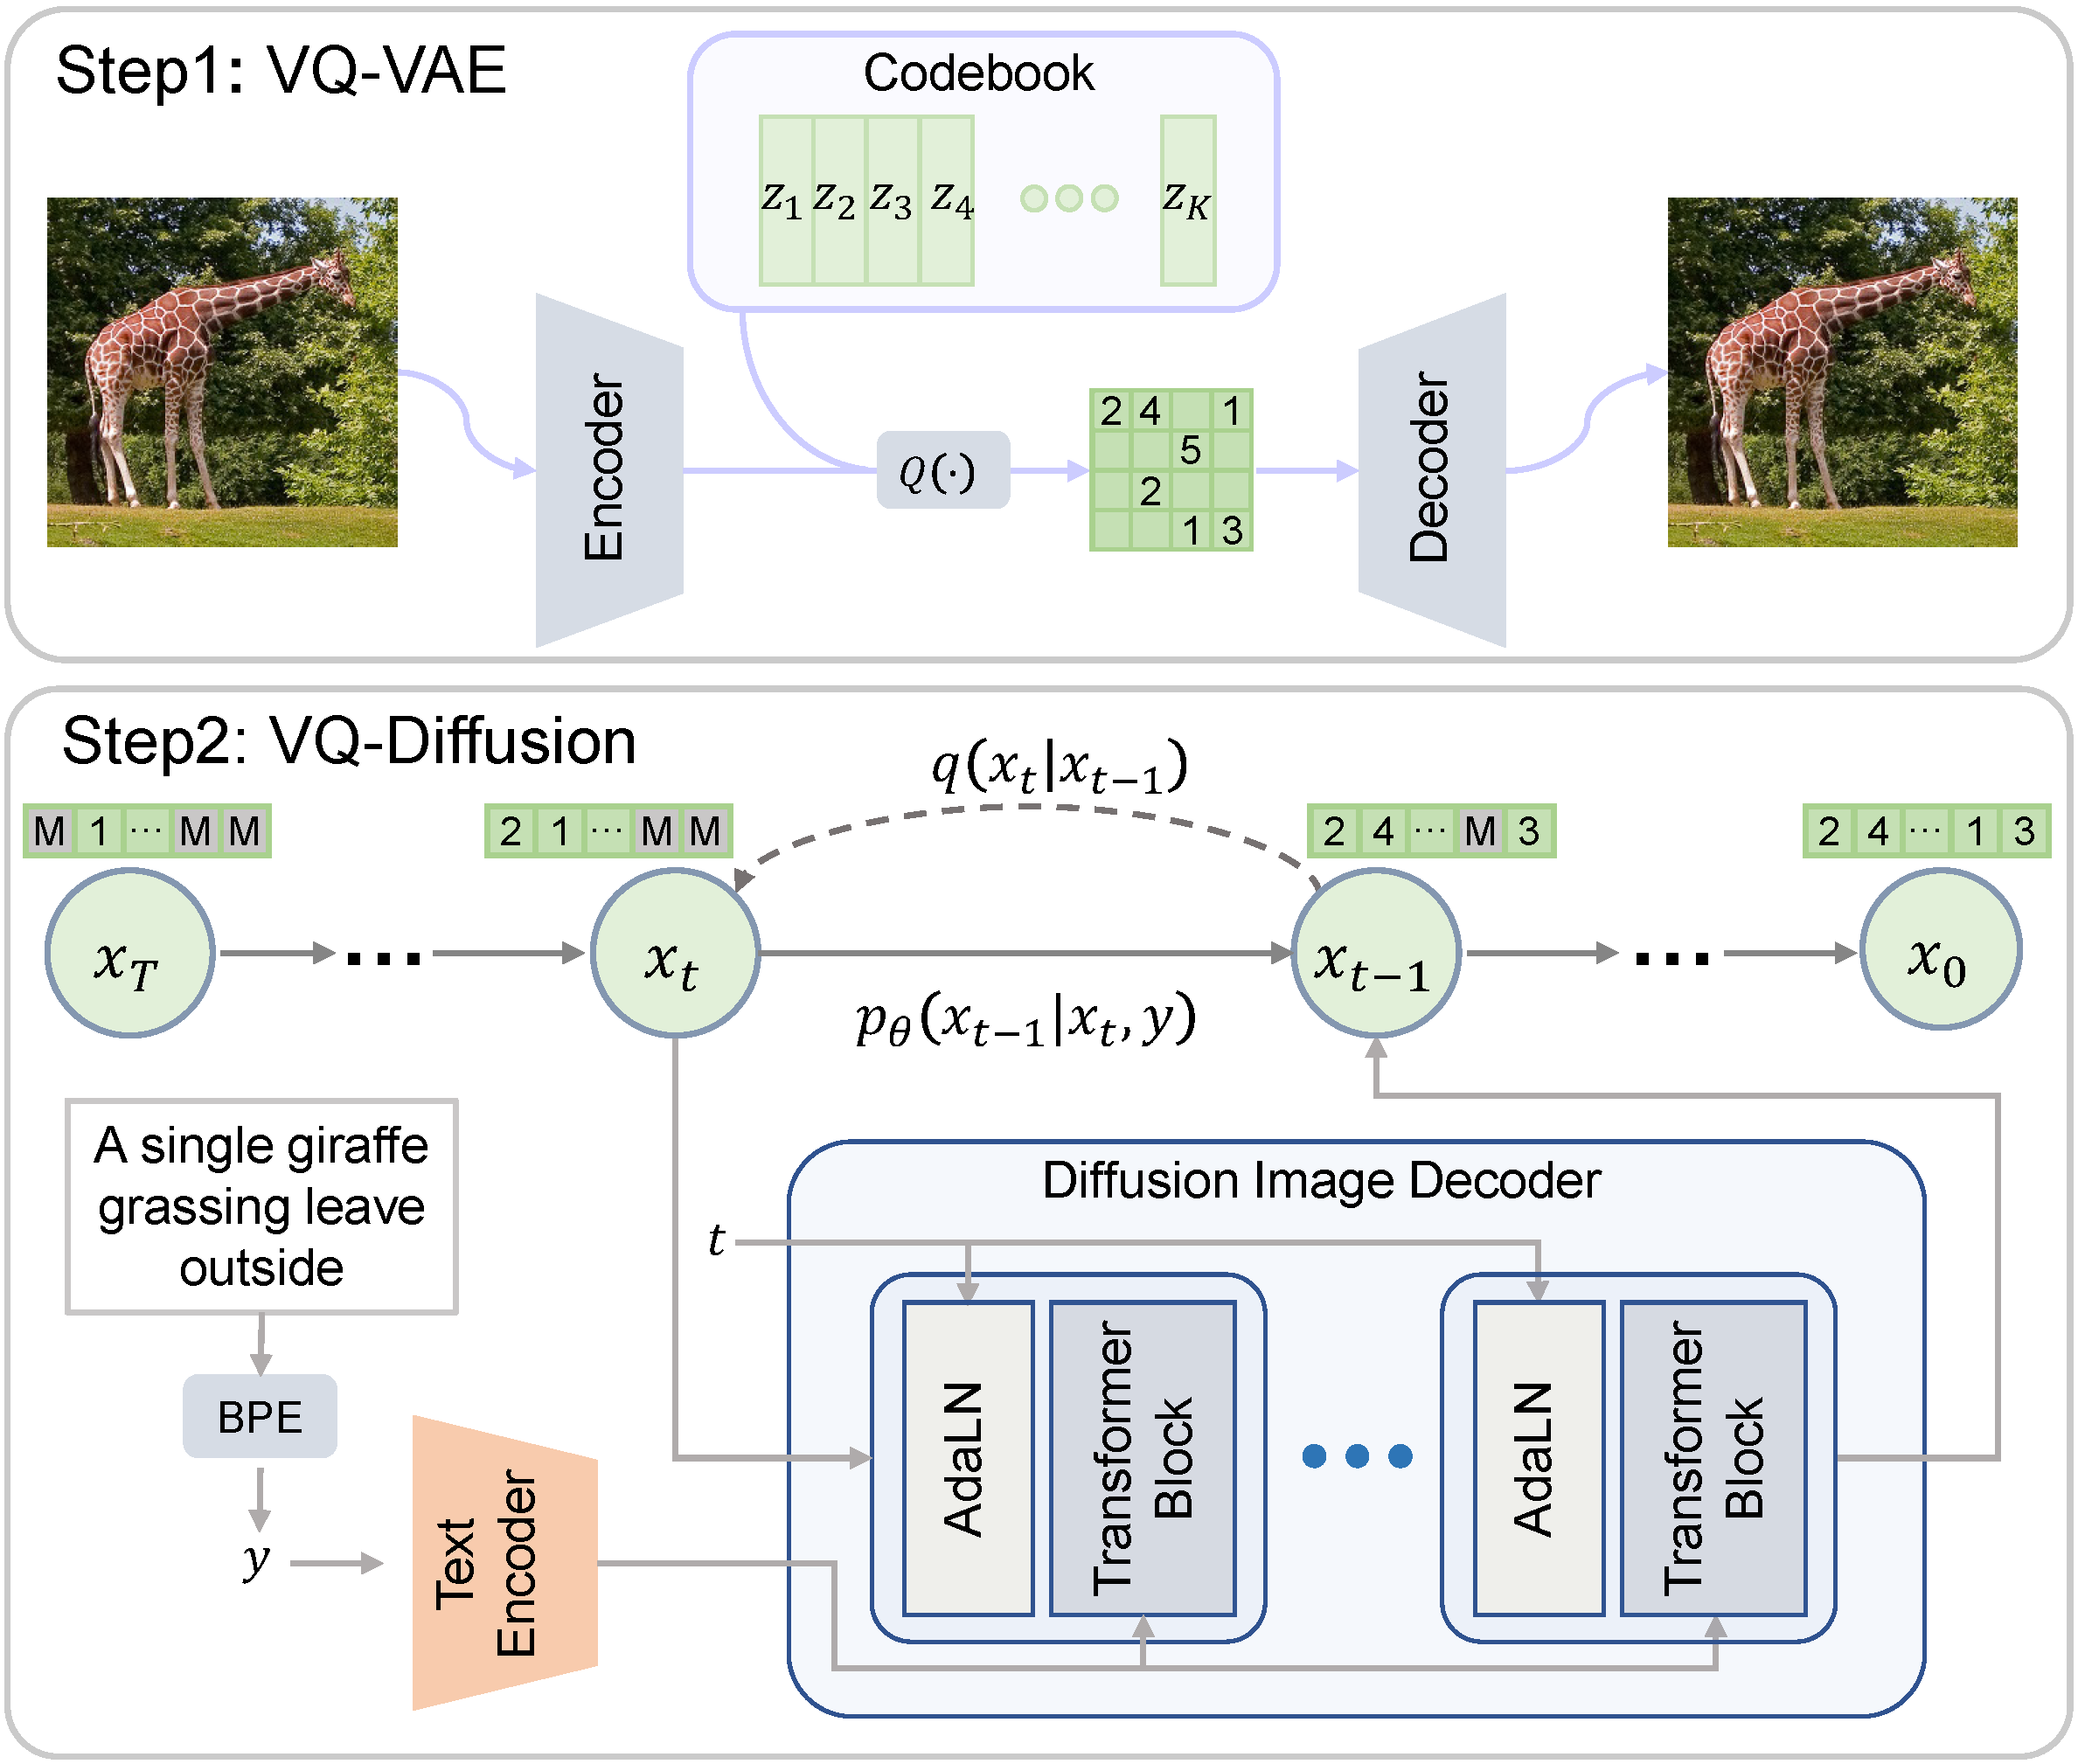
VQ-დიფუზია: ახალი სიმაღლეები გამოსახულების გენერაციაში „დიფუზერების“ მეშვეობით
„დიფუზერები“ (Diffusers) VQ-დიფუზიის (VQ-Diffusion) მოდელის გამოყენებას განსაკუთრებულად ამარტივებს, რაც დეველოპერებს საშუალებას აძლევს, გამოსახულების გენერაციის მოწინავე ტექნოლოგიები სულ რამდენიმე ხაზი კოდით გამოიყენონ. ეს მოდელი გამოსახულებებს დისკრეტულ „ტოკენებად“ კოდირებს VQ-VAE ენკოდერის მეშვეობით, ამცირებს მონაცემთა განზომილებას და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს გაუხმაურებელი ლატენტების პროგნოზირებისთვის. VQ-დიფუზია უწყვეტ დიფუზიურ მოდელებთან შედარებით დისკრეტულ მიდგომას გვთავაზობს და
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად