Idefics2: Hugging Face-ის ახალი, 10-ჯერ მცირე ზომის მულტიმოდალური AI მოდელი მნიშვნელოვანი გაუმჯობესებებით
Idefics2, Hugging Face-ის ახალი მულტიმოდალური AI მოდელი, მისი წინამორბედისგან განსხვავებით 10-ჯერ მცირე ზომისაა და მნიშვნელოვნად გაუმჯობესებულ შესაძლებლობებს გვთავაზობს. ის გაწვრთნილია მრავალფეროვან მონაცემთა ნაკრებებზე, მათ შორის ახლად გამოშვებულ „The Cauldron“-ზე, რომელიც მრავალმხრივი საუბრებისთვისაა განკუთვნილი. მოდელი, რომელიც აგებულია Mistral-7B-v0.1-სა და siglip-so400m-patch14-384-ზე, უკვე ხელმისაწვდომია Hugging Face Hub-ზე Apache-2.0 ლიცენზიით.
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
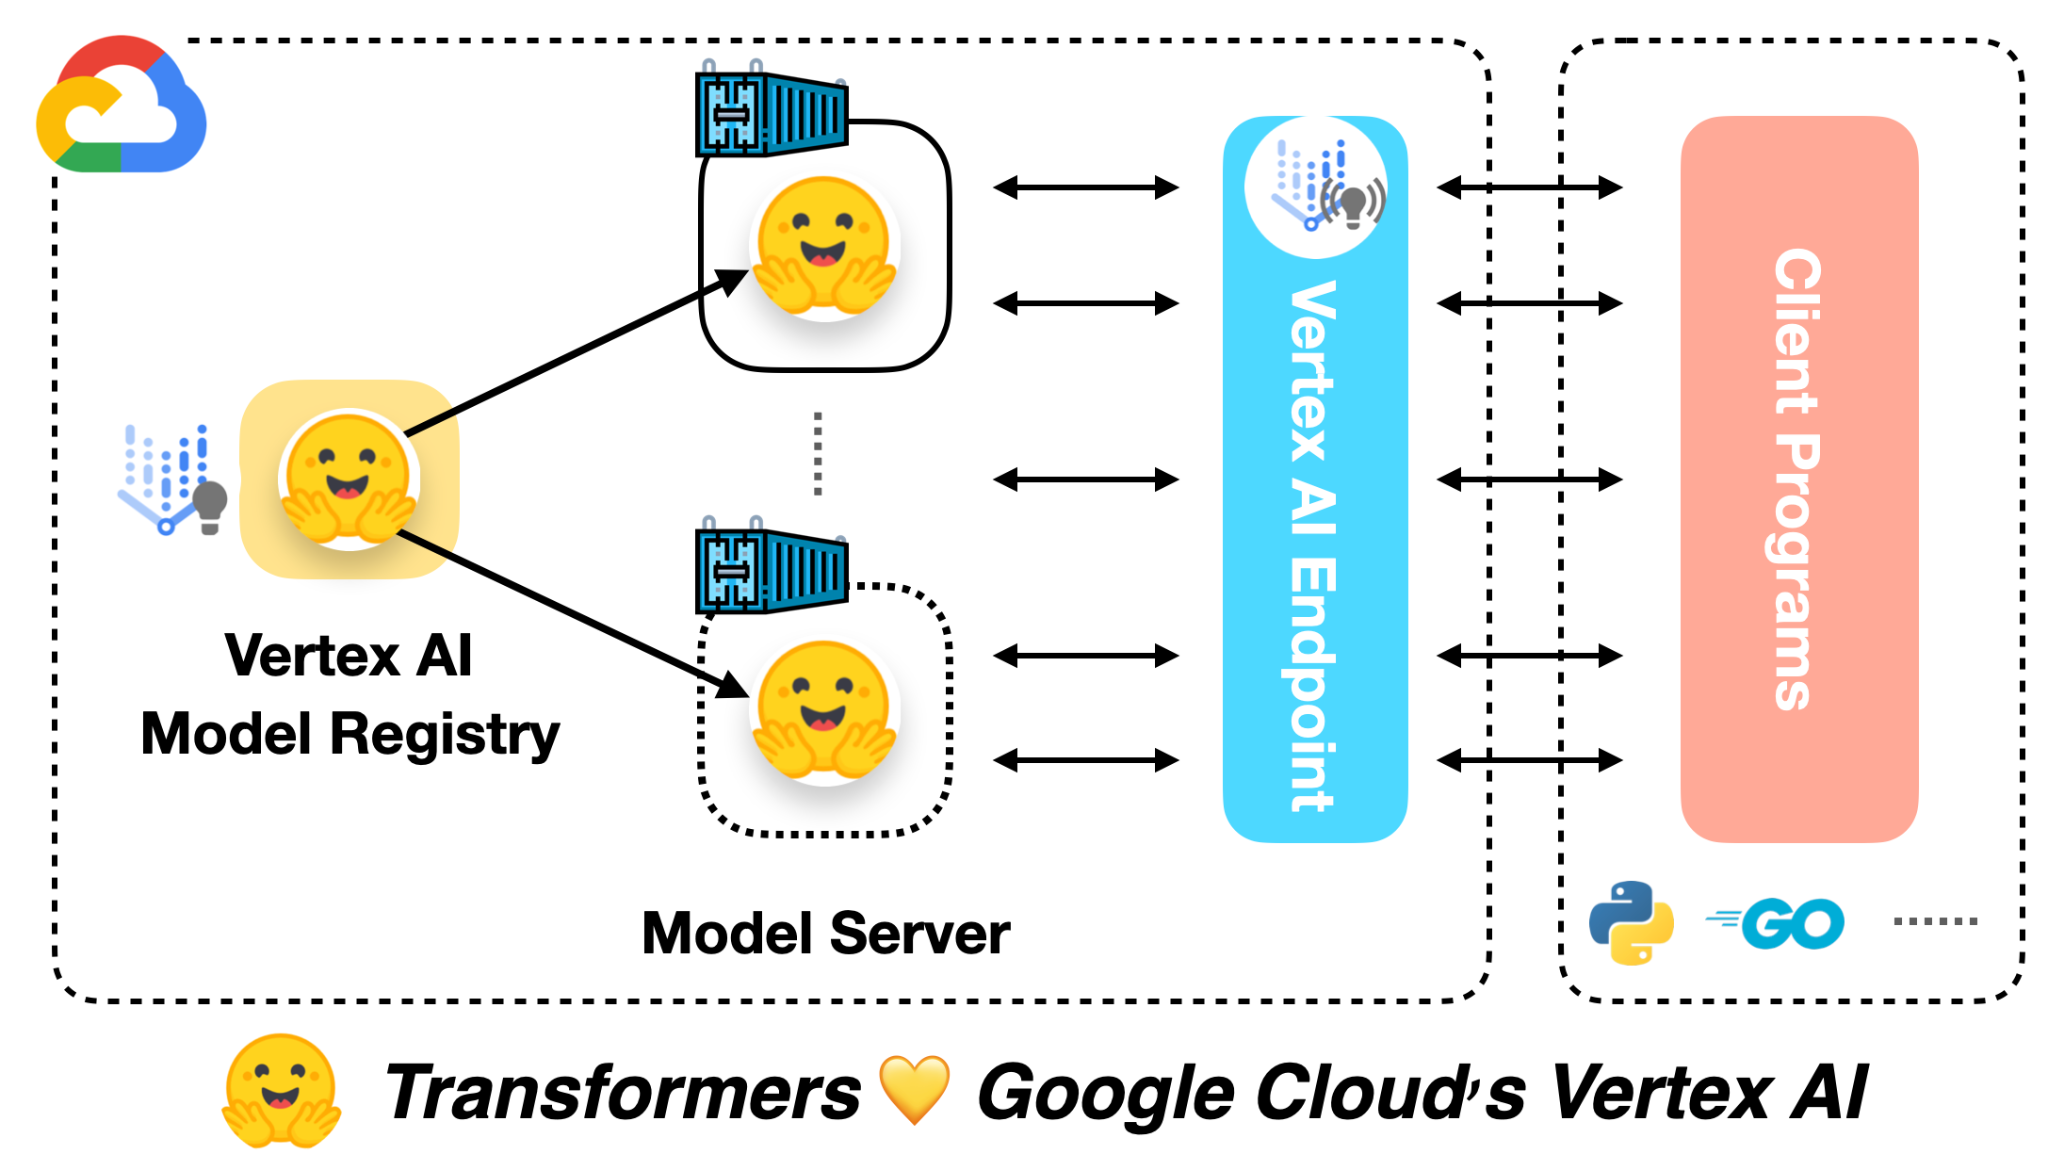
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.
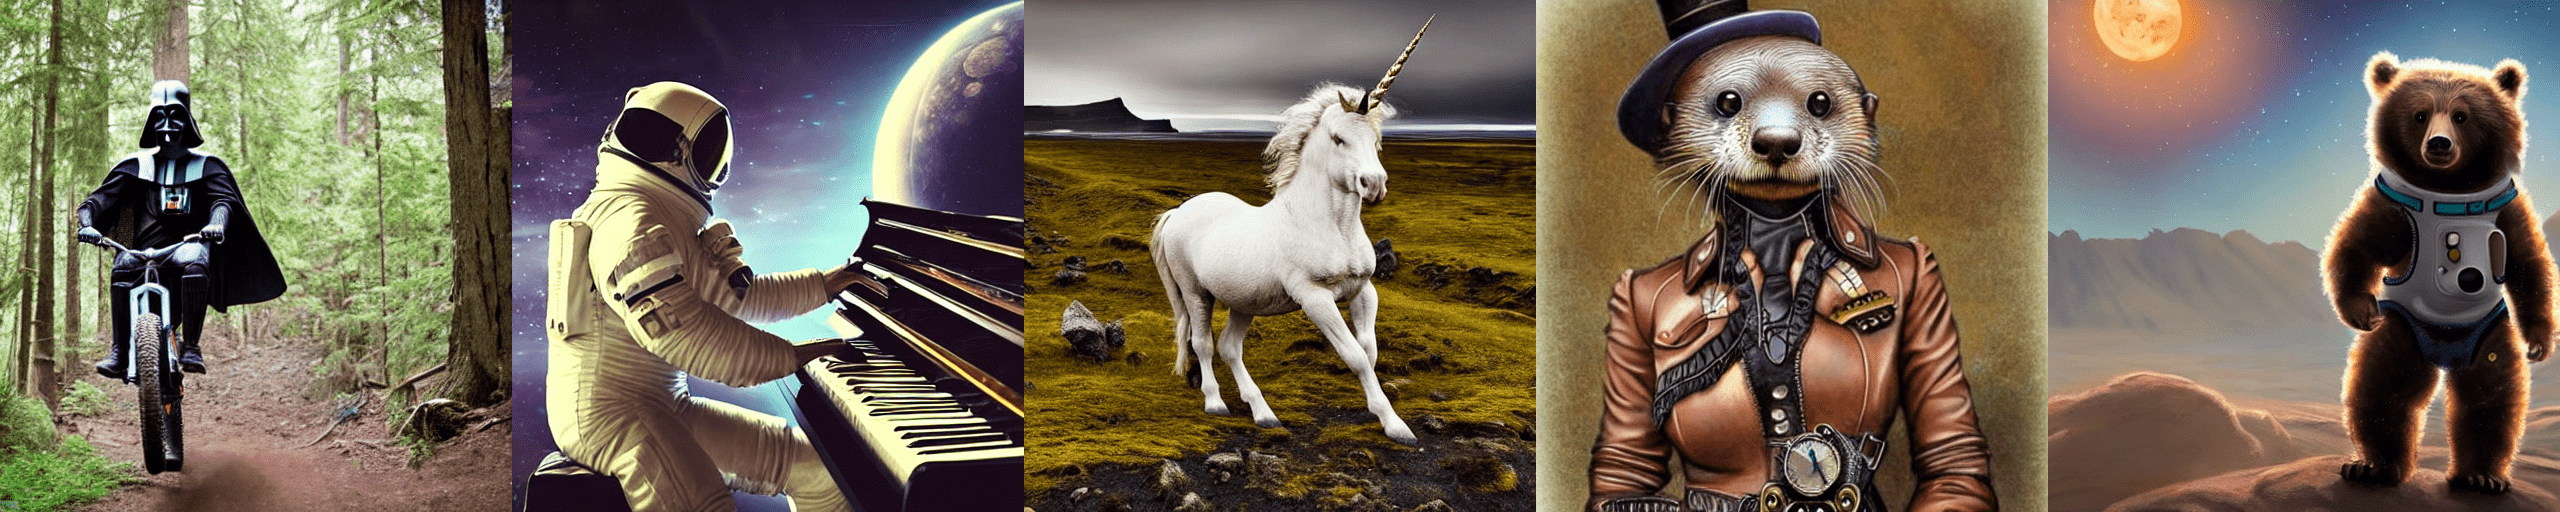
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g

შექმენით AI შოპინგ ასისტენტი Gradio-თი: ვირტუალური მოზომება და ონლაინ დათვალიერება
პითონის დეველოპერებისთვის Gradio ამარტივებს მძლავრი MCP სერვერების იმპლემენტაციას. წარმოიდგინეთ: გძულთ შოპინგი დროის სიმცირის გამო და არ გიყვართ ტანსაცმლის მოზომება. ეს პოსტი გიჩვენებთ, როგორ შექმნათ ხელოვნური ინტელექტის ასისტენტი, რომელიც დაათვალიერებს ონლაინ მაღაზიებს, იპოვის სასურველ სამოსს და ვირტუალური მოზომების მოდელის გამოყენებით გაჩვენებთ, როგორ მოგიხდებათ ის. პროექტი აერთიანებს IDM-VTON-ს, Gradio-ს და Visual Studio Code-ის AI ჩატის ფუნქციას.
JAT: ხელოვნური ინტელექტის ახალი ეტაპი – უნივერსალური აგენტი
პროექტი „ჯეკი ყველა ხელობაში“ (JAT) მიზნად ისახავს გენერალისტი AI აგენტის შექმნას, Gato-ს ნამუშევრის რეპროდუცირებითა და გაუმჯობესებით. JAT იყენებს მულტიმოდალურ ტრანსფორმერულ მოდელებს თანმიმდევრული მონაცემების დასამუშავებლად. პროექტის შედეგად შეიქმნა ექსპერტული აგენტების მონაცემთა ნაკრები და თავად JAT მოდელი, რომელმაც სხვადასხვა ამოცანაზე ექსპერტული შესრულების 65.8% საშუალო შედეგი აჩვენა, რაც მის მრავალმხრივობას ადასტურებს.
ღია CoT ლიდერბორდი: ხელოვნური ინტელექტის მოდელების შეფასება აზროვნების ჯაჭვის გავლენის მიხედვით
ღია CoT ლიდერბორდი წარმოადგენს ახალ პლატფორმას ხელოვნური ინტელექტის (LLM) მოდელების შესაფასებლად. ტრადიციული ლიდერბორდებისგან განსხვავებით, ის ზომავს არა აბსოლუტურ სიზუსტეს, არამედ იმ განსხვავებას, რასაც აზროვნების ჯაჭვის (Chain-of-Thought, CoT) მოთხოვნა იწვევს მოდელის სიზუსტეში. ეს მიდგომა საშუალებას იძლევა ჭეშმარიტად შემოწმდეს CoT-ის გავლენა მოდელის მსჯელობის უნარზე და მიზნად ისახავს შეამციროს ტრენინგის მონაცემების დაბინძურების რისკი, რაც აძლიერებს შეფასების სანდოობას. ლიდერბორდი იყენებს მოდულ
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც
ავარჯიშეთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი: როგორ აამუშავოთ Half-Cheetah
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს, თუ როგორ უნდა ავარჯიშოთ თქვენი პირველი ოფლაინ Decision Transformer მოდელი ნულიდან. ის განმარტავს Decision Transformer-ის ძირითად კონცეფციას, რომელიც აძლიერებს სწავლის პრობლემას პირობით-თანმიმდევრობის მოდელირების ამოცანად გარდაქმნის გზით, რათა წარმოქმნას მომავალი ქმედებები სასურველი შედეგების, წარსული მდგომარეობებისა და ქმედებების საფუძველზე. გაკვეთილი ფოკუსირებულია ოფლაინ მიდგომაზე, Google Colab-ის, 🤗 Trainer-ის და სპეციალური მონაცემთა კოლატორის გამოყ
ოფლაინ გადაწყვეტილების ტრანსფორმატორის მოდელის გაწვრთნა: ნახევრად-გეპარდის სიმულაციის მიღწევა
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა გაწვრთნათ ოფლაინ გადაწყვეტილების ტრანსფორმატორის (Decision Transformer) მოდელი ნულიდან, რათა სიმულაციურ გარემოში ნახევრად-გეპარდმა შეძლოს მოძრაობა. განხილულია მოდელის ფუნდამენტური პრინციპები, რომელიც განმტკიცებით სწავლებას მიმდევრობის მოდელირების პრობლემად აღიქვამს და წარსული მონაცემებისა და სასურველი შედეგების საფუძველზე სამომავლო მოქმედებებს აგენერირებს. პრაქტიკული გაკვეთილი, რომელიც Google Colab-ზე სრულდება, ხსნის მონაცემთა დამუშავებასა და Hugging Fac

რატომ იცვლება დიდი ენობრივი მოდელების (LLM) რეიტინგი მოთხოვნის ფორმატის მიხედვით?
დიდი ენობრივი მოდელების (LLM) შესრულება და რეიტინგი მოულოდნელად მგრძნობიარე აღმოჩნდა მოთხოვნის (prompt) ფორმატისა და მცირეგანზომილებიანი („few-shot“) მაგალითების თანმიმდევრობის მიმართ, რაც აფერხებს სამართლიან შეფასებას და შედარებას. კვლევებმა აჩვენა, რომ მცირე ცვლილებებმა მოთხოვნის ფორმატში შეიძლება გამოიწვიოს მოდელის ქულების 10 ქულით ვარიაცია და რეიტინგის არათანმიმდევრულობა. ამ პრობლემის დასაძლევად შემოთავაზებულია სტრუქტურირებული გენერაცია, რომელიც მოდელის გამოსავალს კონკრეტულ სტრუქტურაში აქცევ

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

Hugging Face-ის AI Sheets: ხელოვნური ინტელექტის უკოდო ინსტრუმენტი მონაცემთა ნაკრებების შექმნისა და მართვისთვის
Hugging Face-მა წარმოადგინა AI Sheets – ახალი, ღია წყაროს მქონე უკოდო ინსტრუმენტი, რომელიც მომხმარებლებს საშუალებას აძლევს შექმნან, გაამდიდრონ და გარდაქმნან მონაცემთა ნაკრებები ხელოვნური ინტელექტის მოდელების გამოყენებით. ის ინტეგრირებულია Hugging Face Hub-თან და გთავაზობთ ათასობით ღია მოდელის გამოყენების შესაძლებლობას სწრაფი ექსპერიმენტებისა და მონაცემთა დამუშავებისთვის. ინსტრუმენტი გამოირჩევა მარტივი, ცხრილის მსგავსი ინტერფეისით და ხელს უწყობს ეფექტურ მუშაობას როგორც მცირე, ისე მსხვილ მონაცემთა

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს

მოდელის კონტექსტის პროტოკოლი (MCP): ხელოვნური ინტელექტის ახალი ერა კვლევის ავტომატიზაციაში
მოდელის კონტექსტის პროტოკოლი (MCP) არის სტანდარტი, რომელიც აგენტურ მოდელებს საშუალებას აძლევს, დაუკავშირდნენ გარე ინსტრუმენტებსა და მონაცემთა წყაროებს. ეს ხელოვნურ ინტელექტს აძლევს შესაძლებლობას, ბუნებრივი ენის გამოყენებით ავტომატიზირება მოახდინოს კვლევის პროცესში, პლატფორმებს შორის გადართვისა და ინფორმაციის ჯვარედინი შემოწმების ჩათვლით, რაც მნიშვნელოვნად ზრდის კვლევის ეფექტურობას.
იაპონური Stable Diffusion: კულტურულად მგრძნობიარე ტექსტიდან-გამოსახულების მოდელი
Stable Diffusion, მძლავრი ტექსტიდან-გამოსახულების გენერირების მოდელი, შესანიშნავად ქმნის სურათებს ინგლისური პრომპტების საფუძველზე, თუმცა ხშირად უჭირს არადასავლური კულტურული ნიუანსების გადმოცემა. ამ გამოწვევის საპასუხოდ, rinna Co., Ltd.-მ შექმნა „იაპონური Stable Diffusion“, ორიგინალური მოდელის დახვეწით (fine-tuning) იაპონურენოვანი წარწერების მქონე გამოსახულებებზე და იაპონურ სპეციფიკური ტექსტური ენკოდერის (text encoder) და ტოკენაიზერის (tokenizer) ინტეგრირებით. ეს ახალი მოდელი იგებს იაპონურ კულტურ
Google-მა წარმოადგინა PaliGemma: ვიზუალური ენობრივი მოდელების ახალი თაობა
Google-მა წარმოადგინა PaliGemma, ვიზუალური ენობრივი მოდელების ახალი ოჯახი, რომელსაც შეუძლია გამოსახულებისა და ტექსტის კომბინირებული დამუშავება ტექსტის გენერირებისთვის. ეს ინოვაციური მოდელი SigLIP-ის გამოსახულების ენკოდერსა და Gemma-2B-ის ტექსტის დეკოდერს აერთიანებს, რაც მას მძლავრ ინსტრუმენტად აქცევს. PaliGemma ხელმისაწვდომია სხვადასხვა ტიპის, რეზოლუციისა და სიზუსტის ვარიანტებში და უზრუნველყოფს ფართო შესაძლებლობებს, მათ შორის გამოსახულების აღწერას, კითხვებზე პასუხის გაცემას, ობიექტის ამოცნობასა
Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე