
NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო

OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო

AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
SmolLM3: ოპტიმალური ეფექტურობის 3B მოდელი სრული საინჟინრო პროექტით
SmolLM3-ის 3 მილიარდი პარამეტრის მოდელი აღემატება Llama-3.2-3B და Qwen2.5-3B მოდელებს, ამავდროულად ინარჩუნებს კონკურენტუნარიანობას უფრო დიდ 4B ალტერნატივებთან (Qwen3 და Gemma3). მისი უნიკალურობა მდგომარეობს იმაში, რომ დეველოპერები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას – არქიტექტურის დეტალებს, მონაცემთა შერევის მეთოდებსა და სამეტაპიან წინასწარ ვარჯიშის მიდგომას, რაც ჩვეულებრივ თვეების უკუინჟინერიას მოითხოვდა. არქიტექტურული ინოვაციები მოიცავს Grouped Query Attention (GQA), NoPE პოზიციური
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti

MCP პროტოკოლი: Hugging Face Spaces როგორც LLM-ის შესაძლებლობების „აპლიკაციების მაღაზია“
მოდელის კონტექსტის პროტოკოლი (MCP) არის ღია სტანდარტი, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან უსაფრთხო, ორმხრივი კავშირები დიდ ენობრივ მოდელებსა (LLM) და ინსტრუმენტების კომპლექტს შორის. ამ ინტეგრაციის წყალობით, Hugging Face Spaces, რომელიც Gradio-ს მეშვეობით აერთიანებს ათასობით AI აპლიკაციას, იქცევა LLM-ებისთვის „აპლიკაციების მაღაზიად“, სადაც მათ შეუძლიათ შეიძინონ ახალი შესაძლებლობები, როგორიცაა გამოსახულების რედაქტირება ან ვიდეო ტრანსკრიფცია, რაც LLM-ებს საშუალებას აძლევს, გაცილდნენ მა
BLOOM: 176 მილიარდი პარამეტრის მოდელის შექმნის საინჟინრო მიღწევები და ტექნოლოგიები
პროექტი, რომელიც Hugging Face-ის თანადამფუძნებელმა თომას ვოლფმა წამოიწყო, მიზნად ისახავდა ერთ-ერთი უდიდესი მრავალენოვანი მოდელის შექმნას და მის ხელმისაწვდომობას ყველასთვის. ეს სტატია ფოკუსირებულია 176 მილიარდი პარამეტრის BLOOM მოდელის წვრთნის საინჟინრო ასპექტებზე, ხაზს უსვამს ექსპერტებისა და კომპანიების ერთობლივ ძალისხმევას. განხილულია ფრანგული სუპერკომპიუტერის Jean Zay გამოყენება და მოწინავე Megatron-DeepSpeed ფრეიმვორკი, რომელიც 3D პარალელიზმს იყენებს ეფექტური წვრთნისთვის.

AI-ის ეფექტურობის რევოლუცია: Hugging Face და AMD Llama 3.1-ს MI300X-ზე აუმჯობესებენ
ყოველდღიურად მილიარდობით AI მოთხოვნის დამუშავება, როგორიცაა ChatGPT-ის მიერ, მოდელის ოპტიმიზაციას გადამწყვეტ მნიშვნელობას ანიჭებს. განსაკუთრებით კრიტიკულია ბირთვის (kernel) დონის ოპტიმიზაცია, რაც ხშირად უგულებელყოფილია მრავალი მოწყობილობისთვის, განსაკუთრებით AMD GPU-ებისთვის. Hugging Face-მა AMD-სთან ითანამშრომლა, რათა შეემუშავებინა ღია წყაროს ოპტიმიზებული ბირთვები Llama 3.1 405B მოდელის მუშაობის გასაუმჯობესებლად FP8 ფორმატში, 8 MI300X GPU-ით აღჭურვილ კვანძზე, VLLM-ის გამოყენებით. ეს პარტნიორობა
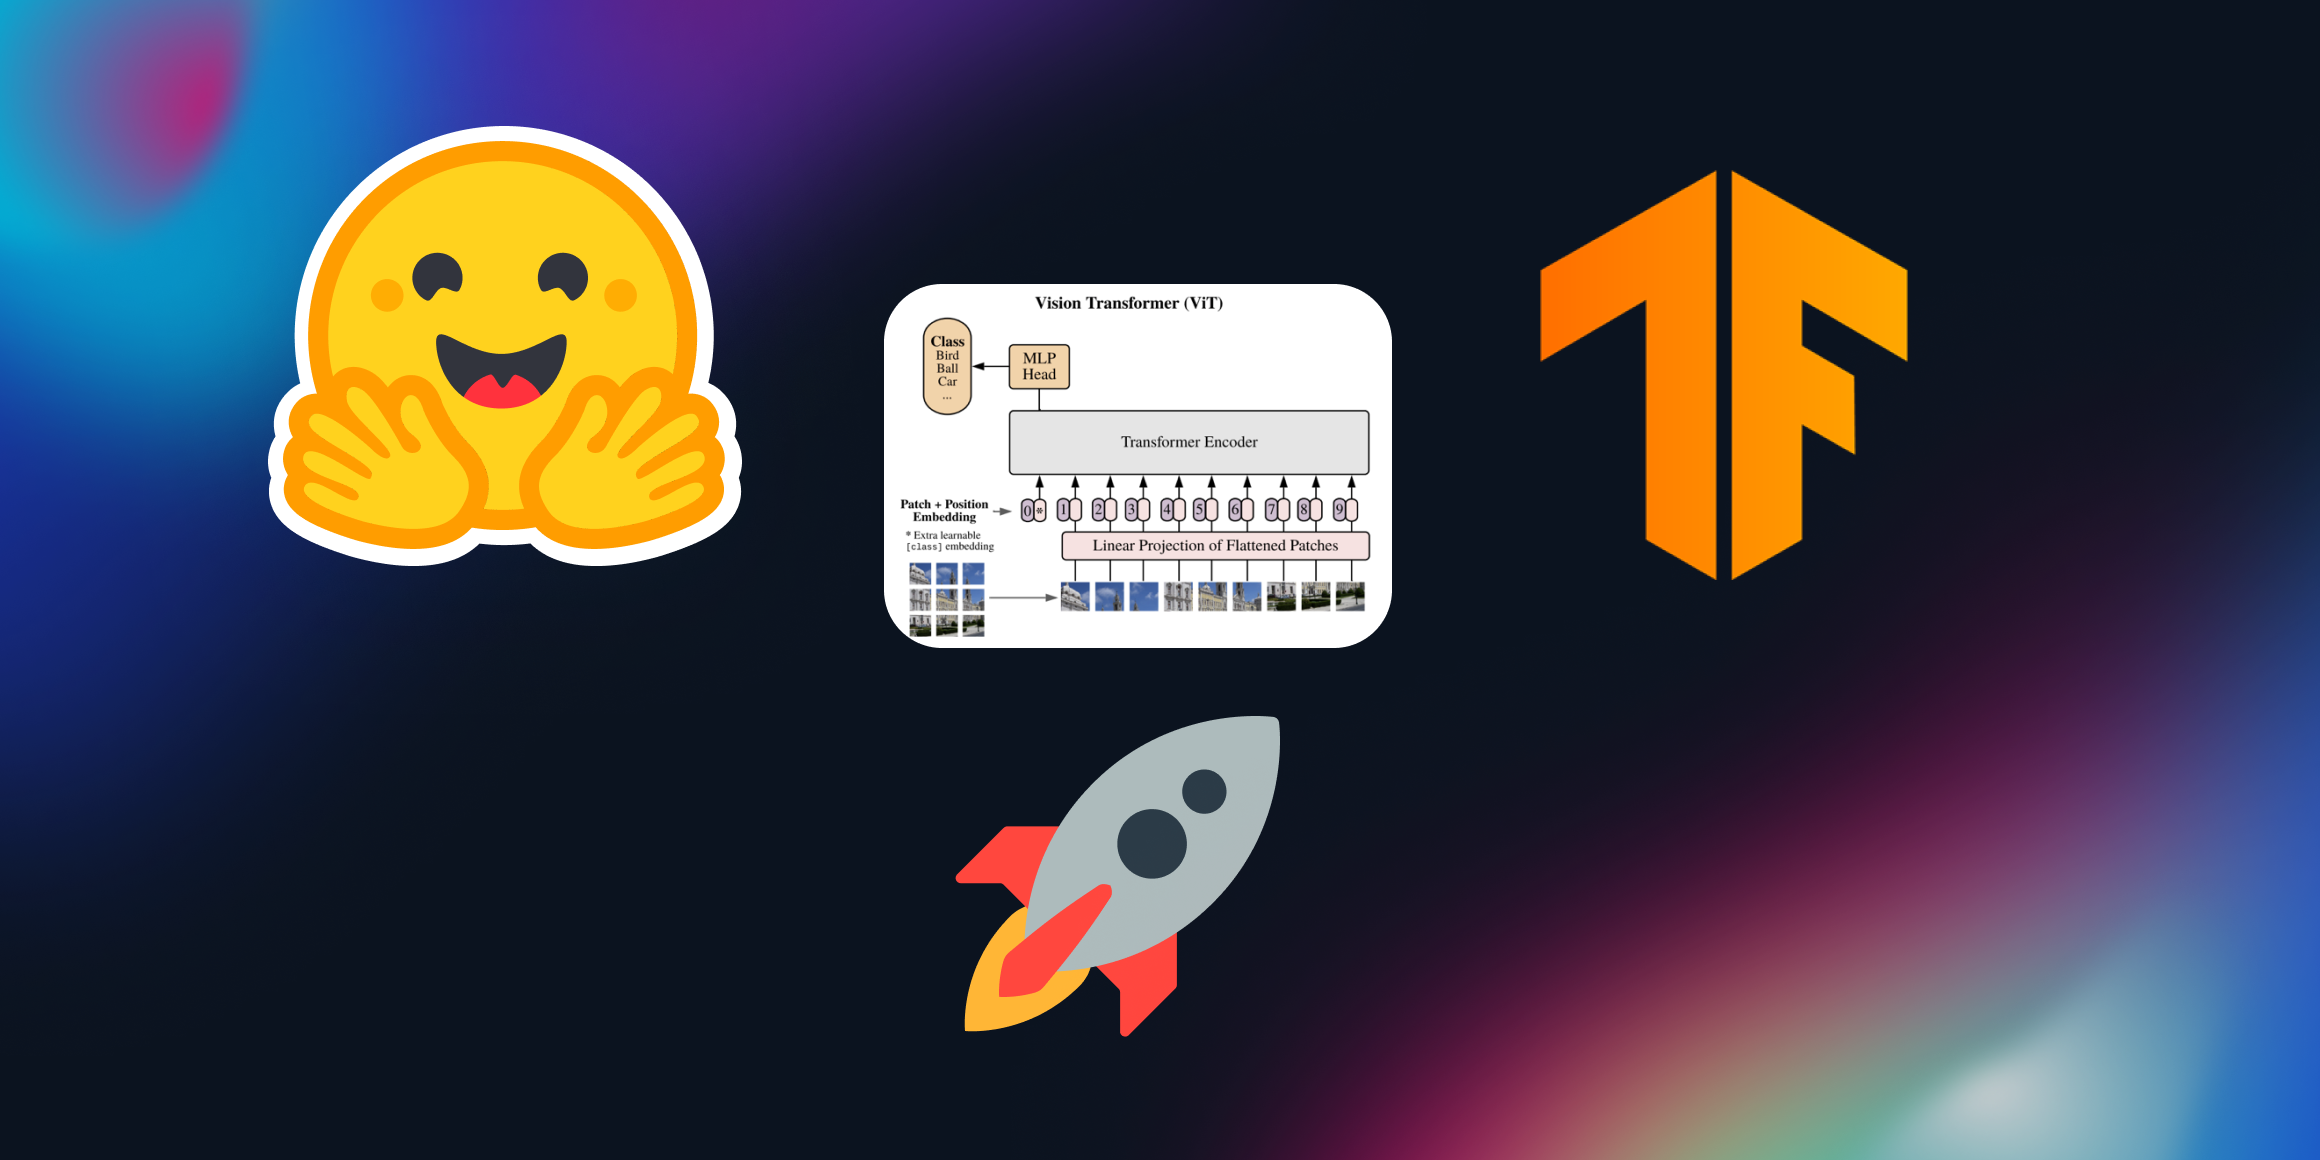
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.
Cloudflare Workers AI და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი გენერაციული AI დეველოპერებისთვის
Cloudflare Workers AI-ზე განთავსება დეველოპერებს საშუალებას აძლევს შექმნან მძლავრი გენერაციული AI აპლიკაციები GPU ინფრასტრუქტურისა და სერვერების მართვის გარეშე, ძალიან დაბალი საოპერაციო ხარჯებით. ეს ინტეგრაცია, რომელიც აფართოებს Cloudflare-ისა და Hugging Face-ის სტრატეგიულ პარტნიორობას, გვთავაზობს სერვერების გარეშე (serverless) წვდომას პოპულარულ Hugging Face მოდელებზე, მოთხოვნის მიხედვით გადახდის (pay-per-request) მოდელით, რითაც წყდება GPU-ს სიმცირისა და ფიქსირებული ხარჯების პრობლემა.

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ
DuckDB-NSQL-7B: ხელოვნური ინტელექტით SQL შეკითხვების გენერირება მონაცემთა ანალიზისთვის
დეველოპერები და ანალიტიკოსები სულ უფრო მეტად აფასებენ ხელოვნური ინტელექტის (AI) პოტენციალს მონაცემთა ანალიზის გასამარტივებლად. ტრადიციული SQL შეკითხვების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, თუმცა AI-ზე დაფუძნებული გადაწყვეტილებები, როგორიცაა MotherDuck-ისა და Numbers Station-ის DuckDB-NSQL-7B მოდელი, ამ პროცესს არა-დეველოპერებისთვისაც ხელმისაწვდომს ხდის. სტატია დეტალურად აღწერს, თუ როგორ შეუძლია ამ LLM-ს ბუნებრივი ენის გამოყენებით SQL ოპერატორების გენერირება, Hugging Face მონაცემთა ნაკრებებთა

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.

ხელოვნური ინტელექტი უჯრედის მოდელირებაში: გენის გაჩუმების ეფექტის პროგნოზირება CRISPR-ით
„ვირტუალური უჯრედის გამოწვევა“ მიზნად ისახავს ისეთი ხელოვნური ინტელექტის მოდელის შექმნას, რომელიც შეძლებს CRISPR-ის გამოყენებით გენის გაჩუმების შედეგად უჯრედზე მიღებული ეფექტების პროგნოზირებას, ფიზიკური, ძვირადღღირებული ექსპერიმენტების საჭიროების გარეშე. გამოწვევისთვის Arc-მა შეაგროვა 300 ათასი ერთუჯრედოვანი რნმ სეკვენირების პროფილის მონაცემთა ნაკრები. ამ პროცესში მნიშვნელოვანი სირთულეებია უჯრედის მდგომარეობის გაზომვის შეუძლებლობა ცვლილებამდე და მის შემდეგ, რაც მოითხოვს საკონტროლო უჯრედების გამო
AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას