Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ

Google-ის Gemma 2: ღია LLM-ების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
Google-მა წარმოადგინა Gemma 2, მისი ღია დიდი ენობრივი მოდელების (LLM) უახლესი ვერსია, ხელმისაწვდომი 9 და 27 მილიარდი პარამეტრის ზომებში. Gemma DeepMind Gemini-ზეა დაფუძნებული და გამოირჩევა მნიშვნელოვანი გაუმჯობესებებით, მათ შორის გაორმაგებული საწვრთნელი მონაცემებით (13 ტრილიონი ტოკენი 27B ვერსიისთვის), ოპტიმიზებული დიალოგური აპლიკაციებისთვის და ახალი არქიტექტურული ინოვაციებით, როგორიცაა ჰიბრიდული მოძრავი ფანჯრის ყურადღება (sliding window attention) და რბილი ზღვრის დადგენა (soft capping). მოდელი
Hugging Face-ი მანქანური სწავლების მოდელების დოკუმენტაციის გასაუმჯობესებლად ახალ ხელსაწყოებსა და სახელმძღვანელოს უშვებს
Hugging Face-ი აქვეყნებს მოდელის ბარათის შექმნის ხელსაწყოსა და სახელმძღვანელოს, რაც მიზნად ისახავს მანქანური სწავლების (ML) მოდელების დოკუმენტაციის გამარტივებას, სტანდარტიზაციასა და გაუმჯობესებას. ეს ინიციატივა ხელს შეუწყობს სხვადასხვა წარმომავლობისა და როლის მქონე მომხმარებლების ჩართულობას, მათ შორის დეველოპერების, სტუდენტების, პოლიტიკოსების, ეთიკოსების და მათ, ვისზეც ML მოდელები გავლენას ახდენენ. პროექტი მოიცავს პროგრამირების გარეშე ბარათების შექმნის საშუალებას, განახლებულ შაბლონს და დეტალურ ი
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ
CLIPSeg: რევოლუციური ხელოვნური ინტელექტი, რომელიც ნებისმიერი ობიექტის სეგმენტაციას დამატებითი წვრთნის გარეშე ახდენს
სტატია განიხილავს გამოსახულების სეგმენტაციას, მის არსებულ შეზღუდვებს (ფიქსირებული კატეგორიები, წვრთნის მაღალი ღირებულება) და წარმოგიდგენთ CLIPSeg-ს. CLIPSeg არის "ნულოვანი-კადრის" (zero-shot) სეგმენტაციის მოდელი, რომელიც OpenAI-ის CLIP-ზეა დაფუძნებული და შეუძლია თითქმის ნებისმიერი ობიექტის სეგმენტაცია დამატებითი წვრთნის გარეშე. ის იყენებს CLIP-ის უნარს, შექმნას გამოსახულებებისა და ტექსტის აბსტრაქტული წარმოდგენები, ტრანსფორმატორზე დაფუძნებული დეკოდერის დახმარებით სეგმენტაციის ნიღბების შესაქმნელად
CLIPSeg: რევოლუციური „ნულოვანი კადრის“ სეგმენტაცია, რომელიც ცვლის კომპიუტერულ ხედვას
გამოსახულების სეგმენტაცია კომპიუტერული ხედვის მნიშვნელოვანი ამოცანაა, რომელიც ობიექტების კონტურების ამოცნობას უზრუნველყოფს. ტრადიციული მოდელების შეზღუდვა ისაა, რომ ისინი მხოლოდ ფიქსირებულ კატეგორიებთან მუშაობენ და ახალი ობიექტების დასამატებლად ხელახალ ვარჯიშს საჭიროებენ. CLIPSeg, „ნულოვანი კადრის“ სეგმენტაციის ინოვაციური მოდელი, ამ პრობლემას წყვეტს. ის CLIP-ის მძლავრი შესაძლებლობების გამოყენებით საშუალებას იძლევა თითქმის ნებისმიერი ობიექტის სეგმენტაცია მოხდეს დამატებითი ვარჯიშის გარეშე, რაც დროს

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც
თამაშების დიზაინი AI-ის დახმარებით: Stable Diffusion და Unity
ეს სტატია გთავაზობთ სახელმძღვანელოს, თუ როგორ გამოვიყენოთ Stable Diffusion ხელოვნური ინტელექტის მოდელი, რათა შევქმნათ უნიკალური ვიზუალური სტილი ჩვენი თამაშისთვის, კერძოდ კი სოფლის მეურნეობის სიმულატორისთვის Unity-ში. განხილულია Stable Diffusion-ის ლოკალურად ან ონლაინ გაშვების მეთოდები, პრომპტინგის რჩევები და საბოლოოდ, კონცეპტუალური ხელოვნების ინტეგრაცია Unity-ში.

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ
სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა
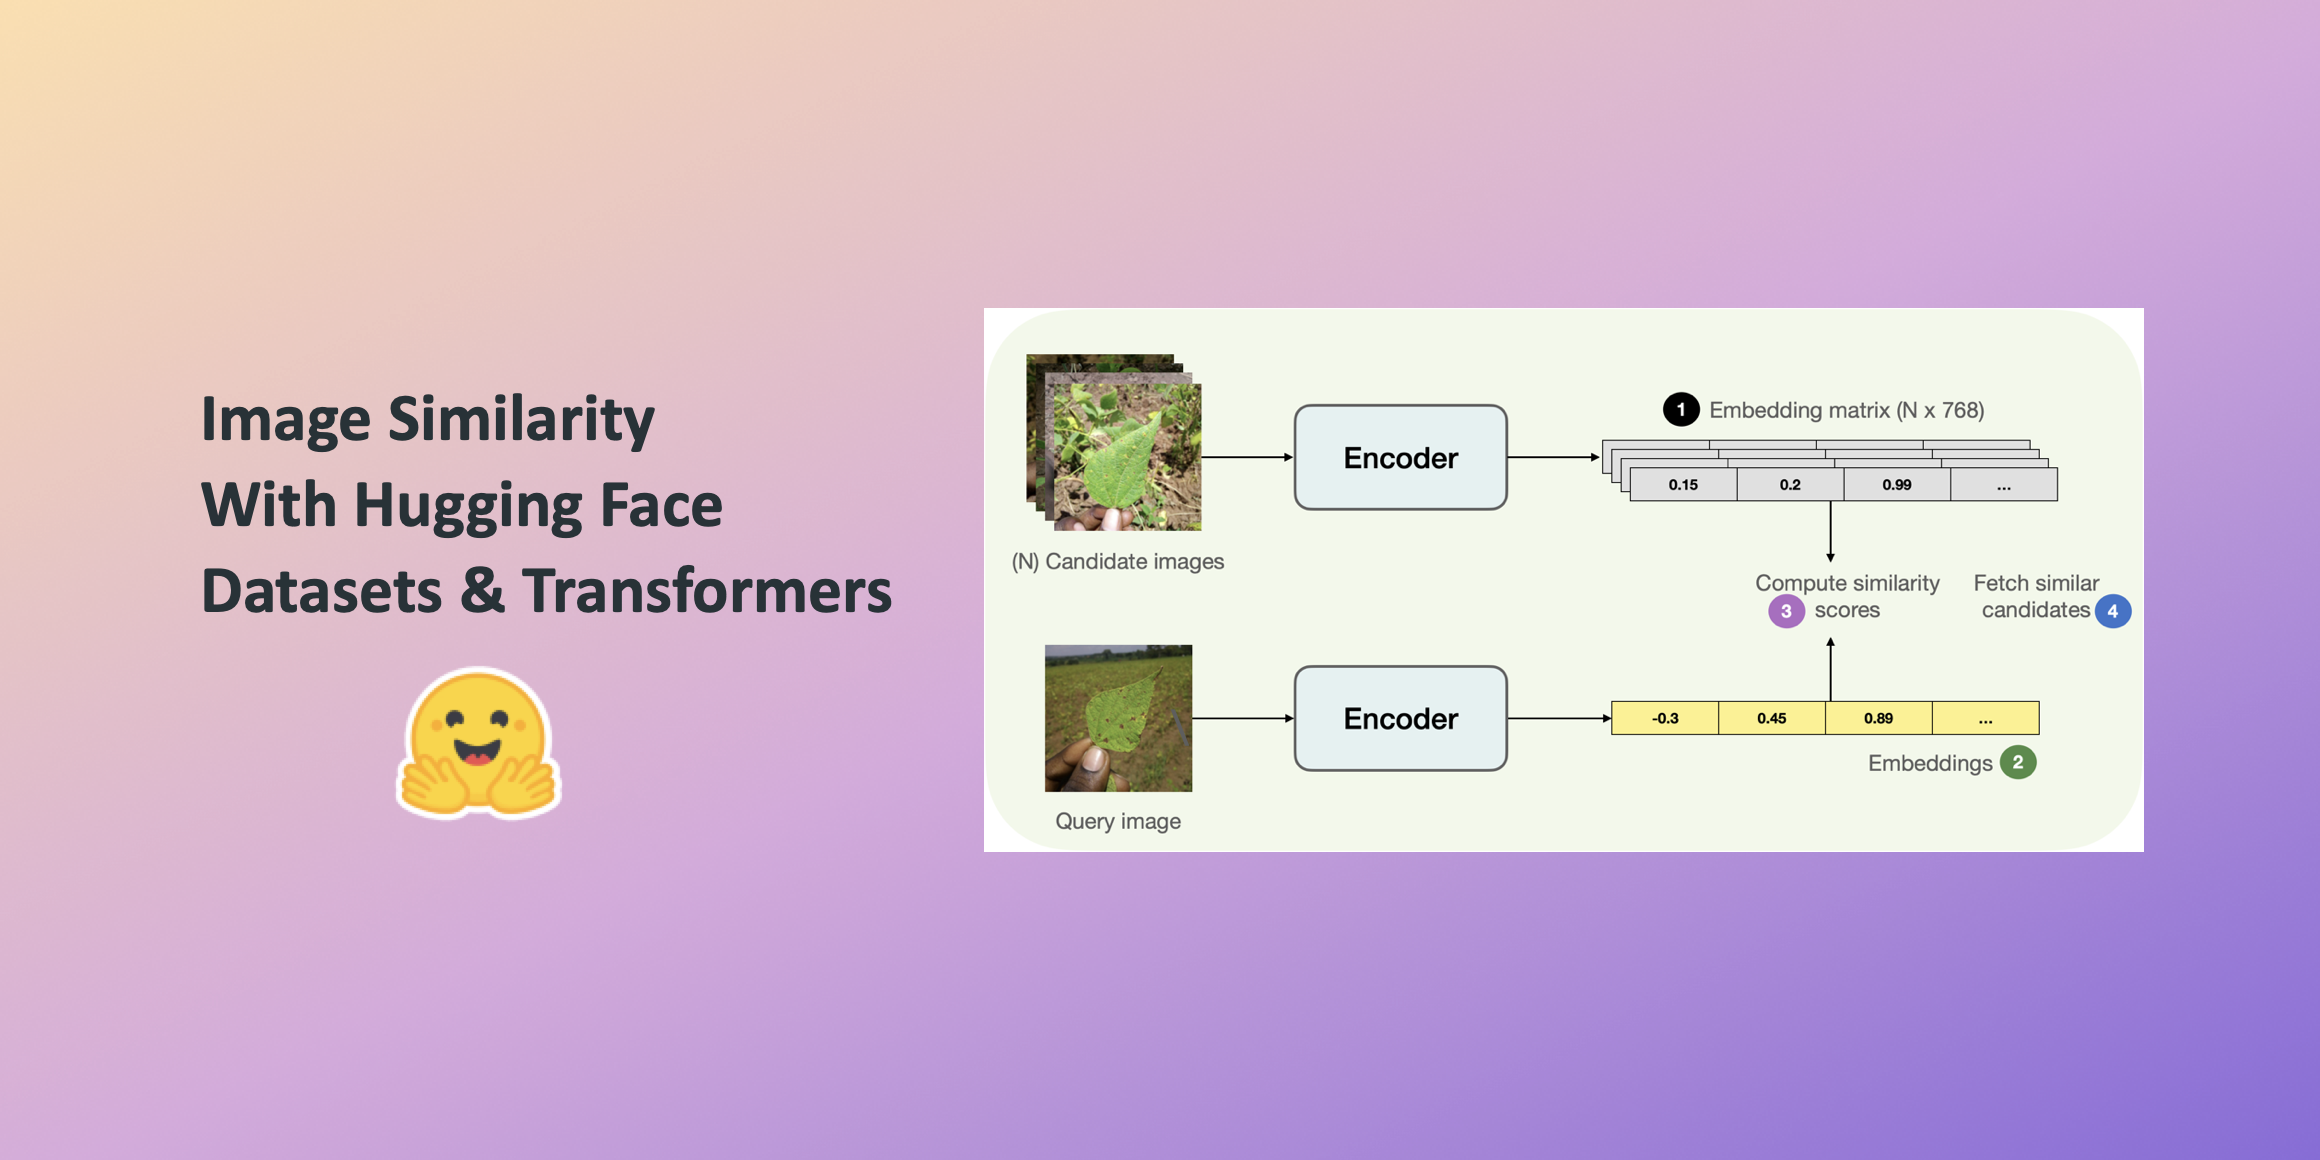
როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal

ყინულის გამოწვევა: როგორ გავიაროთ მოლიპულ ზედაპირზე? ფიზიკის კანონები მოძრაობაში
სტატია იკვლევს უჩვეულო გამოწვევას: ყინულისგან გამოკვეთილი თასიდან თავის დაღწევას. ის სიღრმისეულად განმარტავს სიარულის ფიზიკას, განსაკუთრებით მოლიპულ ზედაპირებზე, როგორიცაა ყინული. განხილულია ნიუტონის კანონები, ხახუნისა და ნორმალური ძალის როლი, და ისიც კი, თუ რატომ არის ყინული მოლიპული. მოცემულია მოძრაობის მოდელირების მეთოდები და ხახუნის სხვადასხვა ტიპები, რათა ავხსნათ, თუ რატომ არის ყინულზე, განსაკუთრებით აღმართზე სიარული ასეთი რთული.
Google-მა ხელოვნური ინტელექტის ახალი ეპოქა Gemini 3-ითა და Antigravity-ით განსაზღვრა
Google-მა ერთდროულად წარადგინა თავისი ყველაზე ინტელექტუალური ხელოვნური ინტელექტის მოდელი Gemini 3 და პიონერული აგენტური განვითარების პლატფორმა Google Antigravity. ეს ინოვაციები ფუნდამენტურად შეცვლის მომხმარებლის AI-სთან ურთიერთობას, კომპლექსური ამოცანების შესრულებისას – სწავლიდან კოდირებამდე და სამუშაო პროცესების მართვამდე – და Google-ს ხელოვნურ ზოგად ინტელექტთან (AGI) მიაახლოებს.
MIT-ის რევოლუციური სისტემა: სიტყვიდან ფიზიკურ ობიექტამდე წუთებში
MIT-ის მკვლევრებმა შეიმუშავეს „მეტყველებიდან რეალობამდე“ (Speech-to-Reality) პლატფორმა, რომელსაც შეუძლია მეტყველების ბრძანებების ფიზიკურ ობიექტებად გადაქცევა სულ რამდენიმე წუთში. ეს ინოვაციური სისტემა აერთიანებს ბუნებრივი ენის დამუშავებას, 3D გენერაციულ ხელოვნურ ინტელექტს, გეომეტრიულ ანალიზს და რობოტულ აწყობას, რაც მომხმარებლებს საშუალებას აძლევს შექმნან ავეჯი, ფუნქციური და დეკორატიული ნივთები 3D მოდელირების ან რობოტიკის ექსპერტიზის გარეშე. სისტემა მნიშვნელოვნად აბუნდოვნებს მეცნიერულ ფანტასტიკას
ხელოვნური ინტელექტი 2026: ექსპერიმენტული ინსტრუმენტიდან საწარმოს ხერხემალამდე
2026 წელს ხელოვნური ინტელექტი ექსპერიმენტული ტექნოლოგიიდან გადაინაცვლებს საწარმოთა, კრეატიული ინდუსტრიებისა და მომხმარებლის გამოცდილების სტრატეგიულ ხერხემალში. აქცენტი გადავა მასშტაბიდან ეფექტურობასა და კონტექსტის მცოდნე სისტემებზე, რასაც ხელს შეუწყობს „მოაზროვნე მოდელების“ და მოდელის კონტექსტის პროტოკოლის (MCP) აღზევება. ხი გახდება ნამდვილი თანამშრომელი, რომელსაც შეუძლია გადაწყვეტილებების მიღება და მულტიმოდალური გაგება, ხოლო ღია კოდის მოდელები გააგრძელებენ კონკურენტული ლანდშაფტის ფორმირებას. ნდ

Google Veo 3.1: AI ულტრარეალისტურ დრონის ფრენებს წუთებში ქმნის
Google-ის უახლესმა გენერაციულმა AI ვიდეო მოდელმა, Veo 3.1-მა, შექმნა 1 წუთი და 40 წამიანი FPV დრონის ფრენის ვიდეო მთის ხეობებში სულ რაღაც 15 წუთში. ეს მოდელი გამოირჩევა გაუმჯობესებული რეალიზმით, სიგრძითა და დეტალების კონტროლით, რაც საშუალებას იძლევა შეიქმნას კინემატოგრაფიული ხარისხის კონტენტი. Veo 3.1-ის ფუნქციები, როგორიცაა Flow-based SceneBuilder და Frames to Video, მნიშვნელოვნად ამარტივებს ვიდეოს შექმნას და მონტაჟს, რაც მაღალი ხარისხის საჰაერო კინემატოგრაფიას ხელმისაწვდომს ხდის ყველასთვის, პრ

Gemini 3 Pro: ხელოვნური ინტელექტის ახალი პარტნიორობის ერა
Google-მა წარმოადგინა ახალი ხელოვნური ინტელექტის მოდელი, Gemini 3 Pro, რომელიც აღნიშნავს ხელოვნური ინტელექტის განვითარების ახალ ერას – ხაზოვანი გაუმჯობესებიდან ექსპონენციურ შესაძლებლობებზე გადასვლას. Gemini 3 Pro აღწერილია, როგორც კოგნიტური ძრავა, რომელსაც შეუძლია არა მხოლოდ დამუშავება და ჩეთი, არამედ აზროვნება და მოქმედება, რთული პრობლემების გადაჭრის მიზნით. მისი ძირითადი მახასიათებლები მოიცავს „სისტემა 2“-ის აზროვნებას, ნატიურ მულტიმოდალურობას, გაფართოებულ „სააგენტოს“ (Agency) ფუნქციებს გარე ი
Gemini 3 Pro: ხელოვნური ინტელექტის ახალი ერა – ჩეთბოტიდან კოგნიტურ ძრავამდე
Google-ის ახალი AI მოდელი, Gemini 3 Pro, წარმოგვიდგენს ხელოვნური ინტელექტის განვითარების რევოლუციურ ეტაპს. ის აღარ არის უბრალო ჩეთბოტი, არამედ კოგნიტური ძრავა, რომელიც შექმნილია აზროვნებისთვის, მრავალმხრივი მოქმედებისთვის და კომპლექსური პრობლემების გადასაჭრელად. მოდელი გამოირჩევა გაუმჯობესებული მსჯელობის უნარით, მშობლიური მულტიმოდალურობით (ტექსტი, ვიდეო, აუდიო, ვიზუალი), დამოუკიდებელი მოქმედების (Agency) შესაძლებლობით, გაფართოებული კონტექსტური მეხსიერებით და უსაფრთხოების ახალი მექანიზმებით.
MIT-ის ახალი მიდგომა: მცირე ენის მოდელები ერთობლივი მუშაობით დიდებს ჯობნიან
მიუხედავად იმისა, რომ ენის მოდელები (LMs) უმჯობესდებიან სხვადასხვა ამოცანებში, მათ მაინც უჭირთ რთული და მკაცრი წესების მქონე მოთხოვნების შესრულება. ამ პრობლემის გადასაჭრელად, MIT-ის მკვლევრებმა შეიმუშავეს „DisCIPL“ – თანამშრომლობითი მიდგომა, სადაც დიდი ენის მოდელი (LLM) გეგმავს ამოცანას, შემდეგ კი მის შესრულებას მცირე მოდელებს ანაწილებს. ეს მეთოდი მცირე ენის მოდელებს საშუალებას აძლევს, მიაწოდონ უფრო ზუსტი და ეფექტური პასუხები, ვიდრე წამყვან LLM-ებს, როგორიცაა GPT-4o, და მიუახლოვდნენ მაღალი დონის
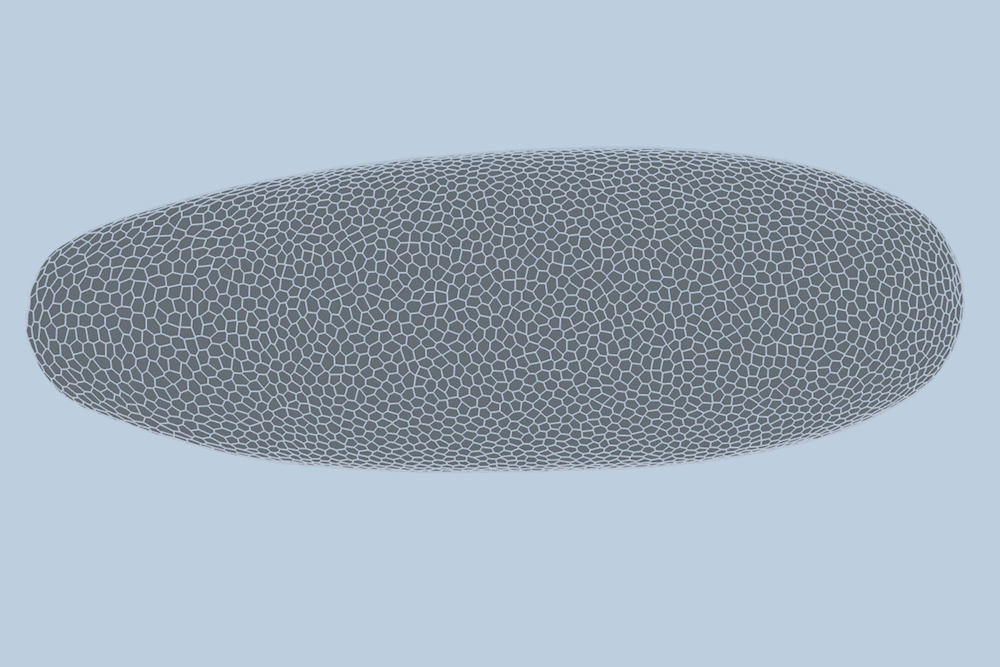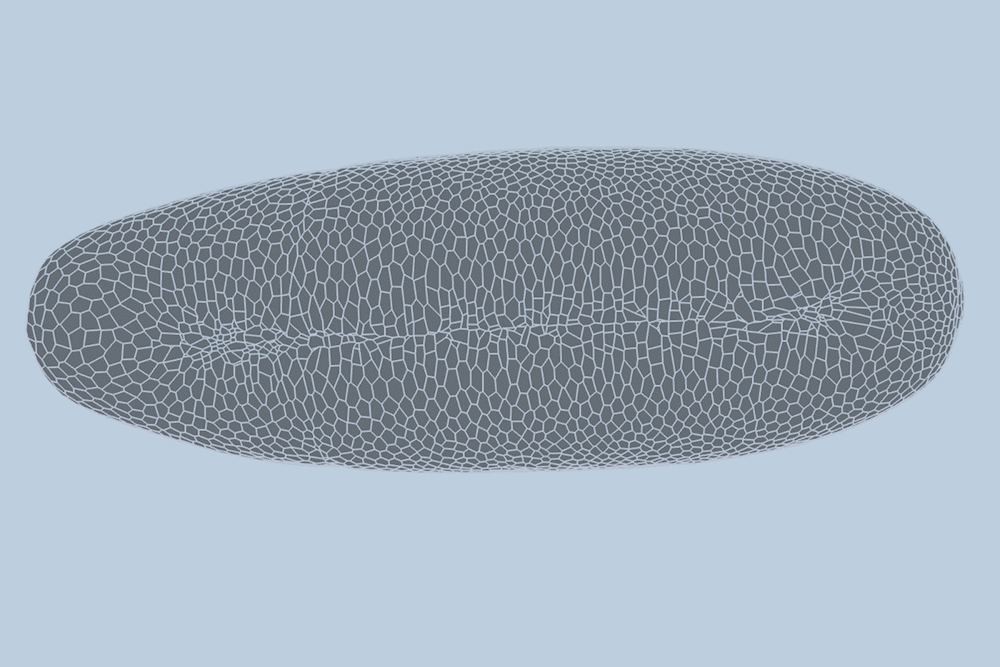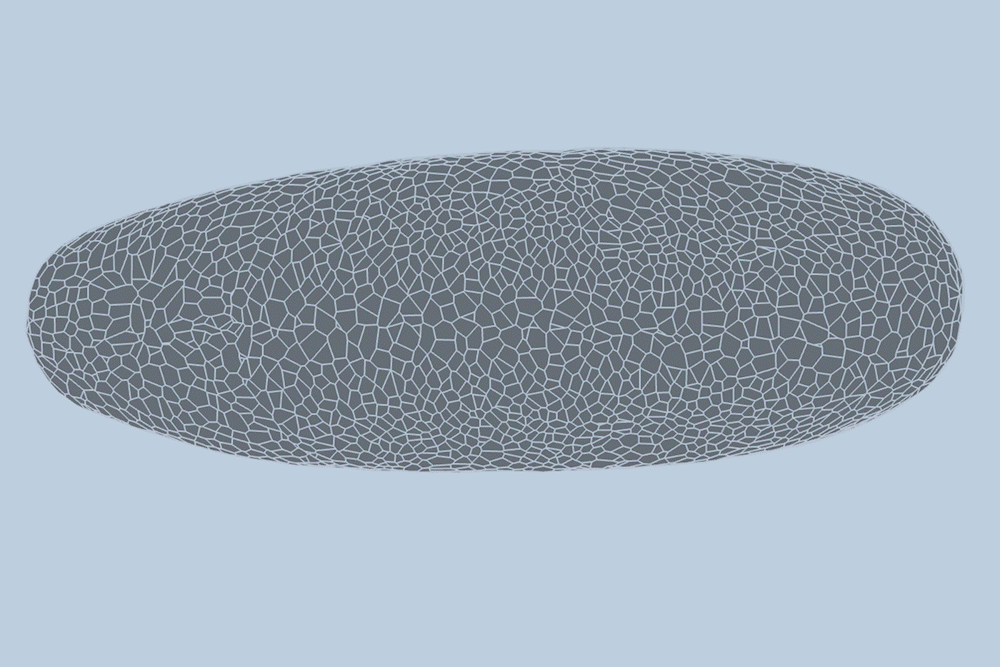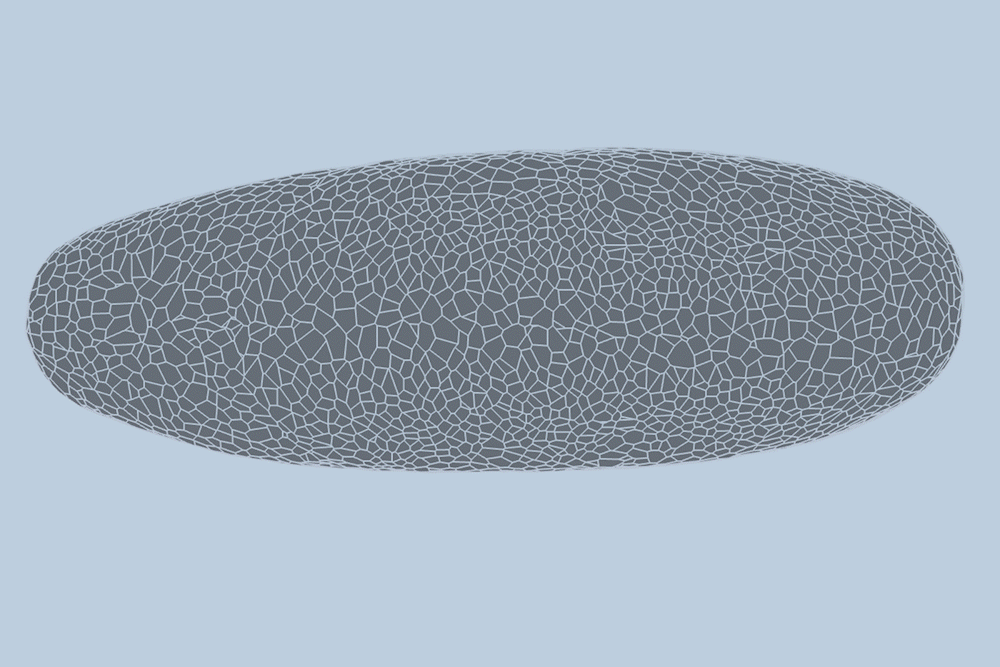
MIT-ის მეცნიერებმა შეიმუშავეს მოდელი, რომელიც ხილის ბუზის უჯრედების განვითარებას წუთობრივად წინასწარმეტყველებს
MIT-ის ინჟინრებმა შექმნეს ღრმა სწავლის მოდელი, რომელსაც შეუძლია ხილის ბუზის ემბრიონის უჯრედების განვითარების პროგნოზირება 90%-იანი სიზუსტით. ეს მეთოდი გასტრულაციის ფაზაში უჯრედების გადაადგილებას, გაყოფასა და გადალაგებას წუთობრივად აკონტროლებს, რაც პერსპექტივას ქმნის უფრო რთული ქსოვილების განვითარების შესასწავლად და ისეთი დაავადებების ადრეული ნიშნების გამოსავლენად, როგორიცაა ასთმა და კიბო.